0. 模型学会回答后,怎样让回答更合适
语言模型虽然能续写文本,回答却未必符合任务要求。SFT(Supervised Fine-Tuning)用示范答案教模型怎么完成任务;偏好学习进一步比较同一个问题的不同回答,告诉模型哪一种更合适。
下文依次介绍 SFT → 奖励模型与 KL → token 级 PPO → DPO。RLHF(Reinforcement Learning from Human Feedback)是一套利用人类反馈的训练流程;PPO 是其中可以采用的策略优化算法,DPO 则是直接用偏好对训练模型的方法。本文会分别说明它们用什么数据、训练哪个模型,以及怎样计算损失。
先把整条路线连起来:
| 阶段 | 数据从哪里来 | 训练或计算什么 | 得到什么 |
|---|---|---|---|
| SFT | 人写的示范回答 | 让语言模型学习回答 | 一个能按示范回答的初始策略 |
| 收集偏好 | 对同一问题生成多条回答,由人比较 | 标记哪条回答更好 | 偏好数据,例如「A 优于 B」 |
| 训练奖励模型 | 上面的偏好数据 | 学习给问题和完整回答打分 | 能为新回答打分的奖励模型 |
| PPO | 当前策略新生成的回答 | 奖励模型评分,结合参考模型和 Critic 更新策略 | 经过偏好优化的语言模型 |
| DPO | 已收集的偏好数据 | 直接比较策略与参考模型对好、坏回答的概率 | 另一种偏好优化后的语言模型 |
PPO 和 DPO 是这里要比较的两条路线,不需要先跑完 PPO 才能做 DPO。下文会用一条假设的偏好数据贯穿例子:先看奖励模型怎样学到分数,再看 PPO 怎样使用分数,最后看 DPO 怎样直接使用同一类偏好数据。第 1.1 节的代码可以先跳过,需要实现时再回来读。
第 1 节先用下一 token 的概率解释训练损失,再进入偏好学习;推导涉及条件概率、反向传播与梯度下降。本文着重说明 PPO 如何用于语言模型的回答,以及 DPO 如何利用偏好数据;通用强化学习 则从一般的状态、动作和奖励出发,推导 Policy Gradient、value function 和 GAE,是选读而不是学习 SFT 的必修课。数据整理、LoRA、packing 与训练显存问题见 SFT 训练实战;整体顺序见 LLM 知识体系导航。
下面统一用 表示 prompt, 表示回答 token 序列, 表示参数为 的语言模型,所有 均为自然对数。回答包含按数据约定计入的结束 token;padding 不是回答的一部分。
1. 从单个 token 的概率算到整条回答
先看 token 概率如何决定训练损失。模型在每个位置为词表中的候选输出 logits;softmax 把它们变为和为 1 的概率。若示范要求下一个 token 是「蓝」,模型给它的概率是 ,这一步的损失就是 ;概率提高到 ,损失变成约 。反向传播计算哪些参数影响这个损失,梯度下降据此调整参数。SFT 并不要求模型先自由生成出正确答案:训练时把示范前缀送入,逐位置预测其下一个 token,这称为 teacher forcing。
SFT 的数据格式、token 平均损失、attention mask 与 loss mask 见 SFT 数据与损失范围。这里讨论偏好学习接下来需要的计算:怎样得到整条回答的概率。
令 为 prompt, 为包含约定结束 token 的回答,则
下面采用 response-only 计分:prompt 仍作为输入,padding 不属于回答。
例如回答有两个 token,模型给出的条件概率分别是 和 ,整条回答概率为 ,log-probability 为 。第二个概率的条件已包含第一个 token;不是把两个无条件概率相乘。使用 log 是因为长回答的概率乘积非常小,而取 log 后可以稳定地做加法。
SFT 用示范答案训练;DPO 则要比较 chosen/rejected 两条回答在当前模型和参考模型下的分数,所以需要保留逐 token log-probability 与有效位置 mask。
1.1 从 logits 计算目标 token 的对数概率
假设一个 batch 有 条样本,每条拼接后的 prompt 与回答补齐到长度 ,logits 形状为 ,labels 为 , 是词表大小。labels 中 prompt 和 padding 设为 -100,回答位置保留 token ID。位置 的 logits 预测位置 的 label,必须错开一位:
import torchimport torch.nn.functional as F
def response_token_logps(logits, labels): # logits: [B, L, V]; labels: [B, L] targets = labels[:, 1:] mask = targets.ne(-100) safe_targets = targets.masked_fill(~mask, 0) logps = F.log_softmax(logits[:, :-1, :].float(), dim=-1) selected = logps.gather(-1, safe_targets.unsqueeze(-1)).squeeze(-1) return selected.masked_fill(~mask, 0.0), mask输出均为 。-100 不能直接用于 gather;先替换为合法 ID,取出后再置零。模型前向仍要传入正确的 attention mask,输入 token ID 也不能换成 -100。至少提供一个可用于预测首个回答 token 的 prompt/BOS 位置,并检查截断后每条样本仍有回答。
对输出在有效回答位置求和,得到每条回答的 ;求均值则是另一种长度归一化分数。后面的原始 DPO 目标使用求和,不能改成均值。PPO 则保留每个 token 的 log-probability。
2. 奖励模型与 KL 正则
2.1 用两条回答的偏好训练奖励模型
从这里开始, 表示按数据分布抽取样本后求平均;训练代码通常用一个 batch 的均值近似它。下标 表示要改进的语言模型参数, 表示奖励模型参数,后文的 表示 critic 参数,三个下标分别对应不同模型的权重。
偏好数据写成 :在同一个 prompt 下,标注者更喜欢 (chosen),相对不喜欢 (rejected)。偏好依据应由任务标准决定,例如正确性、相关性和表达要求。仅凭语言是否自然,还不足以作出这些判断。
例如,问题 是「用一句话解释雨是怎么形成的」,模型给出两条回答:
- 回答 A:水汽遇冷凝结成水滴,水滴变大后落下来。
- 回答 B:云掉下来就是雨。
假设标注者根据解释是否准确、是否回答了问题,选择 A 优于 B,那么这条训练数据就是 。人只提供了相对偏好,并没有给 A 打 2 分、给 B 打 1 分。训练时,奖励模型分别读入问题和一条完整回答,输出一个标量;模型参数起初决定分数,再由许多这样的偏好对逐步调整,让被选中的回答通常比落选回答得分更高。上面的内容和下面的数字都是教学示例,不是实际标注记录或模型测量结果。
奖励模型 给整条回答打一个分数。怎样把两个分数和「A 优于 B」这条标注联系起来?一种做法是采用 Bradley–Terry 偏好模型,把分数差转成偏好概率:
奖励差越大,模型认为 chosen 胜出的概率越高,loss 越低。两个分数相等时,一对样本的 loss 为 。给同一 prompt 的所有回答同时加一个常数,不改变偏好概率,因此这些分数不是天然可跨题比较的“百分制成绩”。实现时用 -F.logsigmoid(chosen_reward - rejected_reward).mean(),避免先算 sigmoid 再取 log 的数值问题。
继续上面的例子,假设奖励模型此时给 A 打 2、给 B 打 1,分数差为 1。代入公式,模型给「A 优于 B」的概率是 ,这条偏好数据的损失是 。如果两条回答分数相同,模型给出的偏好概率就是 0.5,损失约为 0.693。训练在许多偏好对上降低这个损失,调整的是奖励模型参数 ;它学习的是比较关系,并不是人已经给出的绝对分数。
这个损失怎样推动模型学习?暂时把 A、B 的分数看作两个独立变量,对一条数据求导:
沿负梯度方向,前者倾向于提高 A 的分数,后者倾向于降低 B 的分数,让 A 相对 B 更靠前。实际训练更新的是两次前向共享的模型参数,而不是直接修改两个独立分数;一批中的其他样本也会共同影响更新,所以不能保证每次更新都会按这个方向改变每一条回答的绝对分数。
一种常见实现是在 Transformer 的序列表示上接一个输出标量的预测头(scalar head)。奖励模型对完整回答评分,value model 则估计某个前缀之后的未来回报;即使网络结构相似,这两个角色也不同。经典 SFT、偏好标注、奖励学习、PPO 的阶段划分可参阅 InstructGPT 原论文 §3.1。
奖励模型训练好后,就可以对人还没有逐条标注的新回答打分:给它一个问题和完整回答,前向计算得到 。PPO 会使用这个分数作为训练信号;奖励模型在本文讨论的 PPO 阶段保持冻结,不会因为策略更新就自动变得更准确。它可能学到标注偏差,也可能给错误答案高分,因此高奖励不等于回答一定正确。
2.2 为什么还需要固定参考模型
如果只追求奖励模型的高分,策略可能利用评分器的盲点,例如堆砌看起来专业却没有帮助的内容。KL 正则给模型偏离参考行为增加代价。令 为冻结的参考模型,通常取 SFT 检查点,考虑
这里 是 prompt 分布。KL 方向是当前策略相对参考策略,期望也在当前策略下:
只要策略给某个回答正概率,参考模型也应给它正概率,否则这一方向的 KL 会无穷大。更多边界条件见 KL 散度。
利用自回归分解,可以把一条回答的 log-ratio 写成各个 token 的 log-ratio 之和。单个采样 token,甚至整条回答的 log-ratio 都可能是负数;保证非负的是完整分布下的 KL 期望。因此,不能把某次采样得到的负数称为“负 KL 散度”。
在奖励函数和标度固定时,较大的 意味着偏离参考分布的代价更高。KL 可以缓和过度优化,但不保证消除 reward hacking、事实错误或偏好数据偏差。
3. PPO 的 token 级策略更新
3.1 策略、参考模型、奖励模型与 Critic
先沿图追踪同一条生成回答,再区分各模型的职责。下面采用 RLHF Book 中已明确标出参考模型概率计算的版本,并补上中文定位标注。
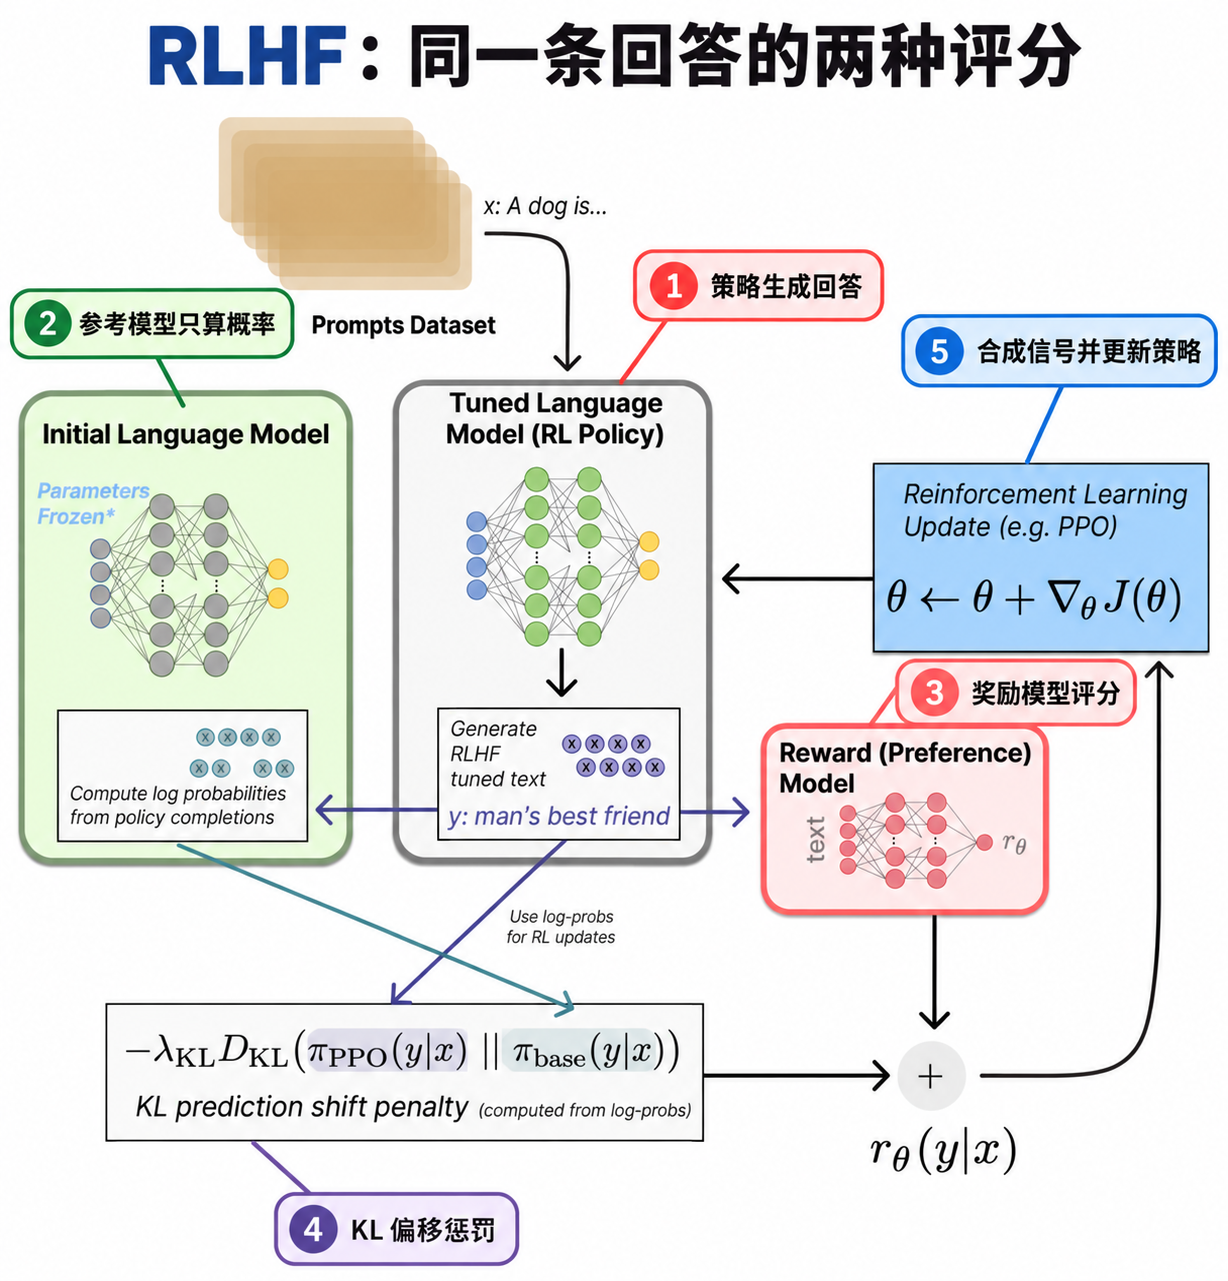
来源:Nathan Lambert,RLHF Book:Policy Gradients,基于 Hugging Face RLHF 教程的修订图;未改动原图。本图添加中文定位标注,按 CC BY-NC-SA 4.0共享。
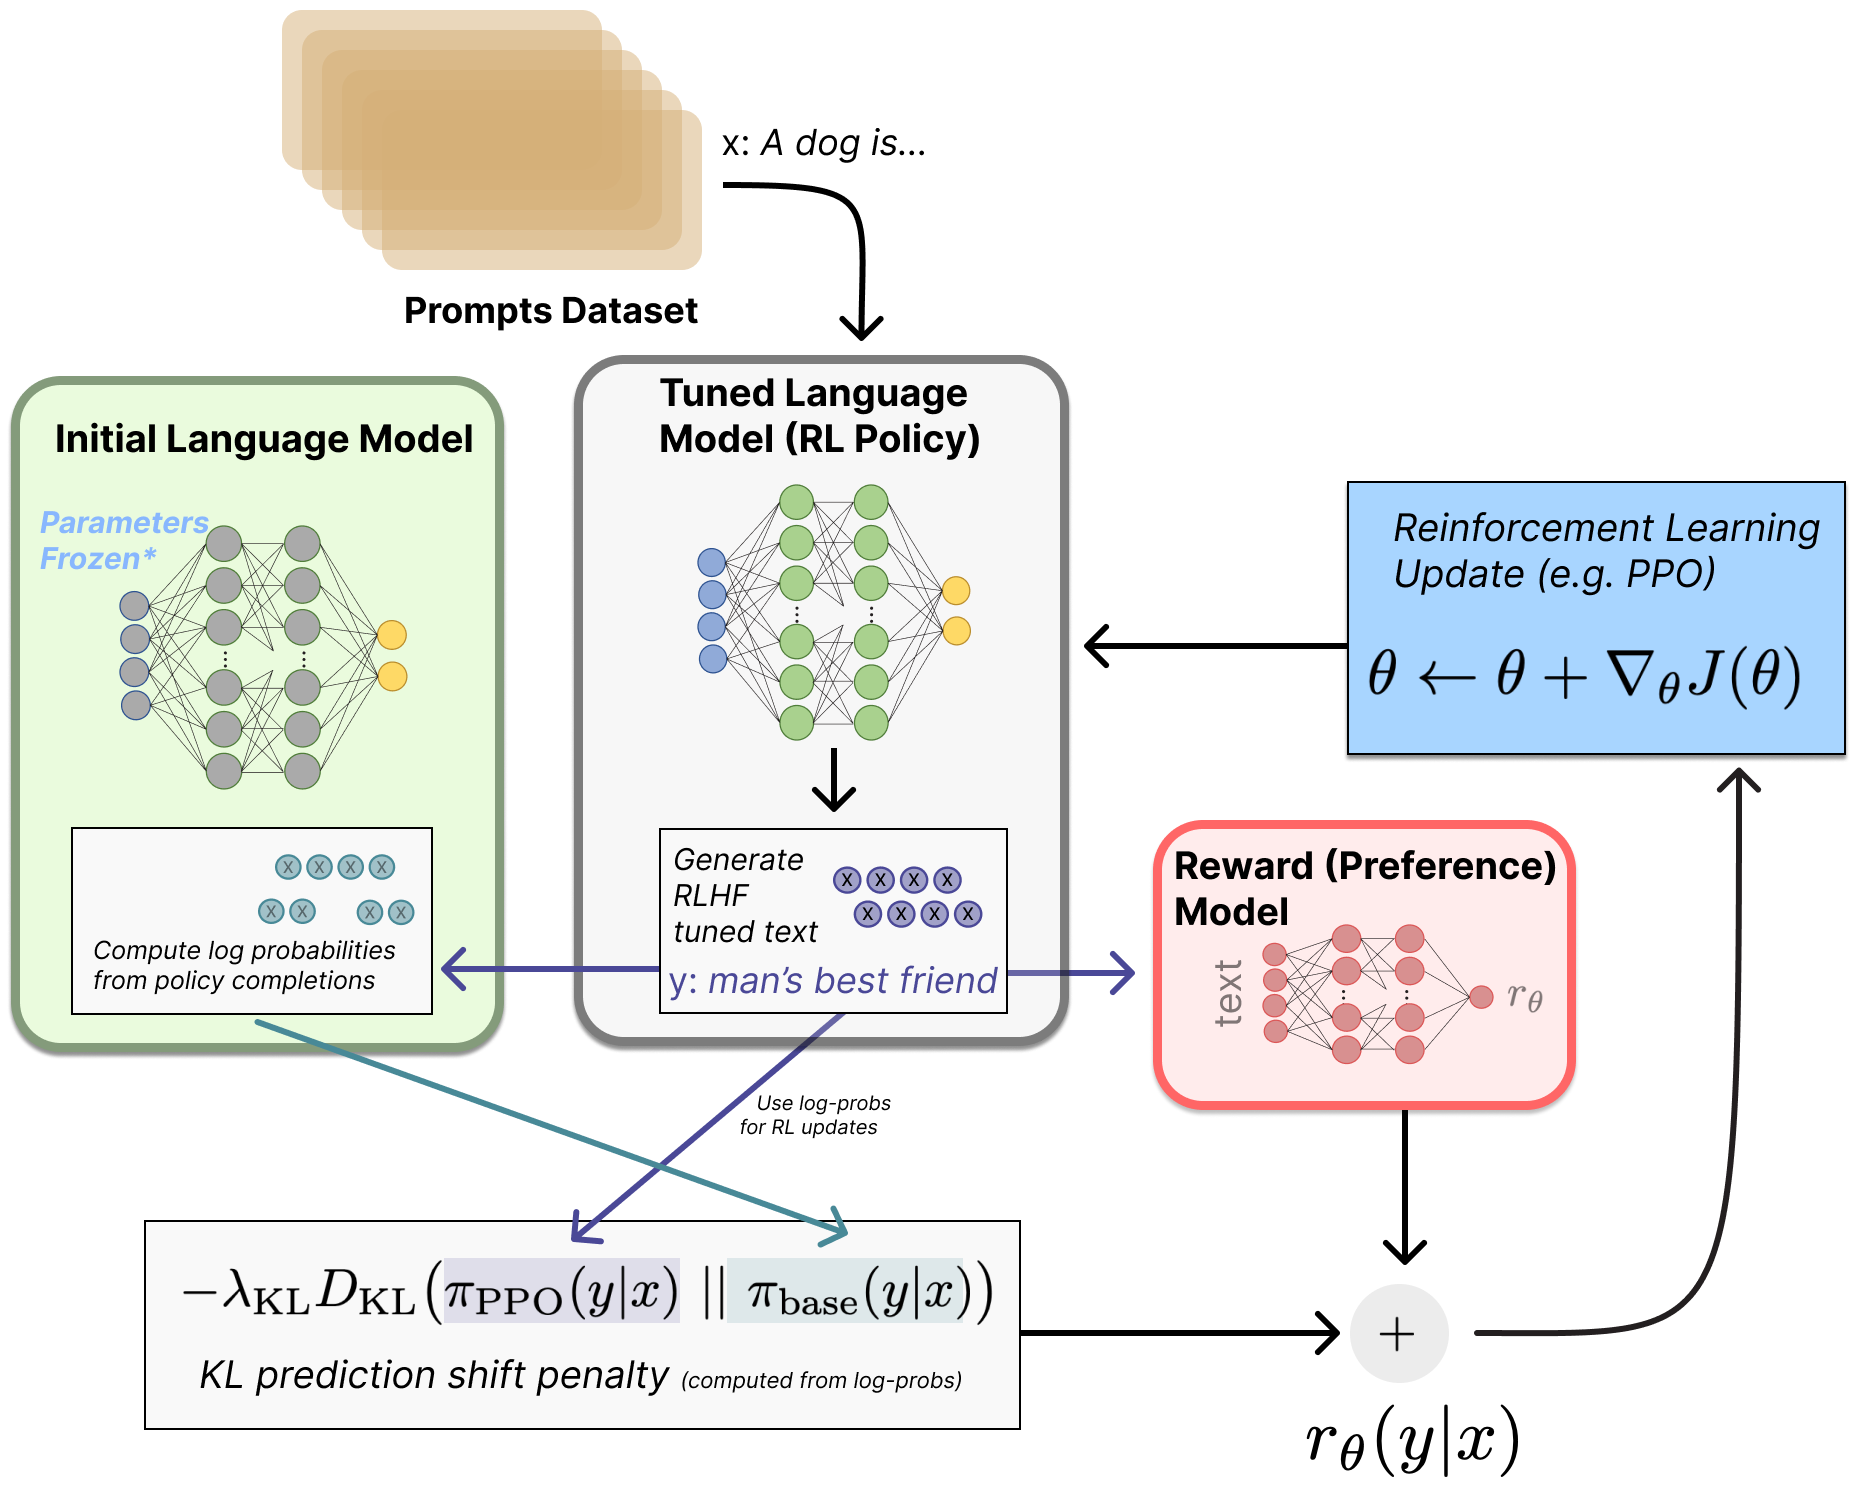
- ① 策略生成回答:中间模型根据问题采样一条回答 ;它是最终要更新的模型。
- ② 参考模型只算概率:左侧冻结模型给这同一条回答计算 log-probability,不另生成一条文本与它比较。
- ③ 奖励模型评分:右侧模型评价完整回答;图中的 对应本文的 ,两处参数记号不同。
- ④ KL 偏移惩罚:策略与参考模型的概率用于约束行为偏移;图中的 对应本文的 。
- ⑤ 合成信号并更新策略:奖励和惩罚共同影响更新。图省略了 Critic、old policy 快照和 token 级 advantage,不能把它当作完整 PPO 实现;下面补齐这些分工。
把生成看成一个有限长度的决策过程:状态 是问题和已经生成的前缀,动作 是接下来选出的 token,策略 给出这个 token 的概率。这里的状态、动作与通用强化学习篇使用的是同一套概念,只是换成了文本生成场景。
- Actor / policy:生成 token,也是最终要改进的语言模型
- Reference:冻结的 ,用于衡量相对初始行为的偏移
- Reward model:本轮 PPO 阶段冻结的 ,对完整回答打分
- Critic / value model:学习 ,估计从这个前缀继续生成的预期回报
这是四种分工,不一定要分别加载四份独立模型。为了算 PPO 的新旧概率比,还要保存生成这批数据时的策略 的 log-probability。它在这批数据的多次更新期间保持固定,下次采样时再刷新。Reference 则在整个训练阶段保持冻结。
一次训练循环可以概括为:用当前策略采样一批回答 → 保存 old log-probability、reference log-probability 和 value → 构造奖励与 advantage → 用小批量更新若干次 → 重新采样。PPO 可以复用最近一批轨迹多个 epoch,但仍通常归为 on-policy 方法,不能因此把它说成可任意复用陈旧数据的 offline RL。
为保持下文概率比的含义一致,先假设按 原分布采样。若实际用了 temperature 或 top-p 等变换,行为分布就可能不同,概率计算及校正必须与该实现一致。经过变换的解码结果,不能直接作为原始策略分布的样本计算。
3.2 回答末尾的奖励怎样影响前面的 token
上一节的奖励模型只在看完完整回答后给出一个分数。可语言模型是一个 token 接一个 token 地生成的:最后才拿到的分数,怎么用来调整前面每一次选择?先弄清每一步的奖励从哪里来,再计算每个位置的 advantage。
下面取有限回答、不折扣的设定,即 。本篇把回答 token 编为 ,终止后的状态记为 ;通用强化学习篇从 开始,因此最后一步是 、终止状态是 。两者只是编号不同。
一次 rollout 的数据这样产生:
- 用采样时的策略 根据问题生成完整回答,并记录每个 token 的 old log-probability。
- 把同一问题和完整回答送进冻结的奖励模型,得到一个序列分数 。它来自第 2.1 节训练好的评分器,并不是人工在这一步逐 token 打的分。
- 对已经生成的同一批 token,分别计算参考模型的 log-probability,得到每一步的对数概率差;再按系数 换算成该步的参考模型偏移项。
- 把完整回答的奖励分数加到最后一个有效 token 的奖励上。前面的 token 仍有各自的偏移项,并会在后续的回报与 advantage 计算中受到末尾奖励影响。
为什么这样分配可以对应前面的目标?第 2.2 节的 KL 是整条回答对数概率差的期望;根据第 1 节的自回归分解,这个差可以写成各 token 对数概率差之和。对从 采样的一条回答,把整条回答分数与逐 token 的偏移项加起来,就得到这条样本在旧策略下的正则化回报。下面的 是指示函数:最后一个有效 token 取 1,其他位置取 0。
因此,一种常见的逐步奖励构造是:
每一步都有一项采样到的策略与参考模型对数概率差;完整回答的奖励在最后一个有效 token 加入一次。单个采样项可以为正或为负,它本身不等于完整分布的 KL。这个奖励构造对应 old 策略采样时的正则化回报;PPO 的多次更新优化的是局部替代目标(surrogate):用这一批已采样前缀、固定 advantage 和新旧概率比,近似指导当前这轮参数更新,而非在每个更新步精确重新计算整个 。
把这条回答的每一步奖励相加,可以直接看到它与第 2.2 节目标的关系:
最后一步用到了第 1 节的序列概率分解。对 old 策略生成的回答取期望,右边的对数概率差才变成第 2.2 节中 old 相对 reference 的 KL;再对问题分布取平均,就得到该目标在 old 策略处的值。一次具体采样得到的是样本回报,不是这个期望本身。
用上面的雨的例子走一遍。假设训练好的奖励模型给这次采样的完整回答打 2 分。为了便于手算,假设回答只有两个 token,第二个是结束标记;真实分词的长度不一定如此。设 ,old 和 reference 对这两个已采样 token 给出的条件概率如下(这些概率也是人为设定的):
| 位置 | old 概率 | reference 概率 | 偏移项 | 加上完整回答评分后的逐步奖励 |
|---|---|---|---|---|
| 第 1 个 token | 0.4 | 0.2 | ||
| 第 2 个 token | 0.3 | 0.6 |
第一个位置上,old 给已选 token 的概率高于 reference,因此这一项为负;第二个位置则相反。这不表示第二个 token 单独获得了人类的好评。两项偏移相加恰好为 0,所以这条回答的正则化回报为 2。这里相消只是这个例子的结果,不代表每条回答的偏移项都相消。
Advantage 衡量的是:这个动作的预期回报,比当前策略在这个前缀下的平均回报高多少? 对应通用强化学习篇里的 。这里 Critic 估计 ,为比较提供基准;具体训练时用的是从采样数据算出的 advantage 估计,而不是已经知道精确的 。
Critic 的输入是问题和当前前缀,输出是从这里继续生成的预期正则化回报。它和奖励模型分工不同:奖励模型看完整回答,给出第 2.1 节学到的序列分数;Critic 看前缀,预测后面还会得到多少回报,包括本文构造的偏移项。采样时先记录每个前缀的旧 value,随后用奖励和这些旧 value 算出回报目标,再训练 Critic 拟合目标。第 3.3 节会给出一个具体目标,采样时使用的旧 value 在这批数据的计算中保持固定。
为什么完整回答最后才打分,前面的 token 仍能学习?一次 token 选择改变了后续生成路径,所以前面动作的评价也要考虑后续回报。最简单地把后面奖励全部相加,就得到该位置的实际回报;减去 critic 对这个前缀的预期,得到“本次回报比预期高多少”。GAE 据此混合多步估计,把后续的估计误差逐步传回前面的 token。这样,每个 token 获得的学习信号可以不同,而非共用一个末尾分数。
TD(Temporal Difference,时序差分)误差比较两种估计:“眼前奖励加下一个前缀的 value”,以及“当前前缀的 value”。先用 rollout 时记录的 value 计算:
GAE(Generalized Advantage Estimation)把后面的误差加权传回前面,可以倒着算:
这里假设回答真正终止时 。
继续用刚才算出的奖励 。假设 Critic 在采样时给两个前缀的旧 value 分别是 ,回答真正终止后的 value 为 0。那么:
- 最后一步:。
- 第一步:。
- 取 ,从后往前算,,。
首个 token 虽然没有直接拿到末尾的 2 分,末尾奖励仍通过后续回报影响了它的 advantage。 时,这个完整回答的首步实际回报是 2,减去首个前缀的旧 value 0.5,也得到 1.5。若取 ,则只用各自的一步 TD 误差;中间值按距离给后续误差加权。value 和 advantage 都是估计量,正值表示这次信号高于 Critic 的估计,不代表可以断言这个 token 对所有回答都更好。
GAE 的通用推导、 两端和偏差/方差讨论见强化学习基础,本篇只应用到回答 token。
若显式采用折扣,TD 中下一个 value 前乘 ,递推中乘 ,同时按折扣目标解释回报。达到长度上限不自动等于任务终止:若只是截断,就可能还存在未观察到的后续回报,要用截断点的 value 接上估计,这称为 bootstrap;任务就在此结束时要明确终止奖励。GAE 不能跨 padding 或下一条回答继续累加。GAE 原论文
3.3 PPO 的 token 概率比与裁剪目标
对同一条采样回答的同一个前缀,定义 token 概率比
本篇用所有有效回答 token 的平均定义 actor loss,并取负号供优化器最小化。通用强化学习篇则先对轨迹内各步求和,再对轨迹取平均;两者的分母不同。对同一批无折扣数据,若各位置使用相同的裁剪项,两者相差整批平均回答长度的倍数;若先对每条回答取均值再对回答取均值,加权方式又不同。
控制 surrogate 的 clipping 区间,与通用强化学习篇的例子采用相同约定。
接着看上一节的第一个 token:旧策略概率是 0.4,算出的 。假设一次更新后,新策略在同一前缀下给这个 token 的概率变成 0.48,则 。取 ,该样本的未裁剪项和裁剪项都是 。假如概率进一步变成 0.56,概率比是 1.4,未裁剪项为 2.1,但裁剪项仍是 1.8,取较小的 1.8。这说明正优势会鼓励这个 token,而越过裁剪边界后,继续提高它的概率不会再提高这一个样本的裁剪目标。新概率只是为了说明计算而假设的,不是断言真实更新一定产生这些数值。
先看要最大化的括号内部分,再记住代码取负号作为 loss。设 :
- 、 时,原项是 2.8,裁剪项是 2.4,取最小值 2.4;继续提高这个正优势动作的概率,不再提高该样本的目标值
- 、 时,原项是 -1.2,裁剪项是 -1.6,取 -1.6;继续压低这个负优势动作的概率,也不再提高该目标
- 、 时,取 ;提高负优势动作的概率仍受惩罚,不会被裁剪掉
这里的 是回答位置的 0/1 mask, 是有效 token 总数, 比较的始终是同一前缀下同一个 token 的新旧概率。裁剪限制了单个样本对目标函数的贡献,参数共享却仍可能使某些概率比越过区间,所以它不是概率比或 KL 的硬约束。更完整的分段推导见通用 PPO 推导。PPO 原论文 §3
def ppo_actor_loss(new_logp, old_logp, advantage, response_mask, eps=0.2): # All tensors: [B, L - 1], aligned with the selected next token. valid = response_mask.bool() if not valid.any(): raise ValueError("No response tokens") ratio = (new_logp[valid] - old_logp.detach()[valid]).exp() adv = advantage.detach()[valid] unclipped = ratio * adv clipped = ratio.clamp(1.0 - eps, 1.0 + eps) * adv return -torch.minimum(unclipped, clipped).mean()这里的新 log-probability 重新前向计算并保留梯度;old log-probability、advantage 和回报目标不反向传播。Critic 另外拟合固定的回报目标,例如 ,最小化有效回答位置的均方误差。实际 PPO 还需要处理 value loss 权重、可选的 entropy bonus、梯度裁剪、更新次数和 KL 监控;上面只展示 actor 核心,不是完整训练器。
Reference KL 衡量当前模型偏离固定参考模型有多远;PPO clipping 则比较本轮更新前后的策略,避免在同一批样本上改得太多。通用强化学习篇还介绍了一种 PPO KL penalty:它比较的是旧策略与新策略,而不是当前策略与固定参考模型。即使两篇都用 标记系数,也不表示两个惩罚项或系数相同。
4. DPO:直接从偏好对更新语言模型
采用 PPO 训练时,需要反复采样回答、计算奖励并估计 advantage。DPO(Direct Preference Optimization)先推导 KL 正则目标下奖励与最优策略的关系,再把奖励差改写为语言模型的 log-probability 差。
回到前面的雨的例子:PPO 路线先用「A 优于 B」等数据训练奖励模型,之后由模型给新回答打分,再用 PPO 更新策略。标准离线 DPO 可以直接拿 训练:比较当前策略和固定参考模型对 A、B 的概率,不需要先把人类偏好变成显式奖励模型的 2 分和 1 分。下文推导说明为什么可以这样构造损失;这不是说两条路线在任意数据和训练条件下都会得到相同模型。
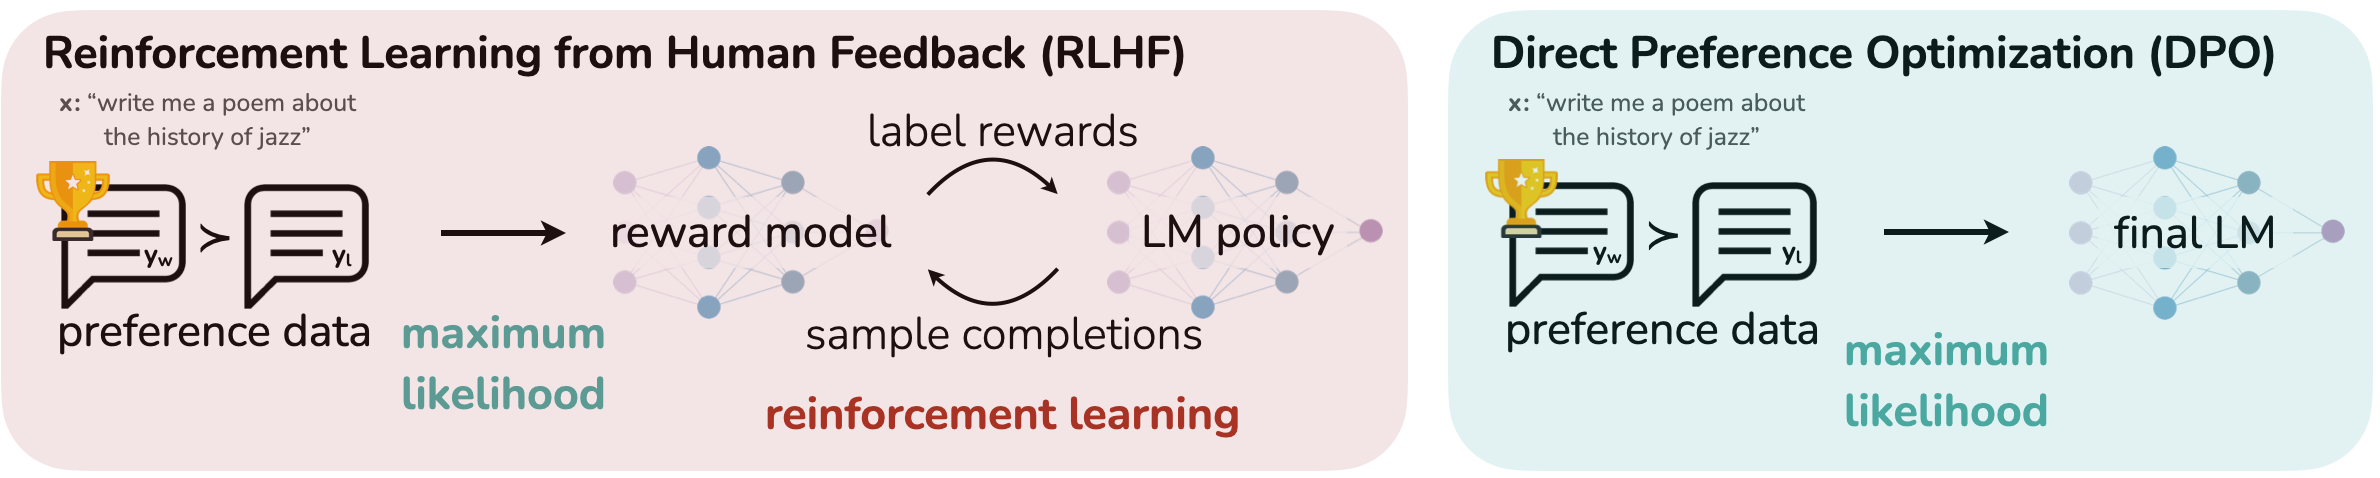
原论文把这两种训练路径并排画出。图中的 是同一个问题, 是人类更偏好的回答, 是较不偏好的回答;奖杯只标记偏好胜者,不是环境返回的数值奖励。
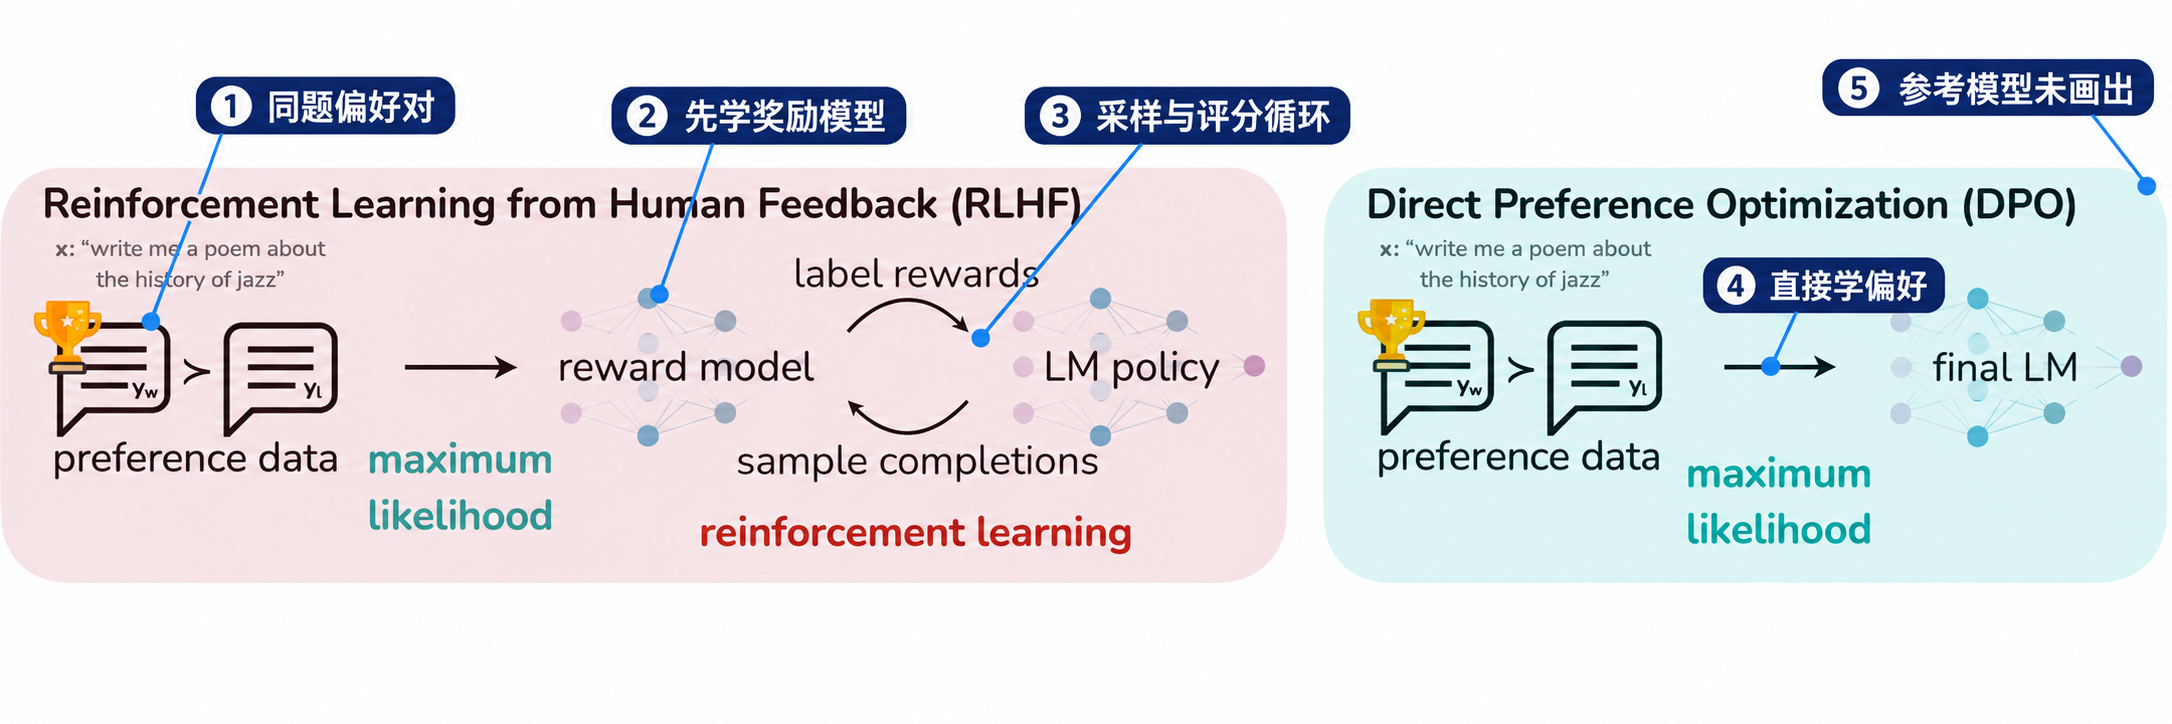
来源:Rafailov 等,DPO 论文 Figure 1;原图,CC BY 4.0。本图增加中文阅读标注。
- ① 同题偏好对:两条回答对应同一个问题 , 优于 ;奖杯表示偏好标签,不是奖励模型已经给出的数值。右侧 DPO 使用的也是这种比较数据。
- ② 先学奖励模型:左侧先用偏好数据训练 reward model,使胜者相对败者获得更高的分数。
- ③ 采样与评分循环:LM policy 采样回答,奖励模型评分,再由强化学习方法更新策略;上下两条弧线分别强调评分和采样的方向。
- ④ 直接学偏好:右侧把偏好对用于语言模型的可微损失,省去显式奖励模型与这条在线采样训练循环;它不等于只对胜者做 SFT。
- ⑤ 参考模型未画出:这条标注提示原图省略了训练细节,不是新增的数据路径。标准 DPO 仍需固定 reference 的对数概率;左侧 KL 正则化 RLHF 同样使用参考模型,具体定义见正文。
先读粉色左半边:偏好对经 maximum likelihood(最大似然)训练 reward model;之后 LM policy 采样回答,奖励模型为回答打分,两条弧形箭头表示反复采样和反馈。再读浅蓝右半边:同类偏好对直接用于优化 final LM,不再显式维护这条奖励模型与策略采样循环。
这里“直接”不等于只对胜者做普通 SFT。DPO 的损失还要比较胜者与败者在当前模型、固定参考模型下的对数概率;图省略了参考模型、KL 约束和 PPO 的 Critic,不能拿它代替完整训练定义。下文会逐项推导这些量如何进入损失。
这里不需要沿着离散采样结果直接求导。离散采样本身不能像连续张量那样直接反向传播,但期望奖励可以用 score-function / Policy Gradient 估计梯度,PPO 只是可选方法之一。DPO 则对固定偏好样本的可微 log-probability 直接训练。
4.1 加上 KL 正则后,最优回答分布是什么
固定 prompt ,暂时把策略看成可以自由选择的回答分布,奖励 和 固定。求
假设 ,策略只在参考分布的支撑集上取正概率,并且下式的归一化常数有限。“支撑集”在这里就是参考模型赋予正概率的回答集合;归一化常数 把重新加权后的数值调整到总和为 1。定义
为什么这是最优解?把它代入原目标,可直接整理为
第一项不随 改变,第二项不大于零,所以当 时,目标达到最大值。这个结论讨论的是固定奖励下的分布优化;它不意味着在神经网络容量、偏好数据和训练步数都有限的实际情况下,一定能找到同一个最优点。
例如仅有两个回答,参考概率为 ,奖励为 ,。未归一化权重为 ,所以 、。高奖励回答的概率提高,但另一回答并未直接变成零。
4.2 用奖励差推导 DPO 损失
对最优分布的表达式取 log 并移项:
对同一个 的两个回答取奖励差, 抵消。将 用可训练的 参数化,记
将这个奖励差代入 Bradley–Terry 偏好似然,得到
因此 DPO 比较的是“当前模型对 chosen 与 rejected 的对数概率差,比参考模型的这一差值高多少”。chosen 和 rejected 必须对应同一个 prompt,归一化项才能抵消。参考模型保持冻结,数据中的回答必须在其支撑集内,tokenizer、对话模板和回答边界也要与策略计算对齐。DPO 原论文 §4 与附录 A
例如仍用 A 优于 B 这条偏好数据。前面的两步假设中,old 策略给 A 的完整回答概率是 ,reference 给 A 的概率是 。为了对照,假设 DPO 某一步的当前策略恰好与这个 old 策略相同,且当前策略、reference 给 B 的完整回答概率分别是 0.03、0.06;这不意味着 DPO 必须先跑 PPO。这些仍是人为设定的数值:
| 完整回答 | 当前策略概率 | reference 概率 |
|---|---|---|
| A(chosen) | 0.12 | 0.12 |
| B(rejected) | 0.03 | 0.06 |
当前策略的对数概率差为 ,reference 的差为 ,因此 。取 ,DPO 损失为 。计算使用的是完整回答的 log-probability 之和,而不是前面奖励模型打的 2 分和 1 分。
注意 的位置和符号:原奖励目标是减 ,最优分布指数中是 ,DPO 的 sigmoid 内则是乘 ,并按 chosen 减 rejected 排序。对固定奖励而言增大 会加强正则;实际 DPO 同时在拟合偏好,训练效果还取决于数据、步数和学习率,不能只凭 推断每次更新后的 KL。
4.3 实现 DPO 损失,检查更新方向
def dpo_loss(policy_chosen, policy_rejected, reference_chosen, reference_rejected, beta=0.1): # Each input: [B], SUM of response token log-probabilities. policy_gap = policy_chosen - policy_rejected reference_gap = (reference_chosen - reference_rejected).detach() preference_logit = beta * (policy_gap - reference_gap) return -F.logsigmoid(preference_logit).mean()先用第 1 节的函数分别计算 chosen、rejected 的有效 token log-probability,再沿回答维求和。Reference 前向应在禁用梯度的上下文中执行;这里只用 detach() 强调损失不更新 reference,事后 detach 并不能省掉已经构造的计算图。做一次参数更新时,保留 policy 的计算图,调用 loss.backward() 和 optimizer.step(),并按训练循环清理或累积梯度。
记 ,一对数据的 loss 为 ,其导数为
因此,优化时希望增大 chosen 相对 rejected 的 log-probability 优势。策略与 reference 完全相同时,,loss 为 ;例如 时,loss 约为 ,更低。但参数共享、其他样本和归一化都会共同作用,不能保证一次 batch 更新后每条 chosen 的绝对概率都增加。
4.4 离线 DPO 怎样训练,需要哪些数据
标准离线 DPO 直接遍历已收集的偏好数据,不需要在每个训练步重新生成回答,也不需要单独的 reward model 和 critic。它仍需要可靠的偏好标签、固定 reference、正确的序列概率计算与独立评估;省去奖励模型,并没有省去收集和检查反馈数据的工作。偏好也可来自其他来源,但不能一概称为人类标注。
PPO 的训练样本主要由近期策略生成,DPO 的期望主要由已有偏好数据集决定。这是两条流程的重要差别:PPO 在训练中不断生成新回答,离线 DPO 主要学习已有数据中的回答比较。上述解析关系有相应假设,不能据此认为任意离线数据上的 DPO 都与在线 RLHF 精确等价;参考分布、偏好模型假设、数据质量和模型表达能力都会影响实际结果。
5. 写训练代码时要检查什么
- 概率计算:PPO ratio 是相同前缀下采样 token 的新旧概率比;DPO 用整段有效回答的 log-probability 之和
- mask 与终止:排除 prompt 的直接损失和 padding;明确 EOS、截断、空回答和多轮 assistant 边界;GAE 不跨样本传播
- 模型角色:reference 固定,old 随 rollout 刷新;奖励模型给完整回答评分,critic 估计前缀的未来回报
- 参与梯度更新的量:更新 policy,PPO 中另训 critic;old log-probability、advantage、reference 及固定奖励目标不反传
- 数值与评估:用
log_softmax、logsigmoid;观察 reward、KL 和回答长度,并用独立评估检查回答质量,不能只看训练 loss
本文代码展示损失计算;完整训练还需接入模型前向、数据采样、优化器更新与评估,PPO 还需完整的 rollout 流程。训练配置可继续读 SFT 训练实战,通用策略梯度推导见 Deep Reinforcement Learning。
参考资料
- Ouyang et al., Training language models to follow instructions with human feedback, 2022
- Schulman et al., Proximal Policy Optimization Algorithms, 2017
- Schulman et al., High-Dimensional Continuous Control Using Generalized Advantage Estimation, 2015 / ICLR 2016
- Rafailov et al., Direct Preference Optimization: Your Language Model is Secretly a Reward Model, 2023
学习时也参考了 Umar Jamil 的 RLHF 课程;本文的关键步骤用公式展开,推导依据以上原论文。
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。