0. 困惑度看的是模型给真实文本多大概率
评测自回归语言模型时,可以给它一段文本,让它根据前文计算每个位置各个候选 token 的概率。困惑度关注的是:对于文本中实际出现的 token,模型给了多大概率。
困惑度(Perplexity,常写作 PPL)把这些真实 token 的概率汇总成一个数。概率的几何平均越大,困惑度越低。 这里的“真实”指评测文本中实际出现的 token,不表示文本内容一定符合事实。
因此,PPL 衡量模型对给定文本的预测表现,不能直接用来表示回答准确率,或模型对自己生成内容有多大把握。如果模型把大部分概率分配给错误答案,真实目标的概率就可能很低,困惑度也会相应升高。
NOTE本文讨论自回归语言模型的困惑度。评测时使用真实前文,不把模型刚生成的错误 token 接回去继续评分。BERT 这类遮盖语言模型通常需要另外定义评价方式,不能直接套用这里的序列概率公式。
下面把语言模型视为一个函数:输入前文,输出各个候选 token 的概率。token 是模型一次处理的文本单位,可以是字、词或更小的片段;词表是全部候选 token 的清单。每一步的候选概率相加为 1。计算时只需要从这张概率表里取出真实 token 对应的一项,不要求先理解 Transformer 的内部结构。
1. 计算一段文本的条件概率
假设词表只有 6 个 token:a、the、red、fox、dog 和 .。待评测文本是 a red fox .,恰好由 4 个 token 组成。真实模型的 token 不一定对应一个完整单词,这里只是为了便于演示。
记文本为 : 是 token 总数, 是第 个 token, 表示被评测模型给出的概率。竖线 读作“在已知……的条件下”,例如 就是已知前文 a 时,接着出现 red 的概率。
计算整段文本的概率时,需要将各步的条件概率相乘:首先是 a 的概率,再乘上前文为 a 时出现 red 的概率,以及前文为 a red 时出现 fox 的概率,最后再计入句点。这就是概率的链式法则,不要求各个 token 独立。用 表示“把这些项连乘”,得到:
其中 表示第 个 token 之前的真实文本。第一个 token 的概率可理解为在固定起始上下文下的概率,后文省略这个条件。
每一步都取真实目标那一项,而不是挑概率最大的候选。这个例子的四步可以直接列出来:
| 已知的真实前文 | 这一步要计分的 token | 模型给它的概率 |
|---|---|---|
| 固定起始上下文 | a | 0.40 |
a | red | 0.27 |
a red | fox | 0.55 |
a red fox | . | 0.79 |
例如第二步必须取 ;即使另一个 token 概率更高,也不能拿它替代。
Hugging Face 的原动画把这个过程放慢了:青绿色标出当前被计分的词,粉红色标出已经给定的真实前文。青绿色向右移动一步,刚才的目标便进入粉红色前文;它不是先采样一个词再接回去评分。图中的英文句子与上面的四 token 数值例子不同,也没有画出各步的具体概率。
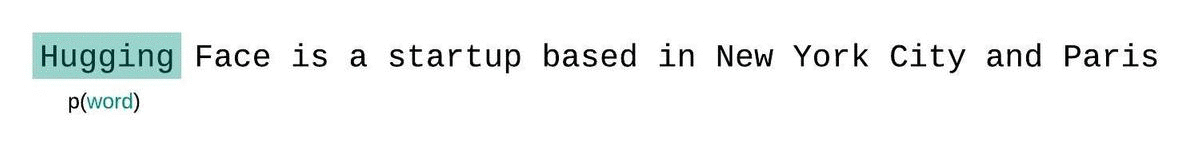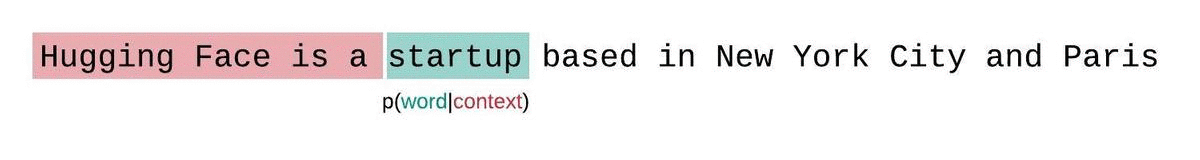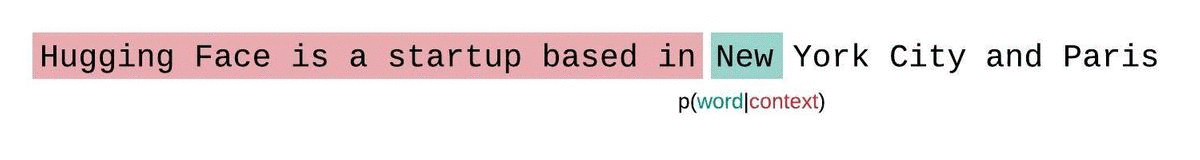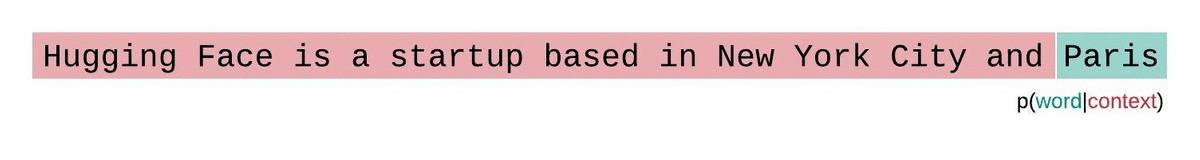
原图:Hugging Face,Perplexity of fixed-length models。保留原 GIF;图像仓库许可 CC BY-NC-SA 4.0。查看原尺寸动画。
- 看粉红色前文: 它们来自已经给定的真实文本,是本步条件概率的条件;不是模型自由生成的历史。
- 看青绿色目标: 每次只读取当前真实目标 token 的概率,再把它变成负对数损失。动画没有给出概率大小,不能仅凭颜色估算 PPL。
- 看目标向右移动: 上一步目标进入下一步的真实前文,逐个位置累计损失后再按计分 token 数平均、取指数。这里保留动态过程,下面的四 token 公式则提供可核算的数值例子。
1.1 句号不等于停止生成,还要看结束符
上面的乘积表示前 4 个 token 恰好为 a red fox . 的概率,没有包含“此时停止生成”这一事件。示例中的句点只是普通 token,不自动等于结束标记。
如果模型使用 EOS 表示结束,那么“生成这段文本,然后结束”的概率应为:
这是在包含 EOS 的词表上定义的概率;六词示例没有给出 EOS 概率,所以还算不出“生成这句话并停止”的概率。若评测把 EOS 也作为预测目标,负对数概率和计数分母都要加入这一项,目标数从 变为 。若只是因为达到长度上限而截断,则属于外部停止规则,不能当作模型预测了 EOS。[1]
1.2 为什么要按 token 数取平均?
联合概率中连乘的项数取决于文本长度。为避免仅因句子更长就得到更小的值,可以取每个真实 token 条件概率的几何平均:
本例为:
这个数概括了每个 token 的条件概率大小,并没有在所有句子之间构成归一化的概率分布。按长度取平均可以消除连乘项数不同带来的影响,但不同文本的预测难度仍可能不同,因此比较模型时,还要控制测试文本等其他条件。
2. 如何计算困惑度
困惑度就是上面这个几何平均值的倒数。为什么要写成对数形式?因为文本越长,一连串小于 1 的数相乘,结果就会变得非常小。取对数可以把乘法变成加法,让计算更稳定,也方便分批累计。
这里 是自然对数, 是它的逆运算。例如真实 token 概率为 ,对应的负对数是 ;概率降到 ,代价变成 。概率越小,代价越大。用 表示求和,对所有目标的负对数损失取平均,再取指数,就得到困惑度:
对序列概率取对数、除以长度并取负号,最后再取指数,就能得到两种写法之间的关系:
本例中,。
作为参照,如果模型在每个位置都对 6 个 token 均匀分配概率,那么:
直观地说,困惑度可以看成“达到相同平均预测难度时,相当于在多少个等可能选项中选择”。它不要求是整数,也不是每一步实际候选词的数量。
对于离散 token,PPL 至少为 1,但没有“最多等于词表大小”的保证。若真实目标的概率都只有 ,PPL 就是 100;若某个计分目标概率为 0,则 PPL 为 。
2.1 哪些 token 计分,分母就数哪些 token
实际评测时,并不是每个输入 token 都要计入损失:padding 只是用来补齐长度,重叠窗口中的部分 token 只用来提供上下文;对话模型还可能只给回答部分计分。
例如模型输入是 BOS a red fox,对应目标是 a red fox .。BOS 是起始标记,位置 a 的输出预测 red,而不是再次预测 a。如果只评最后两个目标,就只取 fox 和 . 的概率,分母也只能是 2。
令 为完成预测与标签对齐后,实际参与评分的位置集合,,其中 表示集合里位置的数量。用 表示第 个目标实际使用的上下文,则:
累加负对数概率时,分母也要数同一组位置:[2]
- padding、忽略标签和只作上下文的位置,都不进入分子或分母
- 自回归模型通常用前一位置的输出预测后一位置的 token,要在标签移位后统计有效目标;不能直接拿输入长度当作
- EOS 若参与评分,就同时进入概率和计数;BOS 若只提供起始上下文,则不计作预测目标
- 如果 ,这批数据没有可评测目标,PPL 未定义,不能返回 1
2.2 怎样计算整份语料的困惑度
设第 段文本有 个有效目标,总负对数似然为 。“似然”在这里就是模型给观察到的目标分配的概率; 是这一段所有 的和,还没有除以目标数。计算整份语料时,先分别累加损失和目标数,用总损失除以总目标数,再取指数:
不能直接对各句或各批次的 PPL 做算术平均,也不能在有效目标数不同时直接平均每批的平均损失。例如,两段文本分别有 1 个和 3 个目标,PPL 分别为 2 和 8,那么整体 PPL 是 ,不是 。
3. 和交叉熵的关系
在一个位置上,模型给出词表上的概率分布 ;真实 token 可以写成一个只有正确位置为 1、其余位置为 0 的分布 。若词表大小是 ,用 枚举词表候选, 是第 个位置给候选 的概率, 在 时为 1,其余为 0。该位置的交叉熵为:
例如词表只有 a、b、c,真实答案是 b,则 。如果模型给出 ,求和式里只有中间项留下,损失就是 。前面一直计算的负对数概率,正是这个分类交叉熵。
所以,PPL 是有效目标平均交叉熵的指数。词表大小 表示每个位置有多少个候选类别;跨 token 计算平均损失时,分母仍然是有效目标数:
如果交叉熵用自然对数,取 ;如果用 ,取 的幂。只要底数对应,得到的 PPL 相同。平均负对数似然本身是 ,不能直接称为困惑度。[1]
例如,两个有效目标的概率分别是 0.5、0.25,平均负对数损失约为 1.040,取指数后 PPL 约为 2.828。SFT 文章也用这两个概率演示训练损失;若模型、输入和计分位置完全相同,就可以对该平均损失取指数得到对应的 PPL。不过训练时计算的 loss 不自动等于独立测试集的 PPL。交叉熵与 KL 的关系另见 KL 散度的推导。
3.1 PPL 更低,准确率就一定更高吗?
不一定。准确率只看概率最大的选项是否命中,PPL 则关心给真实目标分配了多少概率。
例如有两个二分类位置,模型 A 给真实目标的概率分别是 和 ,模型 B 都给 :
- A 命中 1 个位置,准确率为 50%,PPL 约为
- B 命中 2 个位置,准确率为 100%,PPL 约为
A 的 PPL 更低,准确率却更低。因此,在相同评测设置下,PPL 更低意味着真实目标的平均负对数似然更低。仅凭这一指标,还无法判断模型的事实准确性、回答质量或概率是否与实际正确率相符。
4. 比较模型前,先统一文本、分词和计分规则
比较两个模型的 PPL 时,需要让它们使用相同的测试文本和计分规则:[2]
- 同一份测试文本与预处理。 数据难度、清洗、文档拼接和边界处理都会影响结果,单个句子不能代表整体表现
- 同一 tokenizer 和计分单位。 切成不同 token 后,预测事件和分母都变了,原始 token 级 PPL 通常不能直接比较
- 同一组计分目标。 是否计 EOS、是否只评回答、是否排除 padding,都要一致
- 同一上下文评测方案。 上下文长度、窗口步长、是否重置文档上下文都会改变每次预测所见的信息
有限上下文模型通常需要滑动窗口评测。重叠部分可以继续提供上下文,但每个目标只计一次;相比互不重叠的分块,窗口重叠通常让预测看到更多前文,不过并不保证任意模型、任意文本都取得更低 PPL。报告结果时,应同时说明窗口和计分设置。
下面两张官方原动画使用同一句话,可以直接对照“当前目标相同,允许看到的前文不同”。
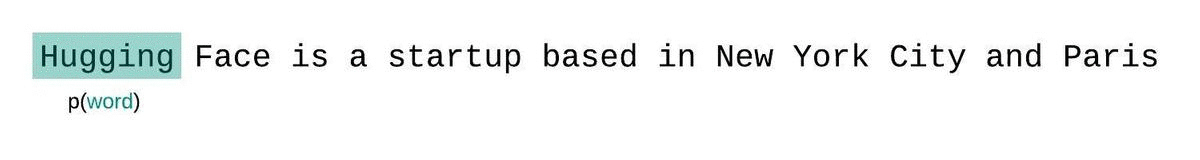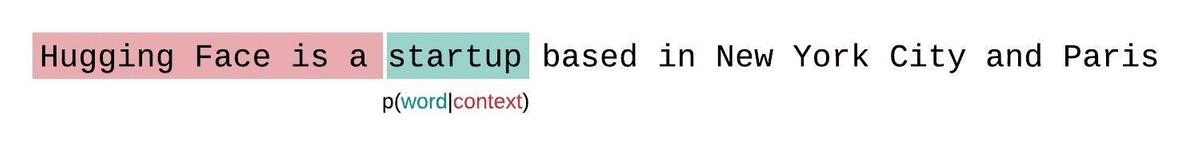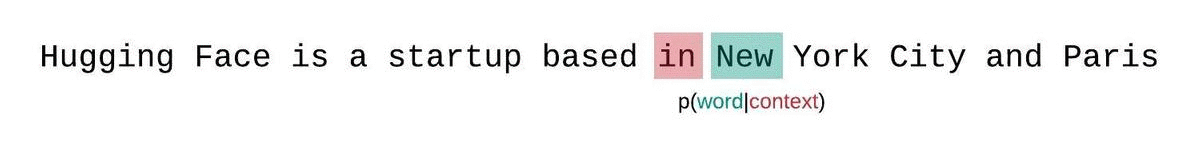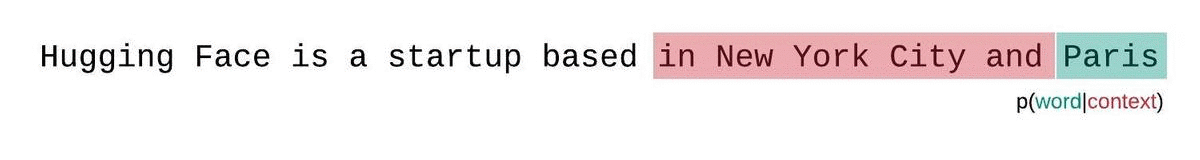
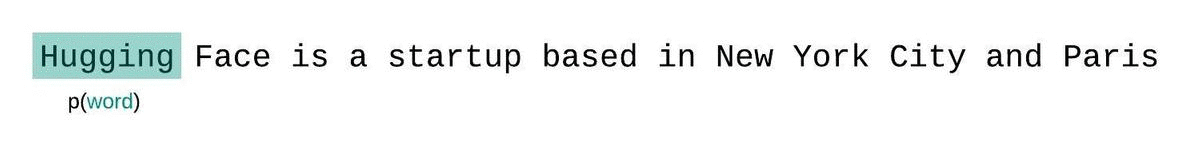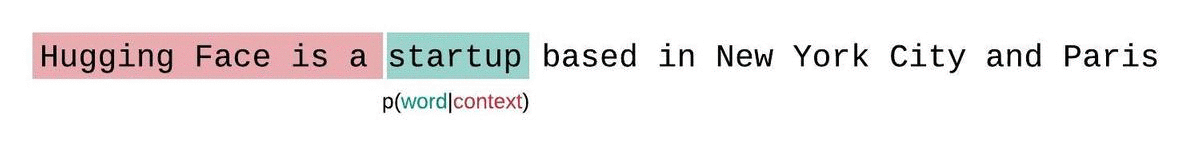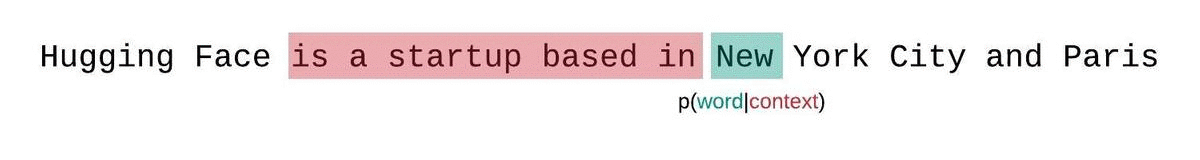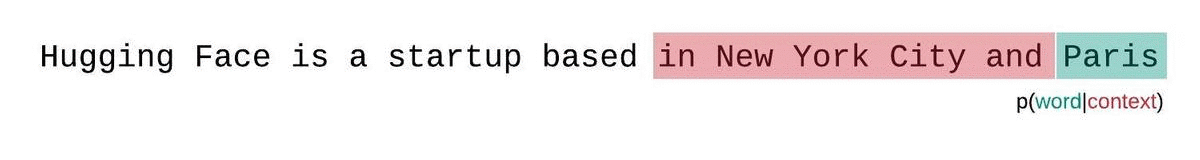
图源:Hugging Face,Perplexity of fixed-length models(分块原图、滑窗原图,CC BY-NC-SA 4.0,原样引用)。
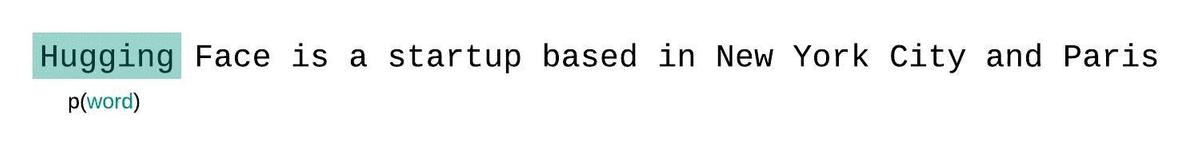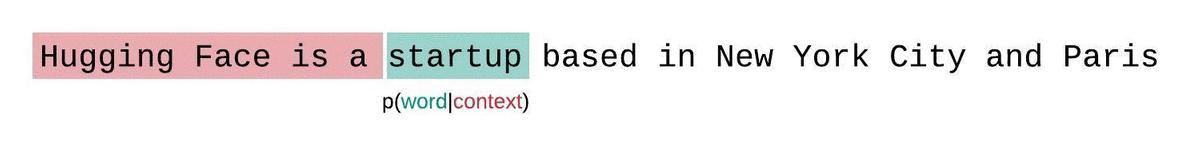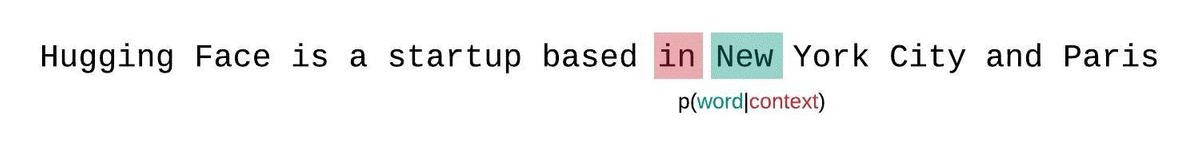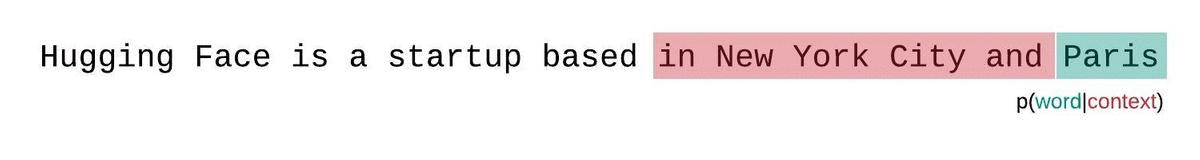
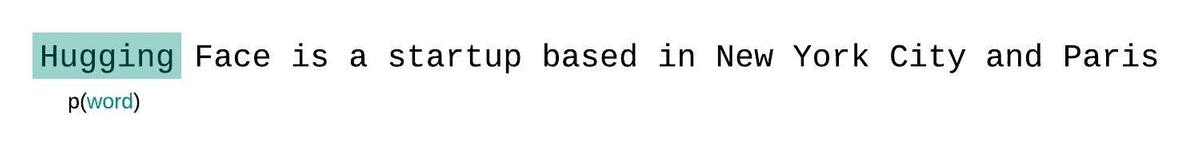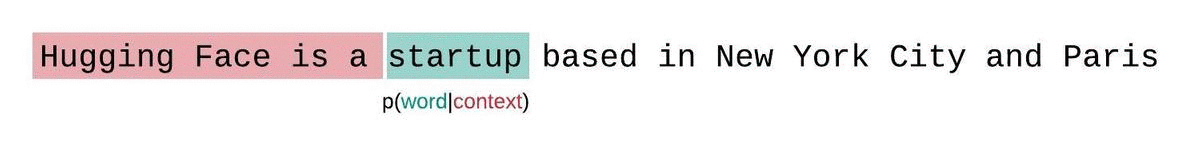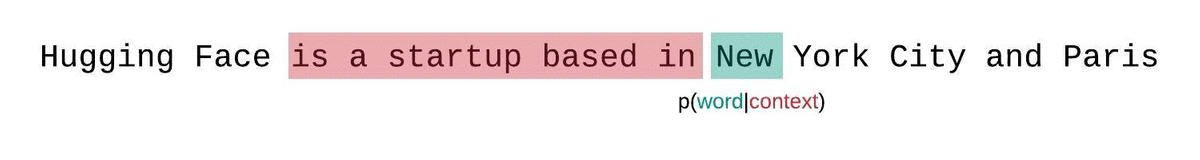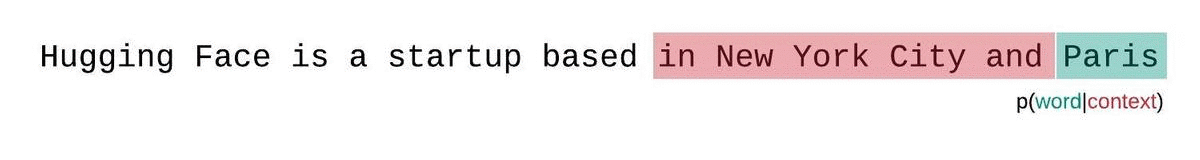
- 看青绿色目标走到
in的那一帧。 上图在分块边界丢掉了前文;下图仍可用最近的Face is a startup based。这两次条件概率的条件不同,不能只拿最后的 PPL 数字直接比较模型能力。 - 看粉红色区域。 同一个 token 后续再次出现时,可以仅作为上下文,不再作为计分目标。实现时应屏蔽这些重复目标的 loss,而不是把提供上下文的 token 从输入中删掉。
- 看窗口右移。 这是逐 token 滑动的直观示意,单词块也只是示意 token;实际 tokenizer 可能把一个词拆成多块。实际评测可用更大的 stride,但必须按真正参与 loss 的目标累计分母。
如果确实要比较使用不同 tokenizer 的模型,可以考虑在共同的原始文本上报告每字节或每字符的负对数似然,并说明文本编码、预处理及文档边界的处理方式。这需要按共同的计量单位重新计算负对数似然,不能直接将已有的 token 级 PPL 改名后进行比较。
参考资料
[1] Jurafsky 与 Martin:Speech and Language Processing,N-gram Language Models
[2] Hugging Face:Perplexity of fixed-length models
[3] Two minutes NLP — Perplexity explained with simple probabilities(原示例来源)
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。