0. 预测 80% 到底是什么意思
分类模型说“这是正例的概率是 80%”,这个数值究竟准不准?概率校准关心的就是模型报出的概率能否对得上实际发生的频率。以二分类为例:真实标签 表示正例, 表示负例,基模型输出一个分数 。校准器学习一个映射 ,将原始分数转换成概率 。即使原输出已在 内,也不代表它已经校准。
校准得好的模型应满足:在预测概率接近 0.8 的大量样本中,正例比例也接近 0.8。这里比较的是一组样本中的发生频率;仅凭单个样本,无法验证“它有 80% 的概率为正例”。
这和 AUC 评价的排序能力是两个问题。AUC 看正例的分数是否排在负例前面;校准看预测为某个概率的一组样本,实际发生的比例是否接近这个数。排序可以很好,但报出的 80% 仍可能偏高或偏低;两者需要分别检查。
1. 用校准曲线检查预测概率
在独立评估集上,把预测概率分成若干组(bin)。可以用等宽区间,如 、;也可以排序后分成样本数接近的组。每组平均预测概率作为横坐标,真实正例比例作为纵坐标。
例如,一组有 10 个样本,平均预测概率为 0.8,但其中只有 6 个正例。我们就画出点 ,说明这一组的预测整体偏高。点落在对角线上方表示预测偏低,落在下方表示预测偏高。样本少的组波动会比较大,因此也要留意每组的样本数。下方直方图只显示预测值的分布,不能单独用来判断校准好坏。
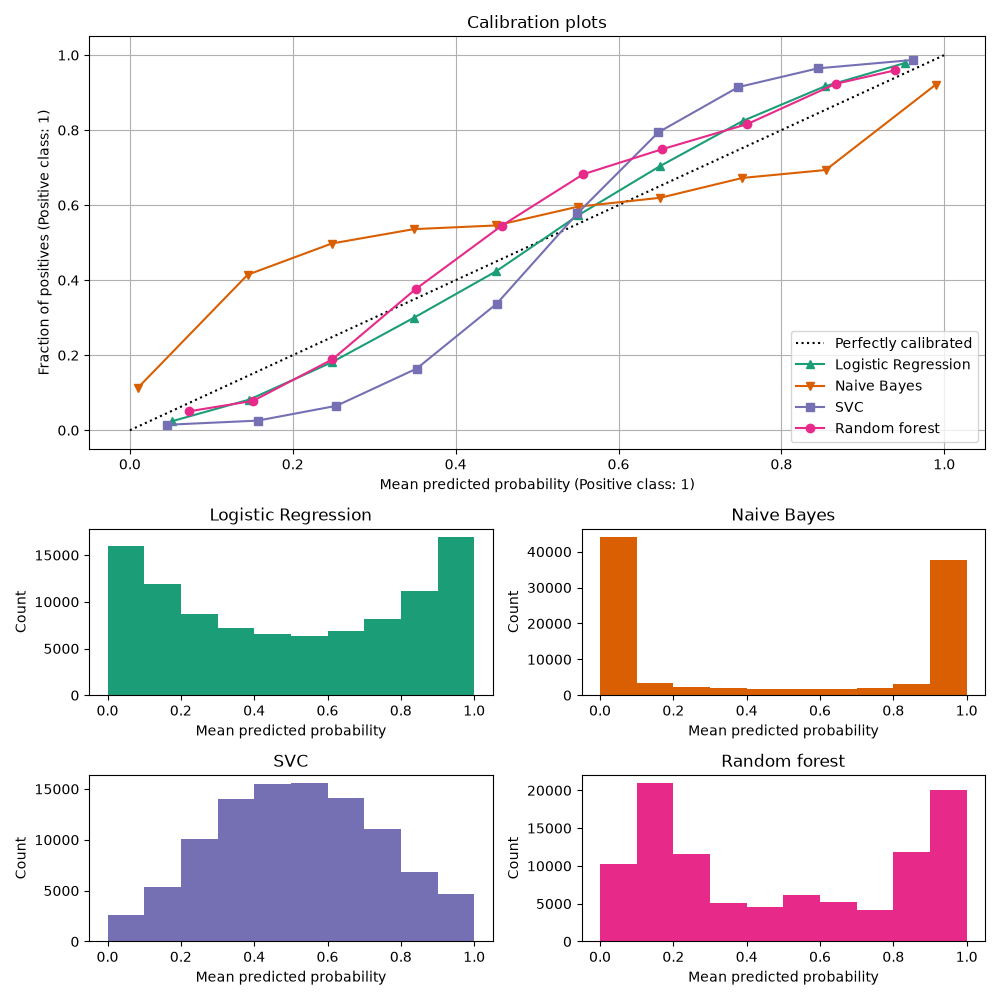
先读上半图的横轴“平均预测值”和纵轴“实际正例比例”,再沿黑色对角线比较各条彩线。下半图的纵轴改成样本数:橙色柱子主要在两端,紫色柱子主要在中间;注意 SVC 在这张图中的横坐标来自缩放后的决策分数,不能仅因落在 0 到 1 就当成天然的概率输出。
上图的绿、橙、紫、粉四条线分别对应逻辑回归、高斯朴素贝叶斯、SVC、随机森林。黑色虚线是理想校准;下方四幅直方图统计各模型给出了多少个不同区间的预测值。原图:scikit-learn 四模型校准比较,scikit-learn developers,BSD 许可,未改动。
下面结合校准曲线和直方图,说明几种模型的概率输出特点:
-
逻辑回归使用对数损失,在模型假设较合适时往往给出较准的概率;但交叉熵训练本身不保证在任意数据分布上都校准,仍应通过留出数据上的校准曲线检查。
-
图中的 Gaussian Naive Bayes(高斯朴素贝叶斯)常输出接近 0 或 1 的概率。这不能推广为所有“贝叶斯模型”的特征。它假设给定类别后各特征条件独立;若数据中有重复或强相关特征,同一份证据可能被重复计算,概率就会过于极端。
-
随机森林取多棵树预测概率的平均。当真实概率接近 0 时,各树估计不能低于 0,却可能因采样波动高于 0;平均后就可能向区间内部偏移。接近 1 时同理。图中集中于 0.1、0.9 是这份数据上训练出的结果,并非随机森林的固定输出范围。
这里的“方差高”指:换一批训练样本重新训练,在同一个输入上的预测变化很大。例如某棵深树因根节点分裂略有变化,后续整条路径都会改变。把多个不完全同步波动的预测取平均,通常可以减小这种变化;但降低方差不等于自动校准。所有树若都给出 0 或都给出 1,森林仍可以输出端点概率。
-
图中的 SVC 使用线性 SVM,再把决策分数做最小值—最大值缩放,硬映射到 。这解释了紫色直方图为什么集中在中间,也说明“落在 0 到 1”不等于“是可靠的概率”:它的校准曲线明显偏离对角线。这里没有使用 sigmoid 或 isotonic 校准,不能据此推断所有 SVM 的概率输出都集中在 0.5 附近。
2. 如何校准分类器
做校准时,三类数据各有用途:训练集用来拟合基模型,校准集用来学习从分数到概率的映射,最终测试集用来评估接入校准器后的预测。不能用同一份数据既拟合校准器又报告最终效果,否则校准曲线会过于乐观。交叉验证可以更充分地利用训练数据,但最终仍需要独立评估。
2.1 CalibratedClassifierCV 怎么划分数据
可以使用 CalibratedClassifierCV 校准分类器。用来训练校准器的分数,应由没有用对应样本训练过的基模型给出。交叉验证可以做到这一点:每轮用其余各折训练模型,再预测留出的这一折,这叫折外预测。对于已训练模型,需使用独立的校准集。下面使用参数名 estimator 说明交叉验证的过程:
- 当
ensemble=True:- 将用于交叉验证的数据划分为 折;每轮用 折训练基模型,剩下 1 折拟合校准器,轮换 次。这里的留出折不是最终测试集。
- 每折复制一份
estimator,在训练折拟合基模型,再用验证折的预测拟合校准器。校准方法可选 sigmoid、isotonic 等,具体以安装版本为准。 - 拟合后的校准器保存在
calibrated_classifiers_属性中,每项都是一个校准后的分类器,其 predict_proba 方法输出校准后的概率。 - CCV 类本身的 predict_proba 方法会取
k个估计器的预测概率平均值,这些估计器保存在calibrated_classifiers_列表中。 - predict 返回概率最高的类别。
- 当
ensemble=False:对未训练的普通基模型,用折外预测拟合一个校准器,推理时配合在全部训练数据上重新拟合的基模型;这也是合理选择。对于FrozenEstimator包装的已训练模型,则只用独立校准集拟合校准器,不重新训练基模型。当前版本ensemble默认是"auto",前者通常走True分支,后者走False分支。
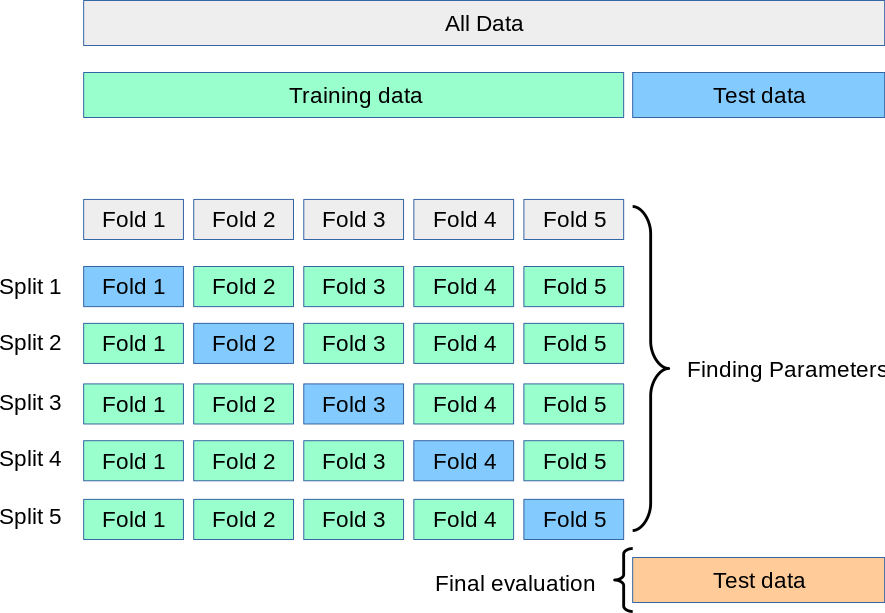
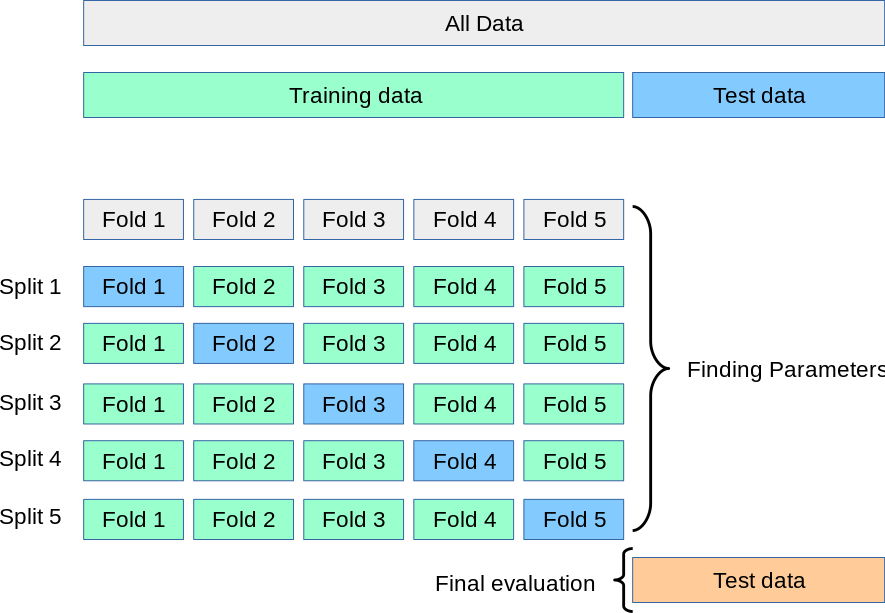
这张通用交叉验证图帮助区分“内部留出折”和“最终测试集”。上方先把全部数据分成训练部分与右侧测试部分;下面五行只轮换训练部分,每行蓝色的一折被留出,绿色四折用于拟合基模型。用于 ensemble=True 的概率校准时,把这一行蓝色折上的折外分数及真实标签交给该行的校准器,得到五组“基模型+校准器”;新样本的五组校准概率再取平均。右侧最终测试数据不参与任何一组拟合。
原图展示的是通用交叉验证的数据边界,不包含校准器本身,也不是 ensemble=False 的完整流程。原图未改动:scikit-learn,Cross-validation,scikit-learn developers,BSD-3-Clause;原图链接。
2.2 校准方法
2.2.1 sigmoid 校准
这里 是第 个校准样本的原始分数, 是真实标签, 是要学习的两个参数。训练时,用校准集的真实标签来调整这两个参数,让输出概率更符合实际结果。具体目标通常是最大化二分类似然,等价于最小化对数损失。公式沿用 Platt 的符号,指数中写的是 。因此,若分数越大越像正例,常见拟合结果是 ,使输出概率随分数升高。
例如 时,分数 映射为 0.5, 映射为约 0.881。学习 调整变化的快慢,学习 调整曲线的位置。
sigmoid 只拟合两个参数,校准样本较少时通常不容易过拟合,但能拟合的形状也有限,只能是一条 S 形曲线。正、负两类样本的分数分别近似服从正态分布,且两个分布的方差相同,是支持这种形状的一种情形,不是使用它之前必须证明的条件。类别不平衡也不必然意味着方差不同;是否合适仍要在独立数据上检查。
2.2.2 isotonic 保序回归
isotonic 不预先规定曲线的具体形状,只要求原始分数越高,校准后的概率不能更低。拟合时,一些训练点可能被合并,得到相同的概率。对于新分数,scikit-learn 会在拟合结点之间做线性插值,因此预测函数是分段线性的,也可能有平坦区间。详见 官方 Isotonic regression 文档;相关类见 sklearn.isotonic。它最小化下面的目标:
该方法拟合的是非递减函数,而非严格递增函数:若原分数 ,校准后只保证 ,两者可能映射到同一个概率。
约束为:
当:
是样本的真实标签, 是校准后分类器对该样本的输出,即校准概率。
isotonic 回归会合并违反非递减约束的相邻组。例如分数依次为 0.2、0.4、0.6,对应标签为 0、1、0。直接输出 0、1、0 违反非递减约束,后两个点合并后输出 0、0.5、0.5。这也解释了为什么不同分数会得到相同概率。
它更灵活,也更容易记住小样本噪声。scikit-learn 文档提到的约 1000 个校准样本只是经验量级,并非效果保证:还要考虑正负例数量和各分数区间的覆盖。比较校准效果时,仍要使用没有参与拟合的样本。对同一组分数应用同一个严格递增映射会保留排序;isotonic 的平坦段可能引入并列,从而改变 AUC。这一排序结论不能直接套用到多个模型校准后再平均的 ensemble 上;校准好也不意味着排序好。例如所有样本都预测总体正例比例,可以总体校准,却无法区分谁更可能为正例。
参考资料
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。