0. 从 Logits 得到下一个 Token 的概率
语言模型每生成一个 token,先给词表中的每个候选输出一个实数分数,叫作 logit。这些分数可以为负,也不必相加等于 1;所以不能直接拿来当概率。词表大小记为 ,第 步给候选 的分数记为 。softmax 做两件事:用指数把分数变成正数,再除以这些指数值的总和,使概率加起来等于 1。
设 是第 步的 token, 表示此前已经选出的 token。每一步都以固定的 prompt(用户输入的提示文本)为前文的一部分,公式中没有单独写出它。符号 表示“给定这段前文,下一个 token 为候选 的概率”:
以三个候选为例:若 logits 是 ,取指数后是 ,相加得到 7,所以 softmax 输出 。本文的 表示自然对数, 是对应的指数运算。实际模型词表远大于 3,这里只是缩小表格以便手算。
得到概率分布后,**Decoding(解码)**决定怎样从中选出下一个 token:可以直接选概率最大的候选,也可以按概率采样,或同时保留多条生成路径。
选中的是词表中的 token ID。生成时,模型把这个 ID 接到已有序列后,再用新前文计算下一步概率;最后由 tokenizer 把整段 ID 解码为文字。Token、ID 和输入向量的区别见 Tokenization,逐步生成与缓存的过程见 Prefill、Decode 与 KV Cache。
模型给出的概率表示:根据当前前文,哪些续写更可能出现,并不直接衡量事实正确性或回答质量。解码策略可以调整搜索范围、随机程度和输出长度,但无法补足模型缺失的事实知识。
本文用 表示 Temperature,用 表示生成长度,用 表示 Top-P 的概率阈值,避免把温度、长度和概率函数混在一起。这里的 token 也不一定是一个完整的词。
1. Greedy:每步选择概率最大的 Token
Greedy Search 每一步都选条件概率最大的 token:
符号 的意思是“返回使概率最大的那个候选”,而不是返回概率值。例如 的最大值是 ,argmax 返回第一个 token。帽子 表示我们最后选出的结果。
Greedy 的计算简单,也没有采样带来的随机性,但每次选择只考虑当前这一步。下面看一个例子:每步都选当前概率最大的 token,整段文本的概率却不一定最大。
- 第一步:,
- 选择 后:,
- 选择 后:,
这里 EOS 是结束符,每一行条件分布都归一化为 1。Greedy 先选 ,再选 EOS,完成序列的概率为 。另一条完成序列 的概率却是 ,更高。
所以 Greedy 不保证找到模型概率最高的完整序列。即使找到了,仍不能据此判断内容正确。某些模型和上下文还会形成重复续写;但并非每次 Greedy 都会重复。
生成通常在遇到 EOS 时结束。程序还会设置最大生成长度,避免一直生成下去。因达到长度上限而停止时,文本可能尚未完整结束。
2. Pure Sampling:按完整分布采样
Pure Sampling 按整个分布抽取下一个 token:
这里的 读作“按右边的分布抽样”。一种直观的采样方法是:将长度为 1 的线段按候选概率划分,再在整条线段上均匀抽取一个点,选中该点所在区间对应的 token。例如 对应区间 、、。
概率为 0.28 的 token,在相同分布下有 28% 的抽中机会。它允许生成不同续写,但不保证两次结果不同。
这里的随机抽样是在模型生成时选下一步;困惑度评测则给定真实文本,读取真实目标 token 的概率,不需要先从模型采样。若想看均匀随机数怎样转换成指定分布的样本,可读逆变换采样。
问题在于,单个低概率 token 的概率虽然小,很多这样的 token 加起来,总概率仍可能很大。例如尾部有 1000 个 token,每个概率为 ,尾部总概率就是 0.1。纯采样会以 10% 的概率落入这部分。这个例子说明多个低概率候选仍可能具有较大的总概率;这里没有假定这些候选都是错的,不同模型给低概率候选分配的总概率也会不同。
罕见人名和专业术语虽然可能概率较低,却仍可能是正确答案。下面介绍的裁剪方法只能限制候选范围,无法判断内容真假。
3. Temperature:让概率更集中或更分散
Temperature 在 softmax 之前缩放 logits:
这里暂时省略步数 , 是同一步中候选 的 logit。仍用 :温度 时概率是 ; 时,取指数得到 ,概率成为 。第一名的概率从约 0.571 升到 0.762。降低温度后,候选集合不变,但概率更集中在原本排名靠前的候选上。
它改变概率之间的差距。比较两个 token:
- :扩大高分与低分候选之间的概率差距,分布更集中
- :保持原始分布
- :缩小差距,分布更平坦
如果最大 logit 唯一, 时该 token 的概率趋于 1,采样趋近 Greedy。如果有多个并列最大值,极限分布在它们之间均分;确定性的 Greedy 还需要规定并列时选哪一个。不能直接把 代入公式,一些接口会把零温度单独解释为 Greedy,另一些会拒绝这个值。
当 ,所有有限 logits 对应的 token 概率趋于相等。若某些 token 已经通过 被屏蔽,它们不会重新加入候选集。
正温度缩放不会改变 logits 的排序,因此只做 argmax 时结果不变;在采样或 Top-P 筛选时,概率大小才会影响结果。降低 Temperature 会让原本高概率的候选更容易被选中,但不会让模型学到新的事实。
4. Top-K:保留概率最高的 K 个候选
Top-K Sampling 保留概率最高的 个 token,其余概率置零,再重新归一化。“重新归一化”就是把留下来的每一项除以它们的总和。例如 只留前两个,留下的总概率为 ,新概率是 ,总和重新等于 1。设原来的概率为 ,保留集合为 ,裁剪后的概率为 ; 都是候选编号,则:
这里 可以是 Temperature 调整后的概率。条件是 ,并且候选集总概率大于零; 对应单候选, 不裁剪。数学上若要求恰好保留 个,需要规定并列时如何选择;某些实现按第 大分数做阈值筛选,遇到并列会保留更多 token。
固定 的局限在于,保留同样数量的候选,在不同分布下留下的总概率不同:
情况 A:分布很集中。 前两个 token 概率为 0.85、0.10,其余 1000 个各为 0.00005,总和为 1。Top-K=50 保留前两个和 48 个尾部 token,其总概率为:
归一化后,尾部的总概率仅为 。虽然保留了 48 个尾部候选,它们在采样中仍只占很小一部分。因此,评价 Top-K 的效果时,除了保留的候选数量,还需要查看这些候选合计占多少概率。
情况 B:分布很平坦。 假设有 100 个 token,各占 0.01。Top-K=50 保留的总概率为 50%,Top-K=5 则只有 5%。此时较小的 可能过度压缩选择范围。
或 都只是参数取值;对于几万甚至更多 token 的词表,不能仅凭 就称为“接近完整采样”。
5. Top-P:保留到累积概率达到阈值为止
Top-P Sampling 按概率从高到低依次保留候选,直到它们的累积概率达到指定阈值,因此每一步保留的数量可以不同。将概率按降序排列为 。下标括号表示名次: 是最大概率,不一定对应词表 ID 1。用 表示尝试保留的数量, 表示第一次使累计值达到阈值的数量, 表示选出的候选集合:
随后在 内重新归一化并采样。刚好使累积概率跨过阈值的 token 也要保留,否则保留候选的总概率可能达不到 。并列概率的顺序、浮点边界和最少保留数量可能让具体实现略有差异。
例如分布为 , 时保留前两个,总概率为 0.85,最终分布为 。
Top-P 的阈值针对累积概率,而不是 token 数量的占比:
- 分布集中时,少量 token 就能达到阈值
- 分布平坦时,需要保留更多 token
- 不再主动移除正概率候选,但之前的其他过滤仍然有效
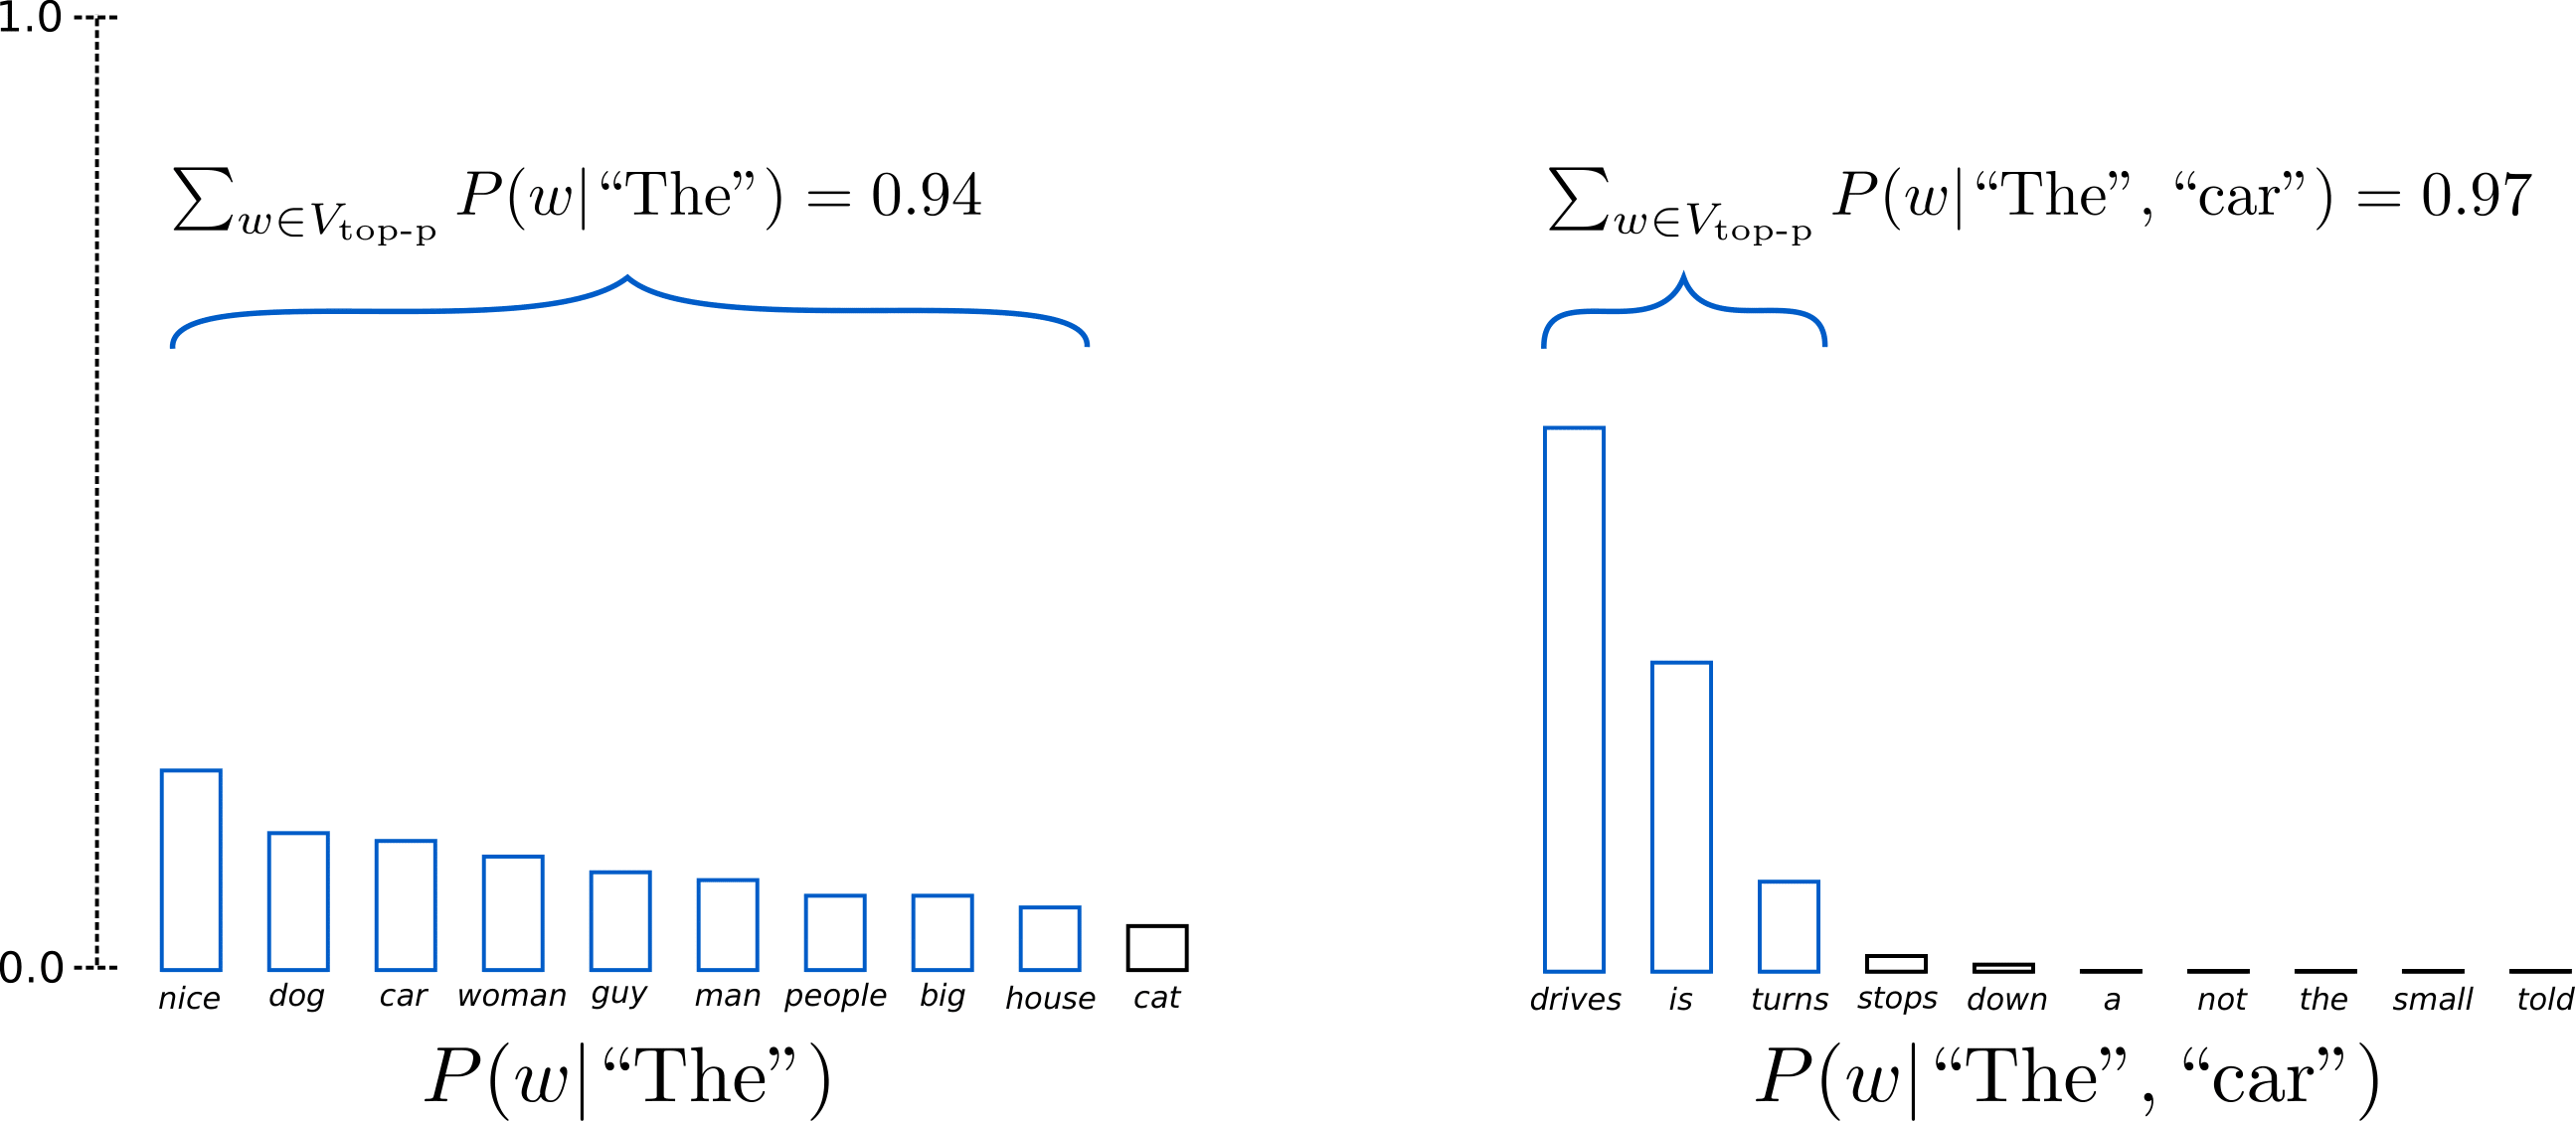
下面原图使用另一组分布,并将阈值设为 0.92。左边在前文只有 The 时,蓝色括号要包住 9 个候选,累计概率才达到 0.94;右边前文变成 The car,只需 drives、is、turns 三个候选便达到 0.97。同一个阈值,留下的词数会随这一步的不确定程度变化。
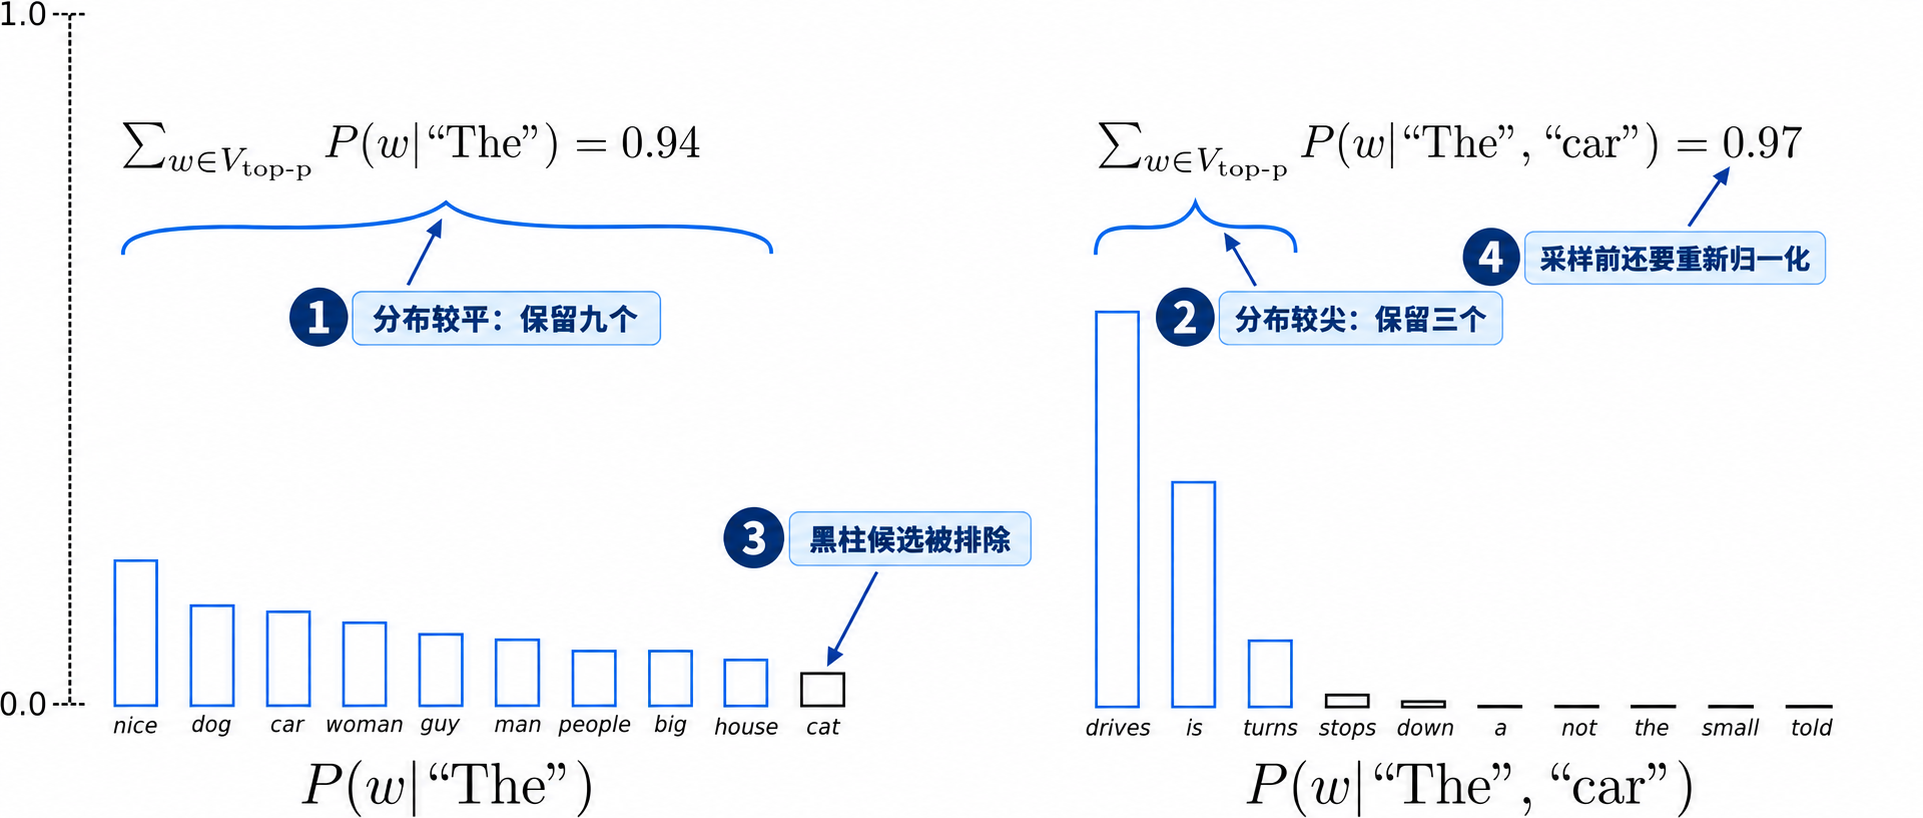
原图:Patrick von Platen / Hugging Face,How to generate text — Top-p sampling;中文编号与引线为辅助标注。查看未加中文标注的原图。图片版权归原作者。
- ① 较平的分布需要更多候选: 左边给定前文
The,九根蓝柱的累计概率为 0.94,才跨过本图的 0.92 阈值。Top-P 控制的是累计概率,不是保留词数的百分比。 - ② 较尖的分布留下更少候选: 右边给定
The car,前三个候选的累计概率已达 0.97。阈值相同也不要求词数相同,跨过阈值的那个候选仍要保留。 - ③ 黑柱在过滤时被排除: 蓝柱对应候选集合内的词,黑柱对应集合外的词;真正采样时集合外概率归零。过滤并不保证蓝柱里的答案一定正确。
- ④ 采样前重新归一化: 图中柱高仍是截断前的概率,左侧蓝柱要分别除以 0.94,右侧要分别除以 0.97,才各自加起来等于 1。上面的四项分布例子按 0.8 阈值计算,不要与本图数值混用。
Top-P 会根据当前分布调整候选数量,但保留下来的候选仍可能是错误答案。Nucleus Sampling 论文讨论了这种动态截断与开放式生成的关系。
6. Temperature、Top-K、Top-P 一起用时先做哪一步
下面采用 Temperature → Top-K → Top-P 的顺序。不同服务可能采用不同处理顺序,不能只看参数名字就认为最终分布相同。
输入:logits z,正温度 T,候选数 K,概率阈值 rho
1. z_scaled = z / T2. p = softmax(z_scaled)3. 只保留 p 中最高的 K 个候选,其余置零4. 将剩余概率重新归一化,得到 q5. 在 q 上按降序累加,保留首次达到 rho 的最小前缀6. 再次归一化,并从最终分布中采样
输出:下一个 token第 4 步需要对 Top-K 保留下来的候选重新归一化。后续 Top-P 的阈值针对这个新分布;如果仍然累加旧概率,就会改变筛选结果。
例如,Temperature 处理后的概率是 ,取 、:
- Top-K 保留前三个,总概率为 0.90
- 中间归一化得到
- 前两个的累积概率为 ,已经达到 0.75,因此只保留前两个
- 最终分布为
如果直接用旧概率累加,前两个只有 0.70,就会错误地保留第三个。更明显的是,若阈值为 0.95,Top-K 后旧概率的总和只有 0.90,根本不可能达到阈值。
实际代码常把被删除的 logits 设为 ,Top-P 处理器再对剩余 logits 做 softmax,因此这个“中间归一化”可以隐含在实现内部。Hugging Face Transformers v4.57.1 的处理器顺序和 Top-P 实现可用来对照这一流程。
下面只展示调用参数,假设已经准备好相互匹配的 model、tokenizer 和编码后的 inputs,不是完整的模型加载脚本:
# 参数语义以 transformers==4.57.1 为例output = model.generate( **inputs, do_sample=True, num_beams=1, temperature=0.7, top_k=50, top_p=0.9, max_new_tokens=512,)在这一版本的普通生成模式中,do_sample=False, num_beams=1 对应 Greedy;do_sample=False, num_beams>1 对应 Beam Search。不能笼统地说 do_sample=False 就一定是 Greedy。Temperature、Top-K、Top-P 是这里的采样参数,不用于这两种非采样模式;实际配置还应检查模型自带的 generation config。
在没有其他 logits processors 的前提下,如要做不截断的普通采样,可显式设 temperature=1.0, top_k=0, top_p=1.0, num_beams=1。其中 top_k=0 是该 API 的“关闭 Top-K”约定,与数学上保留零个候选不同。详见版本化生成文档。
7. Beam Search:同时保留多条路径
7.1 怎样给候选路径评分,遇到 EOS 怎么办
Greedy 和普通采样每步都只延续一条路径。Beam Search 则保留至多 条尚未结束的前缀:
- 扩展每条活跃前缀,计算下一 token 的条件概率
- 将原前缀分数与新 token 的对数概率相加
- 在扩展结果中选择高分的非结束前缀,继续搜索
- 按实现的候选排名与剪枝规则,将符合保留规则的 EOS 候选放入已完成集合,不再继续扩展;不是收集所有产生 EOS 的候选
- 满足停止条件或达到最大长度后,从候选中选出结果
可以先用下面的原图看清“扩展,再一起剪枝”的过程。这里使用另一组示意字母,与下文数值例子的概率无关。
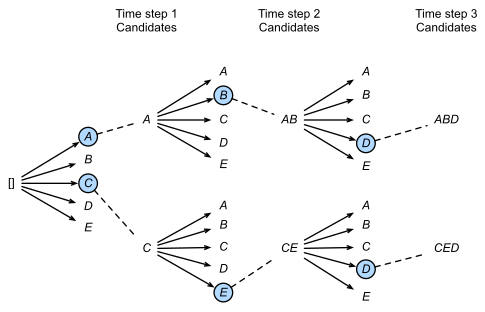
图源:Zhang 等,Dive into Deep Learning,Beam Search,图 10.8.3(原图,CC BY-SA 4.0,原样引用)。

- 第一列。 词表有 A–E 五种候选,蓝圈表示这一轮保留 A、C 两条前缀。
- 第二列。 两条前缀各扩展五个候选,再从合计十条里按累计分数选出 AB、CE。图中碰巧各来自一个父前缀;一般并不要求每个父前缀都留下一条。
- 第三列。 继续扩展保留下来的前缀,得到 ABD、CED。已经剪掉的其他路径不会自动回来,所以宽度有限的 beam search 仍可能漏掉全局最优结果。图中没有标明哪个字母代表 EOS,也没有画出单独的已完成候选集合;结束候选的处理仍以下面的约定为准。
沿用第 1 节的概率树,取 beam width 。第一步保留 A(0.6)和 B(0.4);下一步得到 A EOS(0.306)、A C(0.294)、B EOS(0.396)、B C(0.004)。本例约定排名前 的 EOS 候选有资格进入完成集合;这两条 EOS 候选恰好排前两名,因而都进入完成集合,其中 B EOS 比 greedy 找到的 A EOS 更好;未结束的候选仍可继续展开。保留多条前缀,正是为了避免第一步就丢掉 B。
不计结束候选的额外处理时,每一步约有 个扩展。实现可能先取更多候选,再分别处理 EOS 与活跃前缀,不是每轮必然得到 条“完整句子”。例如 Transformers v4.57.1 的 BeamSearchScorer.process 会检查 EOS 候选的排名,未进入当前组前 group_size 名的 EOS 不加入完成集合;普通不分组情形下 group_size=B。这是一个具体实现的规则,不是所有 beam search 变体的唯一定义。
固定 prompt 后,长度为 的候选分数是:
对于自然结束的完整序列,本文把最后一个 EOS 也计入 和概率。没有 EOS 的前缀分数与完整序列概率不能混为一谈。
累加对数概率可以避免长序列的概率连乘下溢。若 100 步的条件概率都为 0.1,乘积是 ,float32 会下溢为零,而其自然对数是约 。对数是严格递增函数,比较对数概率与比较原概率等价,又能避免长乘积下溢。实现通常直接计算稳定的 log-softmax。
7.2 长短不同的候选怎么比较
原始对数概率每增加一个 token,都会加上一个非正数。因此同一前缀越延伸,原始分数不会增加;不同长度的候选比较时,可能出现偏短倾向。不过,不同前缀本身的概率也不同,因此短序列的分数并非总比长序列高。
一种常见修正是长度归一化:
当 时回到原始分数。 会相对抬高长候选的负分数,但不会保证生成一定更长。例如两个候选的概率与长度分别为 和 ,按原始概率前者更高;若 ,则分数约为 和 ,后者更高。此时优化目标已经不是最大化原始序列概率。
不同系统的长度惩罚公式,以及长度是否计入 prompt、EOS,都可能不同,应以具体实现为准。EOS 候选也要按同一评分约定比较。停止策略同样重要:完成了 条候选,不代表在任意长度评分下继续搜索都不可能找到更好的候选。Transformers 的生成配置分别定义了 length_penalty 与 early_stopping。
7.3 多保留几条路径,有什么收益和代价
退化为 Greedy,指的是这样的简化约定:每步在包括 EOS 的全部候选中只保留唯一最高分者;若它是 EOS 就停止,否则只延续它,并采用相同的并列处理与长度上限规则。若独立收集已完成候选,同时另留一个非 EOS 前缀继续搜索,就需要另行定义评分与停止规则,不能自动套用这个结论。某些框架会在 num_beams=1 时直接调用 Greedy,但这属于框架选择不同生成函数的规则,不能推广到所有 Beam Search 变体;上述版本的 BeamSearchScorer 本身还要求 num_beams > 1。
增大 可以扩大搜索范围,但也会增加计算和缓存开销。Beam Search 仍然是近似搜索:某个前缀一旦被剪掉,它后面的高分续写就无法找回,因此不保证找到全局最高分的序列。
Beam Search 常用于翻译等需要候选搜索的任务;开放式对话和故事生成则经常使用采样来获得多样性。这个区别不是硬规则。扩大 beam 或取得更高的模型分数,并不保证生成结果更准确、更自然,仍需用具体任务的指标评价。
8. 选读:温度怎样影响概率对 logit 的敏感程度
本节是选读:前面选择解码参数不需要微积分,可以直接继续第 9 节。这里问的是“只把某个 logit 改动一点,输出概率会变多少”。导数衡量这种局部变化率; 在 时等于 1,否则等于 0。
还可以通过导数理解温度的作用。令 ,则:
对自身 logit 的导数是 。这里既有 ,也有随温度变化的概率,不能只看前者就断言“温度越低,梯度越大”。
在固定 logits 且最大值唯一时, 会使分布饱和为 one-hot,其中 以指数速度趋于零,足以抵消 的增长,因此导数也趋于零。若最大值并列,这个结论不再适用。 时,导数则因 趋于零。
这解释的是概率对 logits 扰动的敏感度。调整 Temperature 不会重新训练模型,也不保证概率能反映事实正确率。推理采样本身不需要计算这些梯度。
9. 实际任务中怎样选策略和参数
调参时可以从适合任务的基本策略开始,再逐项调整参数,便于判断每项设置对结果的影响:
| 目标 | 可以从哪里开始 | 需要额外检查 |
|---|---|---|
| 稳定、可复现的短输出 | Greedy | 停止条件、重复、事实或代码正确性 |
| 翻译等候选搜索 | 小规模 Beam Search | 长度评分、EOS 与任务指标 |
| 对话、多种表述 | Temperature + Top-P | 多样性、偏题、重复 |
| 限制候选数量 | 在采样中加入 Top-K | 是否剪掉罕见但正确的 token |
| 事实或科学回答 | 用任务验证选择解码参数 | 检索来源、计算核验,不能靠低温代替 |
例如 可以作为一组对照实验参数,但不是跨模型通用最优值。比较时固定 prompt、模型版本、长度限制和评价方法;采样应多运行几次并记录随机种子。即使不采样,跨硬件或不同 kernel 的数值差异也可能影响并列或近似并列的选择。
10. 小结:每种策略改了什么
| 策略 | 改变的对象 | 主要限制 |
|---|---|---|
| Greedy | 每步只选最高概率 token | 局部最优,不保证整段最优 |
| Temperature | logits 差距与概率分布的集中程度 | 正温度不改变排序,不保证正确性 |
| Top-K | 候选数量 | 固定数量不等于固定概率覆盖率 |
| Top-P | 候选的累积概率 | 在当前归一化分布上计算阈值 |
| Beam Search | 同时保留的候选路径 | 近似搜索,长度评分与停止规则很重要 |
解码策略决定如何使用模型给出的概率分布。组合采样时,需要记录各处理步骤的顺序和中间归一化方式,才能复现实验;评价生成结果时,则要分别检查模型概率、输出多样性和内容正确性,不能用其中一项代替其余两项。
参考资料
- Holtzman et al., The Curious Case of Neural Text Degeneration. ICLR 2020. Nucleus Sampling 与开放式生成
- Fan et al., Hierarchical Neural Story Generation. ACL 2018. Top-K Sampling 在故事生成中的应用
- Graves, Sequence Transduction with Recurrent Neural Networks. 2012. 不同模型中的 Beam Search 应用背景
- Hinton et al., Distilling the Knowledge in a Neural Network. 2015. Temperature 在知识蒸馏中的使用
- Vaswani et al., Attention Is All You Need. NeurIPS 2017
- Hugging Face Generation Strategies;本文参数说明对应 v4.57.1,后续版本请核对实际配置与源码
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。