0. 自注意力为什么需要位置信息
“我喜欢你”和“你喜欢我”用了相同的词,意思却不同。Self-Attention 需要知道 token 的顺序,不能只比较内容向量。
先回顾 query、key 和 value 的作用:query 表示当前位置想寻找什么,key 表示一个位置能用什么特征被匹配,value 是匹配后要汇总的信息。它们都是模型学习出来的向量,不是事先写好的语义标签。
例如,当前位置要从前面两个位置取信息,就先分别计算它的 query 与两个 key 的点积,再把两个分数转成总和为 1 的权重,假设是 0.7 和 0.3。输出就是两份 value 的 ;这里的权重仅用于示意。RoPE 修改的是计算匹配分数时的 query/key,并不直接选择输出 token。完整 Decoder 结构可延伸阅读 Transformer Decoder,下面会给出本文需要的记号。
每个 attention head 都有自己的 query、key 和 value,分别计算匹配分数并汇总信息;多个 head 可以并行工作。下面先分析单个 head。向量就是一列数,维数就是其中数的个数; 表示由 个实数组成的向量。上标 表示转置,把列变成行; 则把对应坐标相乘再相加。例如 与 的点积是 。
用列向量表示单个 token 的隐藏状态 ,省略投影的 bias:
这里 是从 0 开始的位置, 是模型隐藏向量的宽度, 是单个 head 的 query/key 维度。 是训练学到的投影矩阵:把 个输入坐标组合成 个输出坐标。 是本层还没有经过 RoPE 旋转 的向量;它们可能已经包含前面各层处理过的上下文。下面暂时固定这两个内容向量,简写成 。
它们的点积 是匹配分数的基础。实际 attention 还要除以 、加 mask,再对所有可见 key 做 softmax。因此,未经缩放的点积、softmax 前的 logit 和归一化后的权重分别对应三个计算阶段。
如果把一个长度为 的序列按行排成矩阵,则单个 head 的 ,分数矩阵 。矩阵的第 行、第 列,就是 query 对 key 的分数。小写表示一个向量,大写表示整批向量。
没有位置编码、位置相关 bias 或 mask,且忽略 dropout 的随机性时,Self-Attention 对 token 排列具有 permutation equivariance(置换等变性):输入换序,输出也按相同顺序换序,并不是输出矩阵完全不变。若 是换序矩阵,且 表示这样的 attention,则:
这说明它本身没有表达词序的机制。固定的 causal mask 会改变可见关系,因此不能把上述任意换序性质直接套在带 causal mask 的 Decoder 上。
RoPE(Rotary Position Embedding)的思路是:用位置决定旋转角度,旋转 query 和 key,再计算它们的点积。
1. 希望位置差怎样影响 Q 和 K 的点积
定义位置编码函数 和 ,分别把内容向量与位置变成新的 query/key。尖括号 也是点积记号; 暂时只是一个待构造的函数,不是另一个已经训练好的网络。我们希望:
也就是说,固定内容向量后,公式中单独加入的位置因素只依赖两个位置的差值。内容向量仍然参与计算,所以不同 token 即使具有相同的位置差,也可能得到不同的匹配分数。
二维旋转容易计算,也不改变向量长度,适合用来实现上面的要求。下面将证明 RoPE 确实符合相对位置条件,但这一条件并不能唯一确定 RoPE。RoFormer 论文的 第 3.1—3.2 节 给出了这一建模思路。
2. 先看二维向量怎样旋转
先在平面上画出两个从原点出发的向量,分别表示 query 和 key。让它们分别旋转 、,两个向量之间的有向夹角就增加了 。如果两个向量再多转相同的角度,它们的相对夹角不会改变。所以,虽然各自的旋转角度取决于绝对位置,比较两个向量时出现的是相对位置差。
这里 表示每前进一个位置转多少弧度。弧度是一种角度单位,转一整圈是 ,转四分之一圈是 。如果 ,位置 0、1、2 的旋转分别是 0、90、180 度。这里先分析一对坐标,后面再将同样的旋转应用到高维向量中的各个坐标对。
下面两小节用复数简写推导过程;不熟悉复数时,可以先从第 2.3 节的实数旋转矩阵读到第 5 节,核心算法与证明都在那里。
2.1 用复数表示二维向量与点积
把两个二维向量写成:
其中 ,此处直立的 是虚数单位,不是后面的维度对编号 。 是 query 的两个坐标,下标从 0 开始。 表示只取复数的实部,上面的波浪号表示“将两个实坐标合成一个复数”。复数只是把二维坐标换一种写法;对 key 取共轭,即把虚部的正负号反过来,就能表达原来的实向量点积:
2.2 位置乘以频率,就是旋转角度
选定 ,表示每前进一个位置旋转多少弧度。让 query 在位置 旋转 ,key 在位置 旋转 :
两者必须使用同一个频率 。相乘时,共轭把 key 的相位变成负号,于是:
位置只通过 出现。由于 的模长是 1,这个操作只改变方向,不改变向量长度。
2.3 二维旋转矩阵的推导
旋转矩阵会用到正弦和余弦两个三角函数。它们的几何含义是:在半径为 1 的圆上,从横轴正方向逆时针转过角度 ,圆上点的横坐标叫 (余弦),纵坐标叫 (正弦)。角度为 0 时坐标是 ,转过 时是 。
旋转矩阵可以由两个坐标轴方向的变化得到。 是旋转角,原来的横轴方向 旋转后是 ,纵轴方向 旋转后是 。任意向量 都是这两个轴方向的 倍与 倍之和,所以旋转后的坐标也可以按这个比例相加。
将这两个旋转后的轴方向作为矩阵的两列,就得到下面的 。如果读了复数部分,由欧拉公式 也能得到同一结果:
例如 ,旋转 后得到 ,旋转前后长度都是 。公式里的负号很重要:它决定旋转方向。
3. 证明:点积中的位置只剩下差值
下面的 是逆矩阵,作用是撤销 的变换,让坐标回到变换前;对旋转而言,就是转回相反的角度。二维旋转矩阵有两条性质:
第一条来自 ;第二条来自三角函数的和角公式。因此:
为什么复数形式是 ,矩阵形式却是 ? 因为共轭与转置分别作用在不同的写法里。令 ,展开同一个点积即可核对:
这个结果与复数形式的实部相同。如果把 换成 ,还需相应调整正弦项的符号。
手算一次,检查位置差和正负号
取 ,,也就是每个位置旋转 :
- 时,两个旋转角分别为 ,点积是
- 把两者同时向后移 10 个位置,,角度变成 ,点积仍是
- 两组位置都有 ,所以这个结果与公式一致
换成 、,仍取 ,点积为 。第二个例子能检验正负号,而只用余弦例子检验不出来。
一般地,对任意共同平移量 ,保持内容、频率不变,就有:
符号 表示向量的欧氏长度,也叫二范数:,即各坐标平方相加后开平方。旋转保持这个长度,所以 。对两个向量施加同一个旋转时,它们的点积也保持不变;但不同位置对应不同旋转,通常会改变两者的夹角和点积,即使各自的长度没有变化。
4. 为什么使用不同频率
单个二维旋转只提供一组周期信号。比如 弧度/位置,位置 63 的角度是 6.3 弧度,比 只多约 0.0168 弧度,所以它的位置旋转接近位置 0。
所以,单个频率在相隔很远的位置上,也可能产生相近的相位;但相位接近,不代表两个 token 的完整表示相同。对于整数位置,能否精确重复还取决于频率。“转过一圈”不等于一定存在一个恰好重复的整数位置周期。
RoPE 让不同维度对使用不同频率。本文采用原始 RoPE 的常见设置:
这里 必须是偶数。 是维度对的编号,不是 token 的位置; 是频率基数,并不直接等于模型支持的上下文长度。
- 小编号的维度对旋转快,相邻位置之间的相位变化较大
- 大编号的维度对旋转慢,相位变化覆盖更长的距离尺度
每一对的波长可写成 ,表示连续位置坐标上转一圈对应的距离。多种频率提供多种尺度,但不保证任意长度的外推效果。
5. 高维向量每两个数一组,分别旋转
把 维向量分成 对坐标,第 对为:
原图上半部分的灰色箭头把一对坐标带到二维平面:绿色向量按红色标出的 旋转,右侧得到新坐标。下半部分每一行是一个位置,绿色、粉色、橙色、蓝色的坐标对各用自己的频率;中间的位置编号改变时,右侧各对坐标随之转动。这里的 Query / Key 就是前面说的 Q / K。
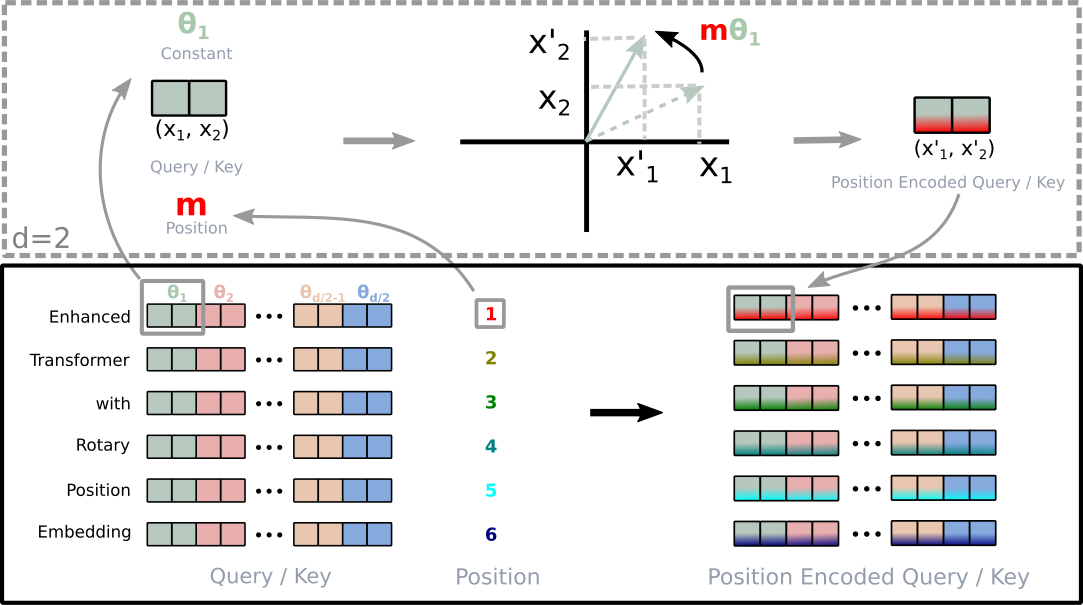
图:上半部分展示一对坐标随位置旋转;下半部分展示高维向量的各维度对采用不同频率。图中频率下标从 1 开始,正文从 0 开始,二者仅编号不同。原图:Jianlin Su 等,RoFormer,Figure 1,CC BY-NC-ND 4.0,未修改。 查看原尺寸图。
以下中文说明独立于原图,按位置对照阅读:
- 上方左侧坐标对 → 中央圆: 从 Query 或 Key 中取出两维,绿色向量按位置决定的角度旋转。旋转改变方向而保持该二维向量的长度。
- 上方红色弧线 → 右侧坐标对: 红色弧线标出位置与频率共同决定的旋转角,右侧是旋转后的两维。它不是给向量再加一份位置向量。
- 下方同一行的不同颜色: 每种颜色是一对维度,各对使用不同频率;同一位置下,各对旋转角可以不同。图中频率从 1 编号,本文公式从 0 编号,仅是下标习惯不同。
- 下方不同行 → 右侧各组圆: 行的位置编号变化,使同一频率对应的旋转角变化。随后 Q、K 做内积时,配对旋转的结构才使相对位置差进入分数,图本身并没有代替这一推导。
分别旋转这些二维向量,就得到分块对角矩阵:
“分块对角”表示各个二维旋转矩阵沿大矩阵的主对角线排列,每块只作用于对应的两维。以 为例,记 、:
取 ,两组频率是 和 。向量 变成:
它的长度仍为 。一对转得快,一对转得慢,互不混合。
为什么高维仍满足相对位置条件?因为点积可以按坐标对分组求和:
每项都只包含相对位置,所以总和也如此。这是确定性的恒等式,不需要向量分量独立,也不需要任何概率分布假设。
本文把整个 head 的 维都旋转。若模型只旋转其中偶数个维度,就对那部分使用旋转,对其余维度保持原值;需要按该模型的 rotary dimension 和配置来生成频率,不能直接照搬完整 head 的参数。
6. 距离越远,注意力分数就越低吗
不一定。旋转不会缩短向量;它不保证任意一对 query/key 的分数随距离增大而降低,更不保证 softmax 后的注意力权重单调降低。
RoFormer 第 3.4.3 节 使用复数和的变换与上界来讨论长距离行为。下面用一个例子说明不同频率的项怎样相互抵消。例子需要额外的统计假设,不能直接当成真实 attention 一定具备的性质。
下面的统计推导可以选读。实现 RoPE 并不依赖这些假设,只需注意:相对位置恒等式本身无法保证分数随距离增大而减小。推导中, 表示对随机向量重复取样后的平均值;二阶矩是两个坐标乘积的平均值,有限表示这个平均量有定义且不发散。
6.1 先假设 Q 和 K 的各坐标有怎样的关系
把 看作有有限二阶矩的随机向量。设它们满足:
这一条件描述 query 与 key 的交叉二阶矩。只有在相应均值项为零时,它才与协方差一致。
一个充分例子是 ,且 的每个分量均值为 0、方差为 1,不同分量不相关。独立也能保证这里的不相关,但要求更强。
这个例子是充分条件,不是必要条件。例如 、,其中 满足上述条件,两个噪声都零均值,并且与 及彼此独立,也能满足同样的交叉二阶矩条件,而不必有 。
真实模型通常有 ;同一个 token 的 query 与 key 也通常不同。反过来,如果 query 与 key 相互独立且都为零均值,则 ,此时点积期望处处为 0,得不出下面的余弦曲线。
6.2 在这个假设下,点积平均会是多少
令 ,第 对坐标取 。由二维展开式:
对角项期望为 1,交叉项期望为 0,因此:
除以零距离处的值 ,可以得到便于比较维度的曲线:
这里归一化的是假设下的原始点积期望,不是经过 softmax 的注意力权重。不同频率在零距离时对齐,距离变大后可能相互抵消。在常见维度与有限观察区间内,这能表现出带振荡的衰减趋势。有限个余弦之和不必单调,也不能据此断言它随距离趋于无穷而收敛到 0。
最小的反例是 ,此时 。整数距离 3 时约为 ,距离 6 时又回升到约 。更远的位置完全可以得到更大的点积。
原论文中的“远程衰减”图也需要连同纵轴含义一起读:
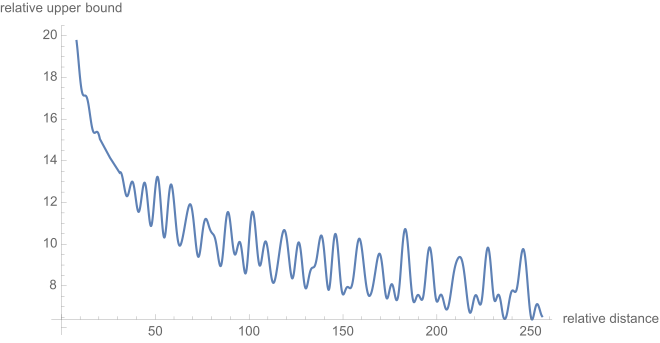
图源:Su 等,RoFormer,第 3.4.3 节及图 2(原图,CC BY-NC-ND 4.0,原样引用,未加图内标注或重画曲线)。

- 横轴是相对距离。 可见区间内有总体下降趋势,同时存在许多回升,因此不能读成“每远一步必定更低”。
- 纵轴是论文推导里的相对上界项。 论文先用 Abel 变换给复数内积的模作上界,再考察其中由旋转频率决定的部分;它不是某个训练好的模型测得的注意力权重,也不是上文在特定二阶矩假设下定义的 。
- 实际点积还有内容因素。 上界分析包含 query/key 相关的系数;只看这条频率曲线,不能断言任意两段内容的真实分数都随距离下降。下面把这个内容因素显式写出来。
6.3 如果 Q 和 K 不满足前面的假设
若写 ,不再要求它等于单位矩阵,就有:
这说明期望也取决于 query 与 key 的统计关系。上面的单位矩阵条件只是一个方便的充分条件,甚至不是得到同一条余弦期望曲线的唯一条件。若比较不同距离时 自身也变化,还必须把这种内容变化计算在内。
计算 attention 权重时,还需要将当前 key 的分数与其他可见 key 一起归一化:
是 query 能看见的 key 集合,假设它非空。一般也不能把分数的期望先代进 softmax,当作权重的期望。RoPE 让位置参与了计算。模型最终更关注近处还是远处,还要看 query/key 的内容和 mask 允许访问的位置。
7. 用 PyTorch 实现旋转,传入正确的位置编号
代码按以下四步实现前面的公式:inv_freq 保存每对的 ;angles 用位置乘频率;even、odd 分别取每对的第一、第二坐标;最后两行按照旋转矩阵组合,再把两坐标交错放回原处。unsqueeze 只增加一个长度为 1 的轴,便于同一组角度广播到多个 head,不会增加新的位置信息。
下面实现相邻坐标配对的完整 head 旋转。输入 shape 为 (batch, seq_len, heads, dim);position_ids 可以是全 batch 共用的 (seq_len,),也可以是每条序列各自的 (batch, seq_len)。
这里直接按 position IDs 计算 sin/cos,避免把长度为 4096 的整张表误广播到只有几个 token 的输入。工程中可预计算并按 position IDs 取表。RoFormer 的官方示例使用成对坐标变换;Meta 的官方 Llama 实现使用等价的复数乘法。
import mathimport torch
def apply_rope(x: torch.Tensor, position_ids, base: float = 10000.0): # x: (B, S, H, d); adjacent coordinates form a pair. if x.ndim != 4 or not x.is_floating_point(): raise ValueError("x must be a floating tensor with shape (B, S, H, d)") B, S, H, d = x.shape if d == 0 or d % 2 != 0: raise ValueError("rotary dimension must be positive and even") if not math.isfinite(base) or base <= 0: raise ValueError("base must be finite and positive")
pos = torch.as_tensor(position_ids, device=x.device) if pos.dtype not in (torch.int32, torch.int64): raise ValueError("position_ids must contain integers") if pos.shape == (S,): pos = pos.unsqueeze(0).expand(B, -1) if pos.shape != (B, S) or (pos < 0).any().item(): raise ValueError("position_ids must have shape (S,) or (B, S), and be >= 0")
# Avoid computing large position angles directly in FP16/BF16. work_dtype = torch.float64 if x.dtype == torch.float64 else torch.float32 pair_index = torch.arange(0, d, 2, device=x.device, dtype=work_dtype) inv_freq = base ** (-pair_index / d) # (d/2,) angles = pos.to(work_dtype)[..., None] * inv_freq # (B, S, d/2) cos = angles.cos().unsqueeze(2) # (B, S, 1, d/2) sin = angles.sin().unsqueeze(2)
even = x[..., 0::2].to(work_dtype) # (B, S, H, d/2) odd = x[..., 1::2].to(work_dtype) out = torch.stack((even * cos - odd * sin, even * sin + odd * cos), dim=-1) return out.flatten(-2).to(x.dtype) # (B, S, H, d)
# A small MHA example; q and k are already projected.B, S, H, d = 2, 4, 3, 8q = torch.randn(B, S, H, d)k = torch.randn(B, S, H, d)position_ids = torch.arange(S, device=q.device)q_rotated = apply_rope(q, position_ids).transpose(1, 2) # (B, H, S, d)k_rotated = apply_rope(k, position_ids).transpose(1, 2)logits = q_rotated @ k_rotated.transpose(-2, -1) / math.sqrt(d)# logits: (B, H, S, S); mask, softmax, and value aggregation follow.这段教学代码只计算旋转和 logits,不包含 mask、softmax、value 汇总或完整 KV Cache。它使用相邻配对 (0,1), (2,3), …;有些实现把前后两半配对。两者可以通过一致的坐标重排对应,但不能只换旋转函数、不调整已有模型的权重和布局。
若 query 有 个 head,key 有 个 head,旋转函数可以分别处理它们。但上面最后的直接矩阵乘法以相同 head 数的 MHA 为例;GQA/MQA 还需要正确映射 query head 与 KV head。
这段 PyTorch 示例尚无运行、梯度或 GPU 测试结果。运行时可用前面的手算例子核对旋转方向,并检查旋转前后范数以及共同平移位置后的点积是否在浮点误差范围内一致。
8. 用 KV Cache 生成时,新 token 的位置怎么编号
KV Cache 是生成时保存以前各位置 key 和 value 的缓存。新位置只需计算自己的 query/key/value,再用新 query 读取旧 key/value,避免每一步重算整段前文。它缓存的是模型中间结果,不是以前输出的概率表。
假设缓存已经包含位置 0 到 99 的 100 个 token。位置 99 的输出先预测位置 100 的 token;把这个新 token 送入下一次前向时,它的新 query 和 key 应使用位置 100,而不是因为这一轮只输入一个 token 就重新编号为 0。
对于连续的新片段,可以这样构造位置:
past_len = 100new_len = 1position_ids = torch.arange(past_len, past_len + new_len, device=q.device)常见实现会将已经按各自位置旋转过的 key 放入 KV Cache。后续生成时,只给新增的 query/key 使用正确位置,再让新 query 与缓存 key 计算分数;不要把缓存 key 当成未旋转向量,再按它的绝对位置旋转一次。value 通常不做这里的 RoPE 旋转。
例如位置 100 的 query 与位置 97 的 key,对应 。若错误地把新 query 标成位置 0,它们的位置差就变成 。因此,复用缓存时仍需要正确设置新 token 的位置坐标。
左 padding、不同长度的 batch、滑动窗口或多段样本拼接,会让“缓存槽位编号”和“模型计算旋转时使用的 position ID”不再总是一回事:
- 每条序列的 position IDs 必须与它的有效 token 和缓存约定一致,不能一律拿 batch 的 padded 长度当偏移
- padding 位置可用无害的占位 ID,但仍需正确的 attention/loss mask;位置编号不会自动遮蔽 padding
- 拼接独立样本时,仅重置 position IDs 不会阻止样本之间相互 attention,还需要相应的 mask
- 若主动平移一整段缓存的位置坐标,必须让相关 query/key 保持同一个坐标系;只改新 token 的编号不能维持相对位置
缓存细节可以继续读 推理显存:KV Cache 与 Attention。
9. 小结:怎么算 RoPE,使用时检查什么
RoPE 的计算可分为四步:
- 把一个 head 的向量按两维一组配对
- 给不同维度对设置不同的旋转频率
- 用 token 的 position ID 决定每一对的旋转角度
- 旋转 query/key 后再做点积,得到内容与相对位置共同决定的分数
核心恒等式是 。它解释了相对位置,也解释了为什么生成时必须保持正确的位置偏移。
RoPE 并不是唯一能表示相对位置的方法。它不改变向量长度,但不同位置旋转的角度不同,所以点积和注意力分数仍会改变。前面的统计例子会出现振荡,真实 attention 也不保证随距离单调下降,能够计算更大的位置编号也不足以证明模型具备相应的长上下文能力。
沿主线继续读 Decoding:如何选下一个 token。如果想进一步理解位置与频率的调整,可选读 长上下文扩展:PI、NTK-aware 与 YaRN。完整阅读路线见 LLM 知识地图。
参考资料
- Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding,arXiv:2104.09864,初稿 2021。本文参考其相对位置目标和旋转构造;统计例子另行说明了假设
- ZhuiyiTechnology. RoFormer 官方实现说明,相邻维度配对与 sin/cos 写法
- Meta. Llama 官方 model.py,
precompute_freqs_cis、apply_rotary_emb与缓存位置处理 - Vaswani et al. Attention Is All You Need,NeurIPS 2017,scaled dot-product attention 与多频率位置编码
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。