阅读顺序:基础:编码、误差与分组 → 进阶:GPTQ / AWQ 推导 → 部署检查。初学时,读完基础部分即可继续 SFT;进阶部分需要矩阵和二次型,按需读。
0. 为什么 7B 模型的权重能从 14 GB 变成 3.5 GB
一个恰好有 个参数的模型,如果每个参数用 BF16 存储,权重数据就是 bytes;如果每个参数改用 4 bit,理想的权重编码只需 bytes。
用更少的位数存储权重,可以节省空间。但这也带来两个问题:少了这么多 bit,原来的数怎么表示?模型的输出会变多少?
本文先介绍回答这两个问题所需的基础,再在进阶部分推导 GPTQ 的误差补偿和 AWQ 的通道缩放。若想先看显存除了权重还存什么,可以读显存基础。
1. bit、byte 和数字格式
1.1 几个 bit 能表示多少个数
1 bit 只有 0、1 两种状态,8 bits 组成 1 byte。 bit 总共有 种位模式;这些模式代表什么数,由编码格式决定。
| 格式 | 位数 | 常见解释 |
|---|---|---|
| 无符号 4-bit 整数 | 4 | 到 |
| 有符号 INT4(补码) | 4 | 到 |
| 有符号 INT8(补码) | 8 | 到 |
| FP16 | 16 | 1 位符号、5 位指数、10 位小数部分 |
| BF16 | 16 | 1 位符号、8 位指数、7 位小数部分 |
| FP32 | 32 | 1 位符号、8 位指数、23 位小数部分 |
例如 1101 在无符号编码中是 ,在 4-bit 补码中是 。同一组 bit,因为解释规则不同,可以表示不同的数。
浮点数用符号、指数和有效数字共同编码,因此刻度并不均匀。BF16 与 FP32 的指数位数相同,数值范围接近,但 BF16 的有效数字更少;FP16 的有效数字比 BF16 多,指数范围却小得多。
**BF16 共有 种位模式。**其中还包含正负零、无穷和 NaN 编码,因此可表示的不同有限实数还少于 65536 个。4-bit 编码有 16 种,但每组权重可以使用自己的 scale,因此同一个整数编码在不同组里能表示不同的数,而非全模型只能共用 16 个实数。
1.2 BF16 与 INT4 的权重大小对比
本文用十进制单位: bytes;而 bytes。
这里把两个 4-bit 编码打包进一个 byte,而且暂时没有计算 scale、zero-point、对齐开销和未量化层。实际推理还要保存 KV Cache、激活和工作区,所以不能由“权重编码压到四分之一”推出“总显存也压到四分之一”。
2. scale:整数相差 1,原来的数相差多少
假设某组权重都很小,直接把它们舍入成整数,会把很多不同的值变成 0。对这组数据来说,整数的刻度间隔 1 太粗了。
我们可以约定:整数编码相差 1,实际数值只相差 。这个正数 就是 scale,也就是量化步长。本文用 ,避免在后半的 AWQ 推导中和通道缩放系数混淆。
先采用严格对称的整数范围 。例如 4-bit 存储可使用 ,舍弃 这个编码;8-bit 可使用 。这是一种便于讲解的约定,不代表所有有符号量化格式都舍弃最小整数。
定义 ,那么:
- 是原始权重, 是存储的整数编码
- 是反量化后用于表示这个权重的近似值
- round 选择最近整数,clip 保证编码没有超出位宽允许的范围
在恰好位于两个整数中间时,舍入规则需要约定。例如 NumPy 的 rint 使用 ties-to-even;下面的例子不涉及恰好落在中点的情况。
2.1 手算一次 INT8 量化和反量化
取一组权重 ,使用严格对称 INT8,令:
| 0.1 | 10.583333 | 11 | 0.103937 | +0.003937 |
| -0.3 | -31.750000 | -32 | -0.302362 | -0.002362 |
| 0.7 | 74.083333 | 74 | 0.699213 | -0.000787 |
| -0.9 | -95.250000 | -95 | -0.897638 | +0.002362 |
| 1.2 | 127.000000 | 127 | 1.200000 | 0 |
数值没有完整保留,但都还在原值附近。这里没有截断,所以绝对误差不超过 。
2.2 覆盖最大值,为什么未必误差最小
上面的 是避免范围截断的简单办法。若有极少数离群值很大,它们会把整组的刻度拉粗;缩小覆盖范围、允许这些离群值被截断,有时反而能降低总体误差。
若只关注权重均方误差,可以在候选步长中比较:
这里的 是这组待量化数的数量。实际还可以使用分位数、直方图或层输出误差来选范围。min-max 是一种范围校准策略,不是对所有分布都成立的 MSE 最优解。
全零张量需要单独处理:可取约定的正 scale,再把所有编码设为 0,避免出现 。
3. zero-point:用哪个整数编码表示零
如果待量化数主要落在正半轴,严格对称的编码会空出很多负刻度。非对称仿射量化允许移动原点,用整数 zero-point 表示实数 0:
若要求实数 0 可以精确表示,先把校准范围扩展到包含 0:
当 时,一种常用选择是:
例如使用无符号 4-bit 编码 ,表示区间 ,则 、。编码 0、5、15 分别表示 、0、2; 编码为 7,反量化为 0.4。
这个例子恰好对齐了两个端点。一般情况下 需要取整,端点只能近似对齐;“同时精确表示两个端点和零”并不是无条件成立的。全零输入仍需特殊处理;非零常数在扩展到包含 0 后,范围则不再退化。
对称量化的 可以隐含;非对称格式可能需要保存 ,也可能把相关计算融合进 kernel。具体速度不能只凭“多了一个减法”判断。权重和激活都可能采用对称或非对称方案,要同时看分布、格式和硬件支持,不能把“权重一定对称、激活一定非对称”当成规则。PyTorch 的 observer 实现展示了这类参数计算和边界处理。
把 scale 和 zero-point 放到同一组数轴上看。黑色标记表示反量化后的实数位置,蓝色标记表示整数编码;下图来自 Qualcomm AI Research 的量化白皮书,采用 8-bit 示例,刻度线只是示意,没有画全 256 个编码。
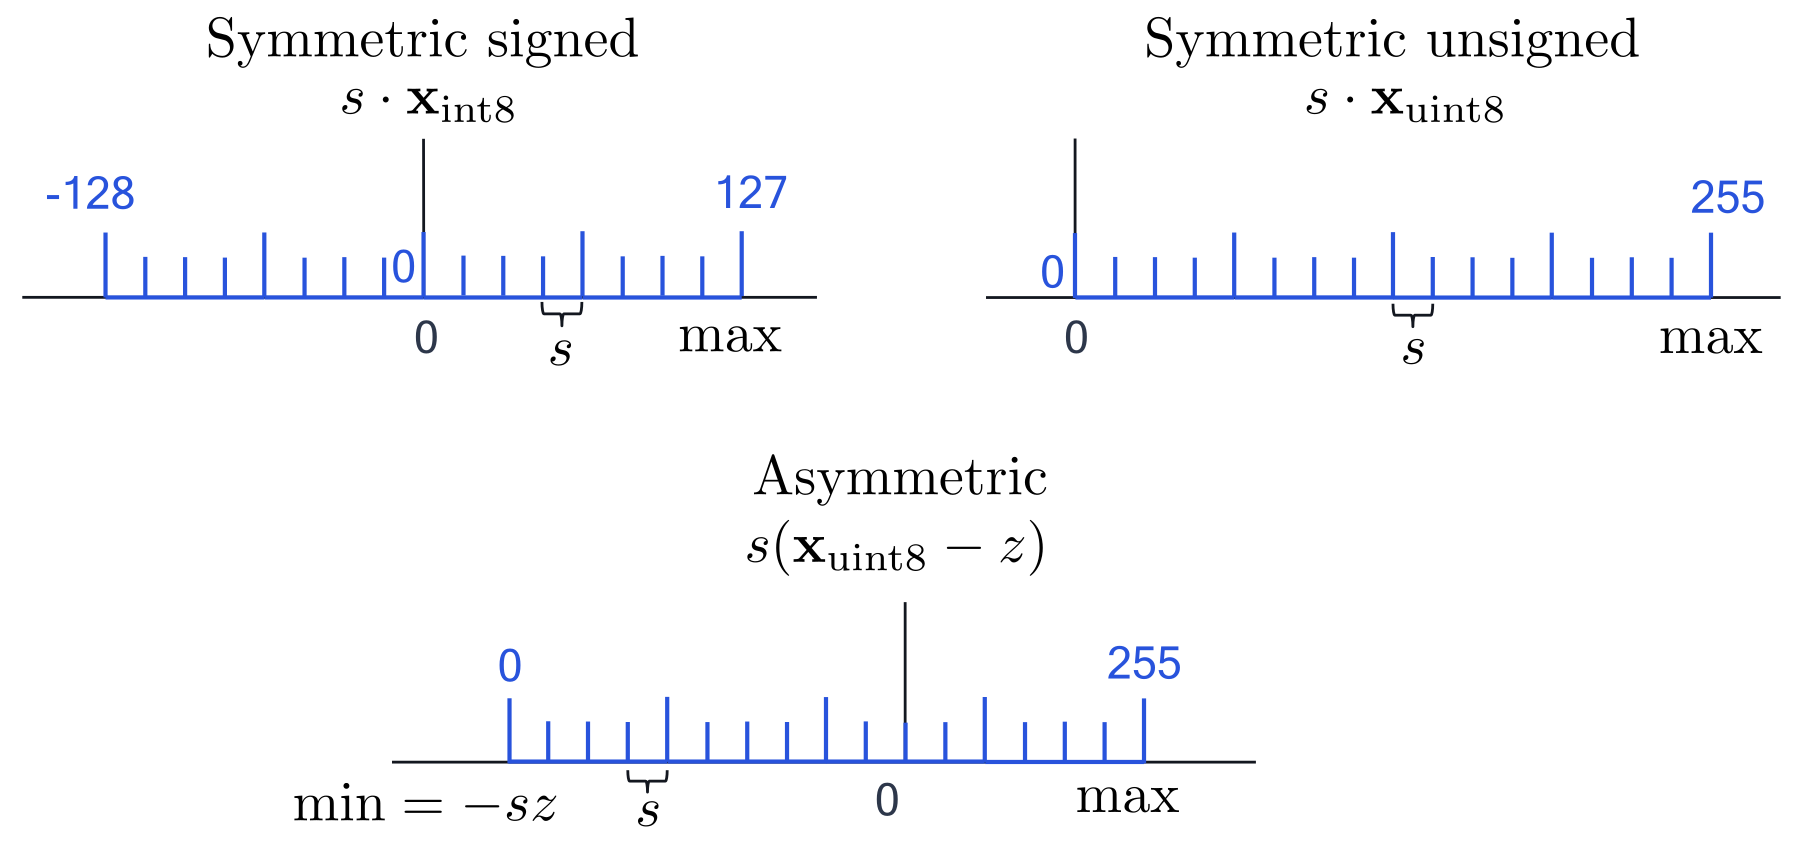
原图内容未改动:Markus Nagel 等,A White Paper on Neural Network Quantization,Figure 3(CC BY 4.0);原始 SVG。
- 相邻实数刻度间距是 :对应本文的 ,不是它的倒数;相邻整数编码仍相差 1。
- 左上采用完整有符号区间 :因此端点并非严格关于零对称。本文前面的严格对称算例使用 ,两种约定不要混算。
- 右上从零覆盖非负范围:图中称它为 symmetric unsigned,这里指不加零点偏移的无符号方案,不意味着非负区间关于零对称。
- 下图将编码 对齐实数零:蓝色编码 0 对应实数 ,蓝色编码 255 对应 。改变 是平移编码与实数的对应关系,不能增加编码总数。
4. 舍入误差、截断误差和输出误差
4.1 误差什么时候不超过半个步长
在表示范围内,最近舍入的误差满足:
一旦发生截断, 就不再是总误差上界。例如 、 时, 被截到 0.7,误差是 0.3,明显大于 0.05。
也可以先把 截到可表示的实数端点,得到 ,再拆成:
第一项是范围内的舍入误差,第二项是截断误差。减小步长会改善第一项的上界,但可能加重第二项。
例如步长为 0.1、编码范围为 −7 到 7 时,0.34 舍入到 0.3,绝对误差是 0.04;1.0 则超出可表示范围,被截到 0.7,绝对误差是 0.30,已经超过半个步长。
4.2 权重量化后,层的输出会变多少
对线性层,设 、输入 ,输出 。权重量化后的输出差为:
同样大小的权重误差,遇到更大的输入激活会造成更大的输出变化;不同项也可能抵消或叠加。因此,不能只看权重大小或相对误差,就断言某个权重是否重要。
用两个输入分量计算一次:某一行权重误差为 。输入是 时,输出误差为 ;输入换成 时,误差变成 。权重的近似误差没有变化,但输入不同,输出误差也不同。这里的「激活」就是模型运行时得到的中间数值,不是另一套可训练权重。
这也解释了为什么量化方法需要校准数据:它提供了“这一层通常收到什么输入”的信息。校准误差小仍不代表所有任务都无损,最终还要比较目标任务质量。
5. 量化粒度:哪些权重共用 scale 和 zero-point
设线性层的权重布局仍是 :
| 粒度 | 本文采用的约定 | 主要取舍 |
|---|---|---|
| Per-tensor | 整个矩阵共用一组量化参数 | 元数据少,但容易受全局范围影响 |
| Per-channel | 每个输出通道,即每行,共用一组参数 | 可以适应各行的范围差异 |
| Per-group | 每行沿输入维,把连续的 个权重分一组 | 范围通常更局部,但元数据更多 |
使用“channel”时,需要说明对应矩阵的哪一维。这里 per-channel 指输出通道,对应矩阵的行;AWQ 缩放的是输入通道,对应矩阵的列。
把分组划得更细,可以提供更多调整空间。但误差和速度还受校准方法、元数据精度和 kernel 支持的影响,并不一定随着分组变细而改善。group size 也不是 GPTQ 或 AWQ 里固定不变的常数。
假设每组有 个权重,权重编码占 bit,scale 和 zero-point 分别占 、 bit,忽略尾组与对齐时:
例如 INT4、、每组仅存一个 FP16 scale,则平均为 bit/weight,比纯 INT4 编码多 12.5%。如果同样把 个参数全按此格式量化,就是约 3.9375 GB;若还存 zero-point、其他参数或未量化层,体积会继续增加。
6. 量化哪些数据,什么时候量化
先区分三个对象:
- 权重量化减少模型参数的存储和读取量
- 激活量化改变层间或算子内部激活的表示
- KV Cache 量化减少生成过程中缓存的 Key/Value,占用仍随 token 数和并发变化
W4A16 通常表示 4-bit 权重、16-bit 激活,不意味着 KV Cache 自动变成 4 bit,也不说明所有算术都用 INT4。低位权重可能在融合 kernel 内分块解码为浮点再计算;累加精度由具体实现决定。反量化可以按计算需要分块进行,不必加载时就把整个模型还原为 BF16 并一直保留。后一种做法会让权重重新占用大量显存。
再区分量化发生的阶段:PTQ(Post-Training Quantization)从已有模型出发,使用统计量、校准或误差补偿;QAT(Quantization-Aware Training)则在训练中考虑量化的影响。GPTQ 和 AWQ 是两条重要的 PTQ 路线,算法名字本身不规定最终文件格式、所有层的精度或推理速度。
部署时至少检查:位宽与粒度、scale/zero-point 格式、哪些层未量化、激活与累加精度、KV Cache dtype,以及目标引擎是否真的支持这个量化产物。质量和速度都需要实测,不能只从“INT4”三个字推断。
7. GPTQ 和 AWQ 怎样减少输出误差
有了编码、scale、zero-point、舍入和截断的概念,接下来要问:怎样让近似权重产生的层输出尽量接近原输出? GPTQ 允许未处理权重补偿已量化权重的误差;AWQ 则用通道缩放改变重要输入通道的有效刻度。
8. 用矩阵写出线性层的输出误差
这部分介绍数学推导及其实现条件。算法在不同模型、硬件和数据上的效果,仍需通过测试比较。以下校准输入固定,bias 若不参与量化则保持不变。
8.1 权重和输入矩阵的行列分别表示什么
考虑一个线性层,忽略不变的 bias:
是输出维度, 是输入维度, 是收集的校准 token/样本向量数。每个校准向量是 的一列。若代码把输入存成 ,那么对应的 Gram 矩阵应写为 X.T @ X,不能直接照搬本文的矩阵方向。
沿用基础部分的记号: 是整数编码, 是反量化后的近似值; 是该组的 scale。下面优化的是层输出误差,不能只看每个权重的独立舍入误差。
下面的 和 GPTQ 伪代码里的量化列,都表示反量化后的数值,可直接与浮点权重比较。
8.2 为什么要比较输出,而不只比较权重
第 4.2 节已经用单个输入说明权重误差如何传到输出。现在把多个校准输入并成矩阵 ,GPTQ 对整组输出使用重建目标:
是量化网格允许的矩阵集合;Frobenius 范数平方就是把所有输出元素的误差平方后相加。这里没有除以 ,除以 也不会改变最优解,但会改变 Hessian 的整体比例。
这是给定校准输入下的局部层目标,不是整网的训练 loss,也不等于所有生成结果都保持不变。校准数据应覆盖部署输入;是否降低模型质量,仍要用目标任务验证。
9. GPTQ 的逐权重量化与误差补偿
9.1 把输出误差展开,得到 Hessian
取 的一行,转写成列向量 ,令权重扰动为 。这一行输出的重建误差为:
是这个层重建问题的 Hessian,大小为 。它的对角线反映输入通道的平方幅值,非对角线反映通道之间的相关性。
可以先不用「Hessian」这个名称来读式子。若只有两个输入通道,展开误差得到
首尾两项分别计算只改动一个权重时的误差;中间项说明两个权重的误差可能互相补偿。把这些系数排成矩阵就是 (Gram 矩阵)。对这个误差先求一次导数得到梯度 ,再求一次导数得到 ,所以称为 Hessian,即二阶导数矩阵。这里的「相关性」指输入乘积之和,没有减均值,严格说不是统计学的相关系数。
**对固定 的线性层,这个二次式是精确的。**不需要假设整个神经网络已经训练到梯度严格为零,也没有构造全模型 loss 的巨大 Hessian。
9.2 为什么要加 damping
当校准输入不足、某些通道没有被激活或通道高度相关时, 可能奇异或病态。奇异表示有些方向无法由校准数据区分,矩阵没有逆;病态表示接近这种情形,小的数值误差也可能使求出的补偿剧烈变化。常见做法是在对角线上加一个小的正数:
这里 是与 同尺寸的单位矩阵,所以 只给对角线加上 。正定表示对任意非零向量 都有 。因为 半正定,加上严格为正的 后,矩阵在精确算术下可逆,也满足 Cholesky 分解的正定条件;有限精度下仍要关注数值稳定性。
从目标看,相当于在该二次问题中加入 ,避免在校准数据未充分约束的方向上做很大的补偿。原始 GPTQ 实现把 damping 设为平均对角值的一定比例,并对未激活通道另作处理;它不是一个对所有模型都最佳的固定常数。
下文假定使用的 Hessian 正定。若整个校准矩阵都为零,仅取“平均对角值的百分比”仍会得到零,需要单独处理,否则 Cholesky 分解仍可能失败。
9.3 固定一个权重后,其他权重该怎么补偿
直觉上,我们要把第 个权重固定到网格点 ,但其他未量化权重仍可移动。设当前还可以调整的权重下标构成集合 ,当前权重已是此前约束下的连续最优点。于是新增补偿满足:
这里 , 是选取当前坐标的单位向量, 是必须完成的改变量。注意 一般不等于完整 的同名子矩阵。
例如自由权重只剩两项,固定第一项时 ,约束 就是「第一项必须改动 ,第二项自由」。 不是一层的新参数,而是尚可调整的下标集合;某个权重量化固定后,就从这个集合移除。下面用 Lagrange 乘子把“必须满足的条件”并入目标,求得其余权重应该怎样一起移动。
引入一个 Lagrange 乘子 :
求导并令其为零:。记 ,先解出乘子,再代回约束。
具体代入过程是:先由梯度为零得到 ;取第 项得到 ,因此 。再代回整个向量,便得到下面的补偿式。符号 表示第 列的所有行。
如果 ,这就是 OBS 剪掉一个权重时的形式;如果 是量化网格点,就是 OBQ 使用的推广。分母体现允许其他坐标补偿后的有效曲率,但重要性还取决于分子里的量化距离,不能只比较 就给所有权重排好序。
一个两维例子能看出补偿在做什么。取:
第一个权重必须增加 0.4,最优扰动是 ,所以临时权重变为 。二次代价是 0.12;若只改第一个权重、第二个不动,代价是 0.16。这里展示的是一次约束更新,第二个权重之后还要量化,此时还没有得到全部量化后的模型。
9.4 GPTQ 怎样减少计算量
对大语言模型逐行、逐参数进行贪心选择,并反复更新逆矩阵,计算开销很大。GPTQ 的主要改进可以理解为:
- 各输出行共用一个列处理顺序,复用同一份输入二阶信息;也可先按激活统计量排列列,再沿该顺序处理
- 同一块内仍顺序量化和补偿,块外的权重补偿暂存起来,最后用矩阵乘法一起做
- 预先计算逆 Hessian 的 Cholesky 因子,把逐次消元所需的信息存下来,避免反复显式更新逆矩阵造成的数值问题
块内各列仍须依次处理:量化后面的列之前,要先应用前面各列产生的补偿。所谓批量更新,指的是推迟并合并块外的更新,而非让块内各列独立舍入。GPTQ 论文第 3、4 节给出了目标、OBQ 更新和这些实现改进。
10. GPTQ 的 Cholesky 分解与逐列更新
10.1 为什么这里用上三角因子
令:
注意分解对象是逆 Hessian。如果库默认返回下三角 ,满足 ,那么这里取 。
Cholesky 分解可以看成正定矩阵的「矩阵平方根」,只不过要用三角矩阵及其转置相乘。这里先算好三角因子,后面就能按列取出补偿需要的数。为什么固定一列后不能直接删除逆矩阵的一行一列?把第一列与剩余坐标分开写成
由 得 、、。固定第一坐标后,剩余 Hessian 的逆是 ,而不是 。这项相减消除了第一坐标已经不能再参与补偿的影响。重复这个过程,就得到下面的右下角子块公式。
依次固定第 列后,剩余坐标的逆 Hessian 等于:
于是 ,而这一阶段的首行满足 。代入上一节的约束最优式,得到当前列产生的误差和补偿:
右边是一个列向量和一个行向量的外积。更新当前列时,减掉的正好是 ;更新后续列时,则按补偿公式调整尚未量化的权重。不能拿下三角因子的第 行直接代入向右更新,因为它右侧元素都是零。
先对照作者的列块图,区分“当前列”“当前块”和“块外剩余列”。
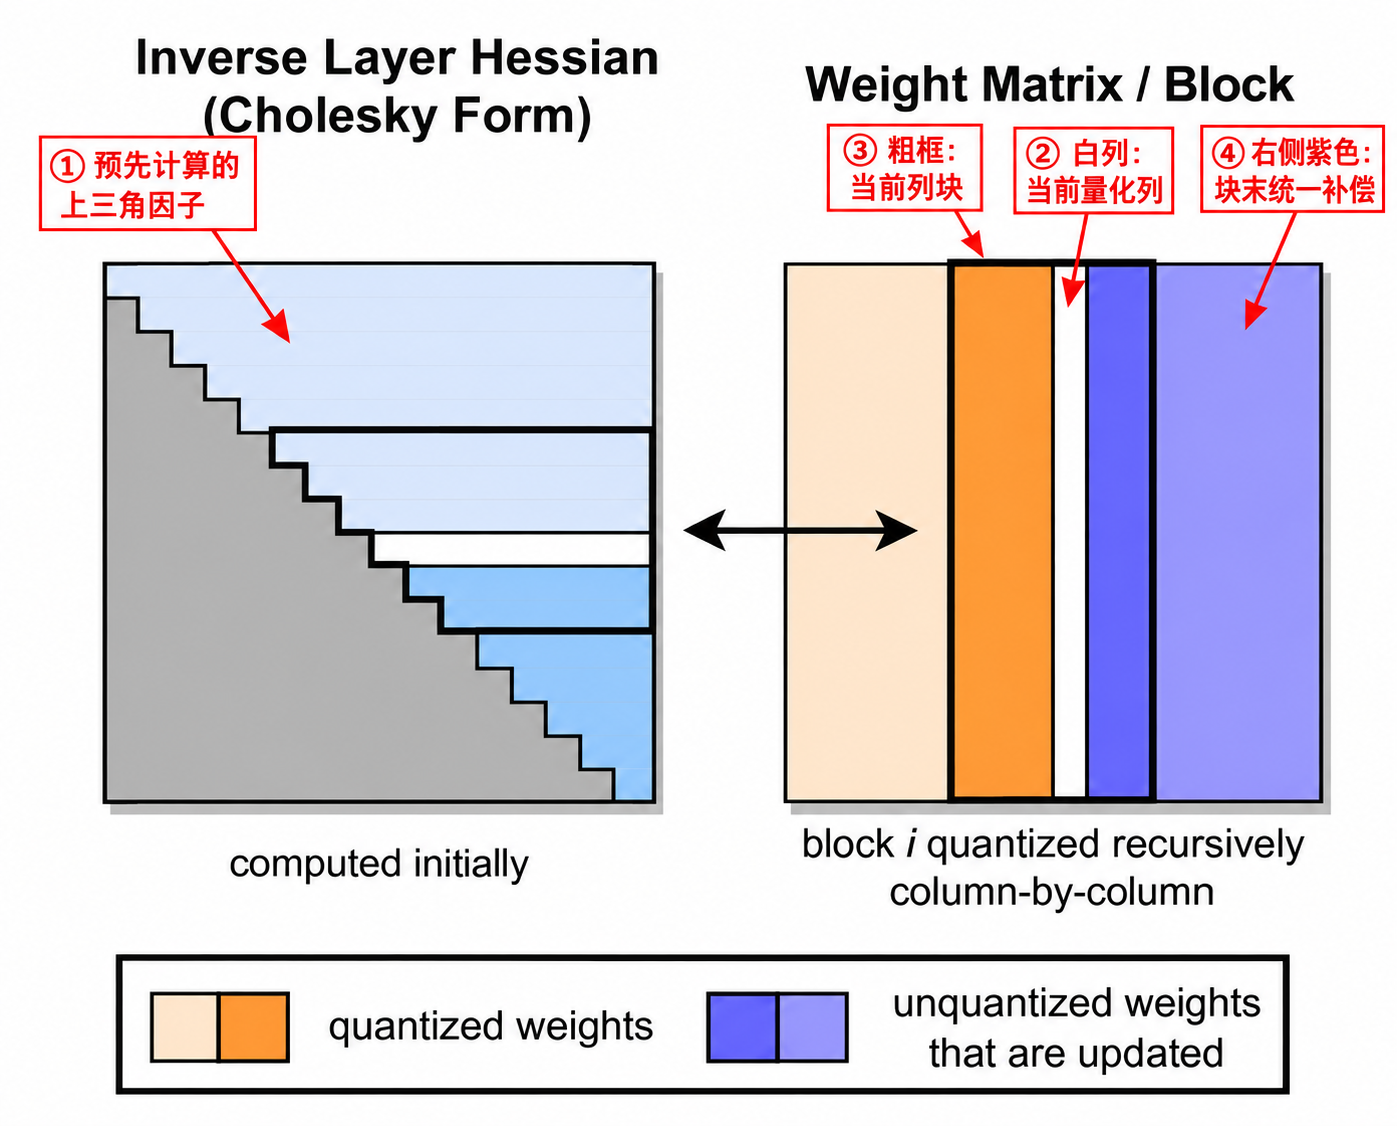
来源:Elias Frantar 等,GPTQ,Figure 2(CC BY 4.0);中文为辅助标注;原始 SVG。
- 左侧不是原始 Hessian:标题中的 Cholesky form 指预先计算的逆 Hessian 三角因子,对应本文 ;灰色下三角不是另一组待量化权重。
- 白色窄列是当前列:右侧米黄、橙色区域已经量化;白列定下来以后,需要先补偿同一粗框内尚未量化的紫色列,才能继续处理下一列。
- 粗框外浅紫区域可以稍后更新:收集当前块的误差后,在块结束时用矩阵乘法统一补偿。它不是独立舍入,也不是把整个粗框一次量化成同一个值。
- 示意图不规定块宽:实际
blocksize是实现参数;矩形宽度不代表量化误差或显存占比。
10.2 按列执行 GPTQ:伪代码
下面省略分组参数重估、列重排、死通道处理和块更新,保留数值逻辑。Q_j 返回第 列在对应量化网格上的反量化值:
输入 W: m×n, X: n×N;选好量化网格和正的 dampingH = 2 * X @ X.T + lambda * IG = inverse(H)R = cholesky(G).T # 默认 cholesky 返回下三角W_work = copy(W)for j = 0, ..., n-1: W_quant[:, j] = Q_j(W_work[:, j]) err = (W_work[:, j] - W_quant[:, j]) / R[j, j] W_work[:, j:] -= outer(err, R[j, j:])返回 W_quant这里显式写 inverse 是为了对照数学定义;实现可先对 分解,再用 Cholesky 求逆等数值例程。原始 gptq.py先构造逆矩阵,再调用 cholesky(..., upper=True),其归一化误差除以的是这个上三角因子的对角值。
实际按列块处理时,块内执行同样的顺序更新;收集该块的归一化误差矩阵 后,再做:
这延迟的是块外权重更新,不是跳过当前列需要的补偿。固定网格下,两种写法在精确算术中一致;动态分组校准或浮点舍入还需按照具体实现核对。
GPTQ 用顺序近似的方法求解这个离散优化问题,不保证全局最优,也不保证所有模型的 INT4 质量损失都低于某个固定百分比。
11. AWQ 的输入通道缩放
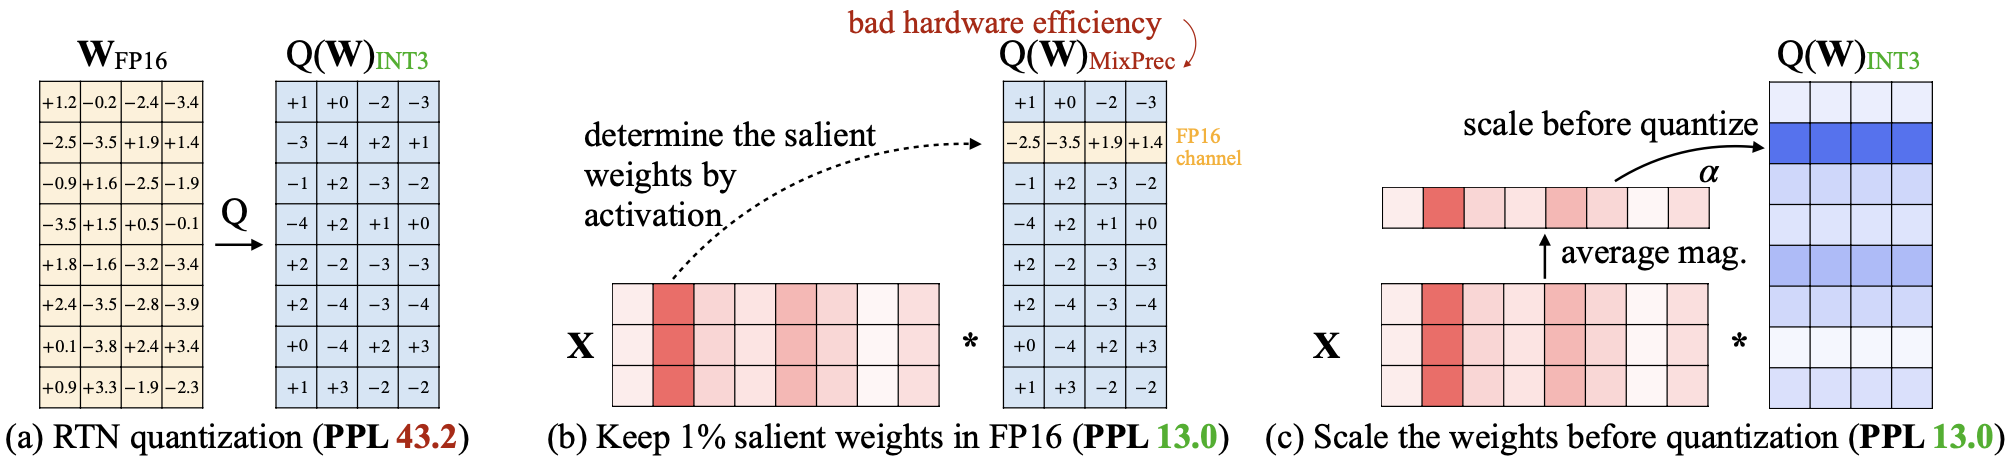
先看 AWQ 作者如何说明“重要通道”。下图的 是输入激活, 是权重, 表示量化;RTN 是直接舍入到最近量化值,PPL 是困惑度(在相同评测设置下通常越低越好)。
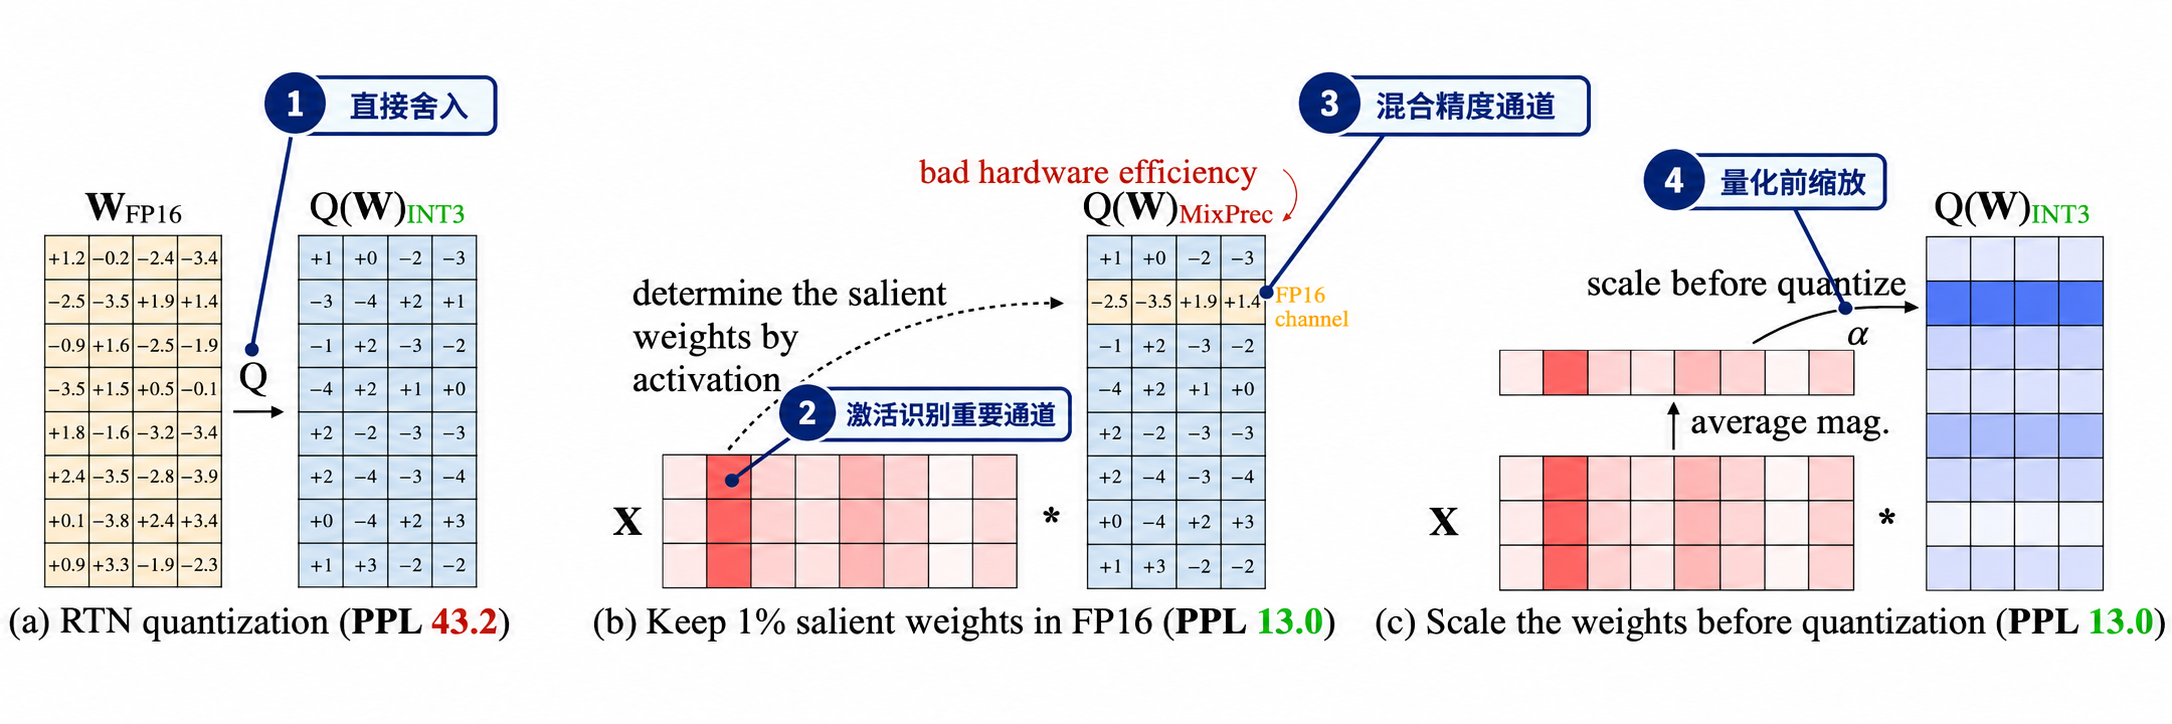
来源:原始资料;MIT HAN Lab(MIT 许可,见许可声明)。本图添加中文辅助标注与引线;查看原图。
-
直接舍入:左图把米黄色 FP16 权重直接舍入为蓝色 INT3 编码,没有区分通道的重要性。PPL 43.2 是原图特定评测结果,不是所有模型的必然结果。
-
激活识别重要通道:中图较深的红色输入列表示更大的激活幅度,用它识别哪些权重通道的误差更值得保护。原图使用 ,所以这里输入通道对应 的行。
-
混合精度通道:中图将对应权重行保留为 FP16,示例 PPL 降到 13.0,但混合精度计算会增加硬件实现负担。它是用来解释重要权重的对照方案,不是 AWQ 最终必须保留 FP16 的方案。
-
量化前缩放:右图按激活统计选择缩放,改善重要通道的相对量化误差,量化后仍统一存成 INT3。其 PPL 13.0 同样只是作者实验结果;图中未画出的输入反向缩放由下文等式补全。
注意作者画的是 ,输入通道对应 的行;下文采用 ,输入通道对应 的列。这是矩阵转置约定的差别。图中省略了保持输出不变所需的输入反向缩放,下面用等式补全。
11.1 权重放大、输入缩小,先保持输出不变
GPTQ 关注“误差如何补偿”。AWQ 关注另一件事:量化之前,能否先改变各输入通道使用量化刻度的方式?
取正的通道缩放系数 ,组成对角矩阵 :
也就是说,把权重的第 列乘以 ,同时把输入的第 行除以 。在实数算术里,乘除相互抵消,函数完全相同;实际浮点计算还会受到有限精度舍入的影响。
然后只量化变换后的权重:
量化后通常不再严格相等。这里的 是通道缩放系数,而 是组内整数刻度之间的量化步长,它们不能混为一谈。
对于输入激活较大的通道,降低有效权重误差往往更有利于减小输出误差。AWQ 由此使用激活统计量来选择缩放,而不是仅凭权重幅值找“重要权重”。论文中保护少量通道的实验是这一思路的证据,不意味着每个模型都恰好有 1% 的通道必须保留高精度。
11.2 缩放后,这个通道的误差上界变小了吗
考虑同一组中的一个权重 。缩放后组内量化步长可能由 变成 。在未截断、忽略 scale 存储舍入的最近舍入模型下,记整数舍入残差为 ,则折回原坐标的误差为:
因此两个误差上界为:
有效步长从 变为 。只要 ,这个通道的上述舍入误差上界就更小。 且 是易于理解的一种有利情形,并不要求量化步长必须保持不变。
不过,上界变小不等于该权重的实际误差必然变小。 与 未必相同;当 时,真实误差比还包含 。层输出还受到多个误差项相互叠加或抵消的影响。因此不能把 不加条件地当成实际输出误差的缩小比例。
11.3 算一个两通道的例子
下面是说明原理的两通道简化算例,不是 AWQ 模型质量基准。令:
两个权重共用严格对称 4-bit 网格 ,步长按最大幅值计算。
直接量化:,编码为 ,反量化为 ,于是:
**把第一个通道放大 2 倍:**取 ,则 ,。新步长为:
新编码为 ,这两个值恰好都落在新网格上。因此:
第一个通道的有效步长从 变成 。虽然组内步长变大了 1.4 倍,但通道放大了 2 倍,因此上界比例为 。这个具体例子里输出误差从 降到了 0,并非按上界比例乘以 0.7。
第二个通道的有效步长反而从 增到 0.2,只是在本例中数值 1 恰好仍被精确表示。真实模型里,保护一个通道可能损害同组其他通道,这正是需要校准搜索的原因。
11.4 为什么误差不一定变小
**更小的上界仍可能对应更大的实际误差。**例如一组权重为 ,严格对称 INT4 的步长是 0.1,0.3 原本能精确表示。只把第一个通道乘以 1.1 后,最大幅值仍为 0.7、步长仍为 0.1;0.33 被量化为 0.3,折回原坐标是 。误差从 0 增到约 0.027273,尽管上界从 0.05 降到了约 0.045455。
**把全组一起等比例放大,通常不会凭空增加精度。**在同一 min-max 对称量化规则、精确算术下,若整组都乘 ,那么新步长也是 ,有 。AWQ 的作用来自通道之间的相对缩放,以及对组内所有误差的取舍。
上述分析把 scale 和缩放系数视为精确实数。实际低精度存储、非对称 zero-point、clipping 和融合算子还会引入额外影响,不能直接套用未截断的半步长上界。AWQ 论文第 3 节讨论了缩放、步长变化以及重要和非重要通道间的权衡。
12. AWQ 怎样用校准数据选择缩放系数
接下来需要选择具体的 。先统计每个输入通道在校准数据上的平均绝对激活:
一种搜索方式是用 生成候选缩放,再比较:
是有限候选集合。零激活、极端数值需要正数下限与归一化保护;归一化后并不要求每个 都大于 1,重要的是通道之间的相对尺度。
这里 返回「哪个候选取得最小误差」,不是返回误差数值。例如两个通道的平均幅值为 ,先试 得到相对缩放 ,再试 得到 。每次都重新量化缩放后的权重、算校准输出并与 比较;第二个候选是否更好必须由误差决定,不能只因为第一个通道激活大就直接选它。
官方 auto_scale.py的这一路径先由平均绝对激活生成候选,再试量化并比较层或模块输出 MSE。该实现使用 20 个候选指数 ,并对缩放做下限处理和归一化。这是实现细节,不是 AWQ 定义必须采用的常数。
因此,AWQ 虽然不需要反向传播,仍要试量化并比较输出。它不做 GPTQ 式的逐权重二阶补偿,而是使用校准数据选择缩放;权重 clipping 搜索是另一个可配合的步骤,不能代替通道缩放的解释。
部署时,可在图结构允许的位置把 融合进前面的归一化或线性操作;遇到非线性、残差或多个消费者时,必须保证所有相关路径仍然等价。缩放能否跨算子融合取决于计算图,无法对任意模型都保证零开销。
13. 部署时怎样比较 GPTQ 和 AWQ
| 问题 | GPTQ | AWQ |
|---|---|---|
| 核心调整 | 量化当前列,并补偿尚未量化的列 | 量化前按输入通道缩放,并反向缩放输入 |
| 使用的校准信息 | 输入 Gram/Hessian 与量化残差 | 激活幅值与候选缩放后的输出误差 |
| 需要权衡什么 | 局部目标、量化顺序、阻尼、分组 | 重要通道与其他通道的误差、缩放与裁剪 |
| 最终质量与速度 | 依模型、数据、格式和 kernel 实测 | 依模型、数据、格式和 kernel 实测 |
仅凭算法名称,无法判断哪种方法的误差更小、速度更快,也不能由“权重是 INT4”推断所有矩阵乘和累加都用 INT4。典型 weight-only 部署仍使用较高精度激活,低位权重在 kernel 内解码参与运算;是否获得加速取决于工作负载和实现。
尤其要分清:**GPTQ/AWQ 的权重量化,不会自动量化 KV Cache。**KV Cache dtype、激活量化和权重格式是需要分别验证的配置。更小的模型文件,也不等于同倍率降低端到端延迟或进程峰值显存。
GPTQ 每量化一列,就调整还没量化的列来补偿误差;AWQ 先缩放输入通道,再用校准数据挑出输出误差较小的缩放方案。选好方法后,还要实际测回答质量、速度和显存,才能判断是否适合部署。
沿入门路线可继续 SFT。若关心训练状态,再按需读 AdamW 和 ZeRO。权重量化主要压缩表示,ZeRO 则从多卡训练中哪些状态需要重复保存入手,是另一条优化路线。
参考资料
- Nagel et al. A White Paper on Neural Network Quantization,量化参数、粒度与校准的系统介绍
- PyTorch 量化 observer 源码,用于核对仿射量化参数与边界处理
- Frantar et al. GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,ICLR 2023;尤其是局部重建目标与 Algorithm 1
- IST-DASLab GPTQ 官方实现
gptq.py,用于核对 damping、上三角 Cholesky 与块更新 - Lin et al. AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,MLSys 2024
- MIT HAN Lab AWQ 官方
auto_scale.py与 量化实现 - Frantar, Singh & Alistarh. Optimal Brain Compression,NeurIPS 2022;OBQ 的来源与二阶约束更新
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。