0. 文字、Token ID 和向量是什么关系
语言模型接收数值输入,因此需要先把文字切成若干单位,再为每个单位分配整数编号。切分单位和编号规则由 Tokenizer 决定。
例如,我们可以人为规定一个玩具词表:I → 0、love → 1、NLP → 2。于是 I love NLP 被编码成 [0, 1, 2]。这只是教学例子,不是某个真实模型的输出。
这里要区分三个概念:
- Token:切分后的一段内容,可能是一个词、一个字符、一个子词,也可能只对应部分 UTF-8 字节
- Token ID:该 token 在词表中的整数编号;编号大不代表含义更复杂
- Embedding:模型根据 ID 查到的向量,由模型训练学习,而不是 Tokenizer 直接算出的语义
假设词表大小为 ,每个向量有 个数,输入有 个 token。Embedding 表就是 ;这里 表示实数, 表示表有 行、每行 个数。查出这 个 ID 对应的行,得到 的输入矩阵。它随后交给 Transformer 处理。例如暂取 ,三个词条的向量分别为 [0.2, -0.1]、[0.7, 0.3]、[-0.4, 0.8],那么 ID [2, 0] 就查出第三行和第一行。这些数值仅用于演示。Tokenizer 决定输入对应哪几行;如果 embedding 表参与训练,模型会根据梯度更新其参数,但不能假定每个训练步都会更新每一行,具体还取决于输入、权重共享和优化器实现。
查表得到的是每个 token 的输入向量,不是最终的上下文表示。后续 Transformer 会结合位置信息和可见的其他 token 继续计算,因此同一个 token 出现在不同上下文中,后面的隐藏向量可以不同。想看这些向量怎样进入注意力和输出层,可读从数据到文本生成。
Tokenizer 把文字转换成模型可以处理的序列,模型再通过训练学习这些单位在上下文中的规律。即使切分方式不符合人的分词习惯,模型仍可能学会使用它们。不过,切得太碎会增加序列长度;如果把不认识的字符换成未知标记,也会丢失原文信息。下面分别讨论怎样训练词表和怎样使用词表分词。
第一次读,可以先看字符和子词怎么切分、BPE 怎么训练和使用,再运行第 6 节的代码。WordPiece 和 Unigram 是可比较的替代方案;理解 BPE 不要求先掌握 EM 或动态规划。第 7.3 节的计算量分析则留给需要选词表规模时阅读。
1. 字符、词与子词三种切分方式
以 I love machine learning 为例。
1.1 字符级别 (Character-level)
如果每个字符都是一个 token,连空格一起算,这句话有 23 个 token。词表可以只收录语料中出现过的字符,常见英语字符集很小;但多语言、符号和 emoji 会扩大字符集合,不能把“字符级词表”一概理解成约 100 个条目。
字符级模型仍然可以学习词义和句义,只是通常需要用更长的序列表示一句话。另一个细节是,Unicode 码点不等于人眼看到的完整字符:带组合附加符号的字母或某些 emoji 可能由多个码点组成。
1.2 词级别 (Word-level)
如果先按空格切词,上面的句子只有 4 个 token。但新词、拼写变体、专有名词会不断出现,有限词表无法全部收录。遇到 OOV(Out-of-Vocabulary,词表外内容)时,简单的词级方案会用 <UNK> 代替,原词的信息就丢了。
此外,中文并不能直接照搬英文的空格切词规则。
1.3 子词级别 (Subword-level)
子词分词希望用较短的序列表示尽可能多的文字:把常见片段合成一个 token,再把不常见的组合拆成较小的单位。例如,在人为设定的词表里,tokenization 可以拆成 token 和 ization;真实切分取决于具体词表。
这也是许多主流语言模型的选择。但“子词”只是历史名称,实际 token 不一定对应词根、词缀或完整字符。
是否出现 <UNK>,关键在于基础单位是否覆盖输入,以及有没有回退机制,不是词表越小就越安全。包含全部 256 个字节的 Byte-level tokenizer,可以把有效 Unicode 文本编码成 UTF-8 字节再表示;仅包含训练语料字符的子词词表,则可能遇到没见过的字符。
下面是 Karpathy 分词教学中保存的一张真实工具截图,可以先检查“token 是否等于一个词”这个直觉。
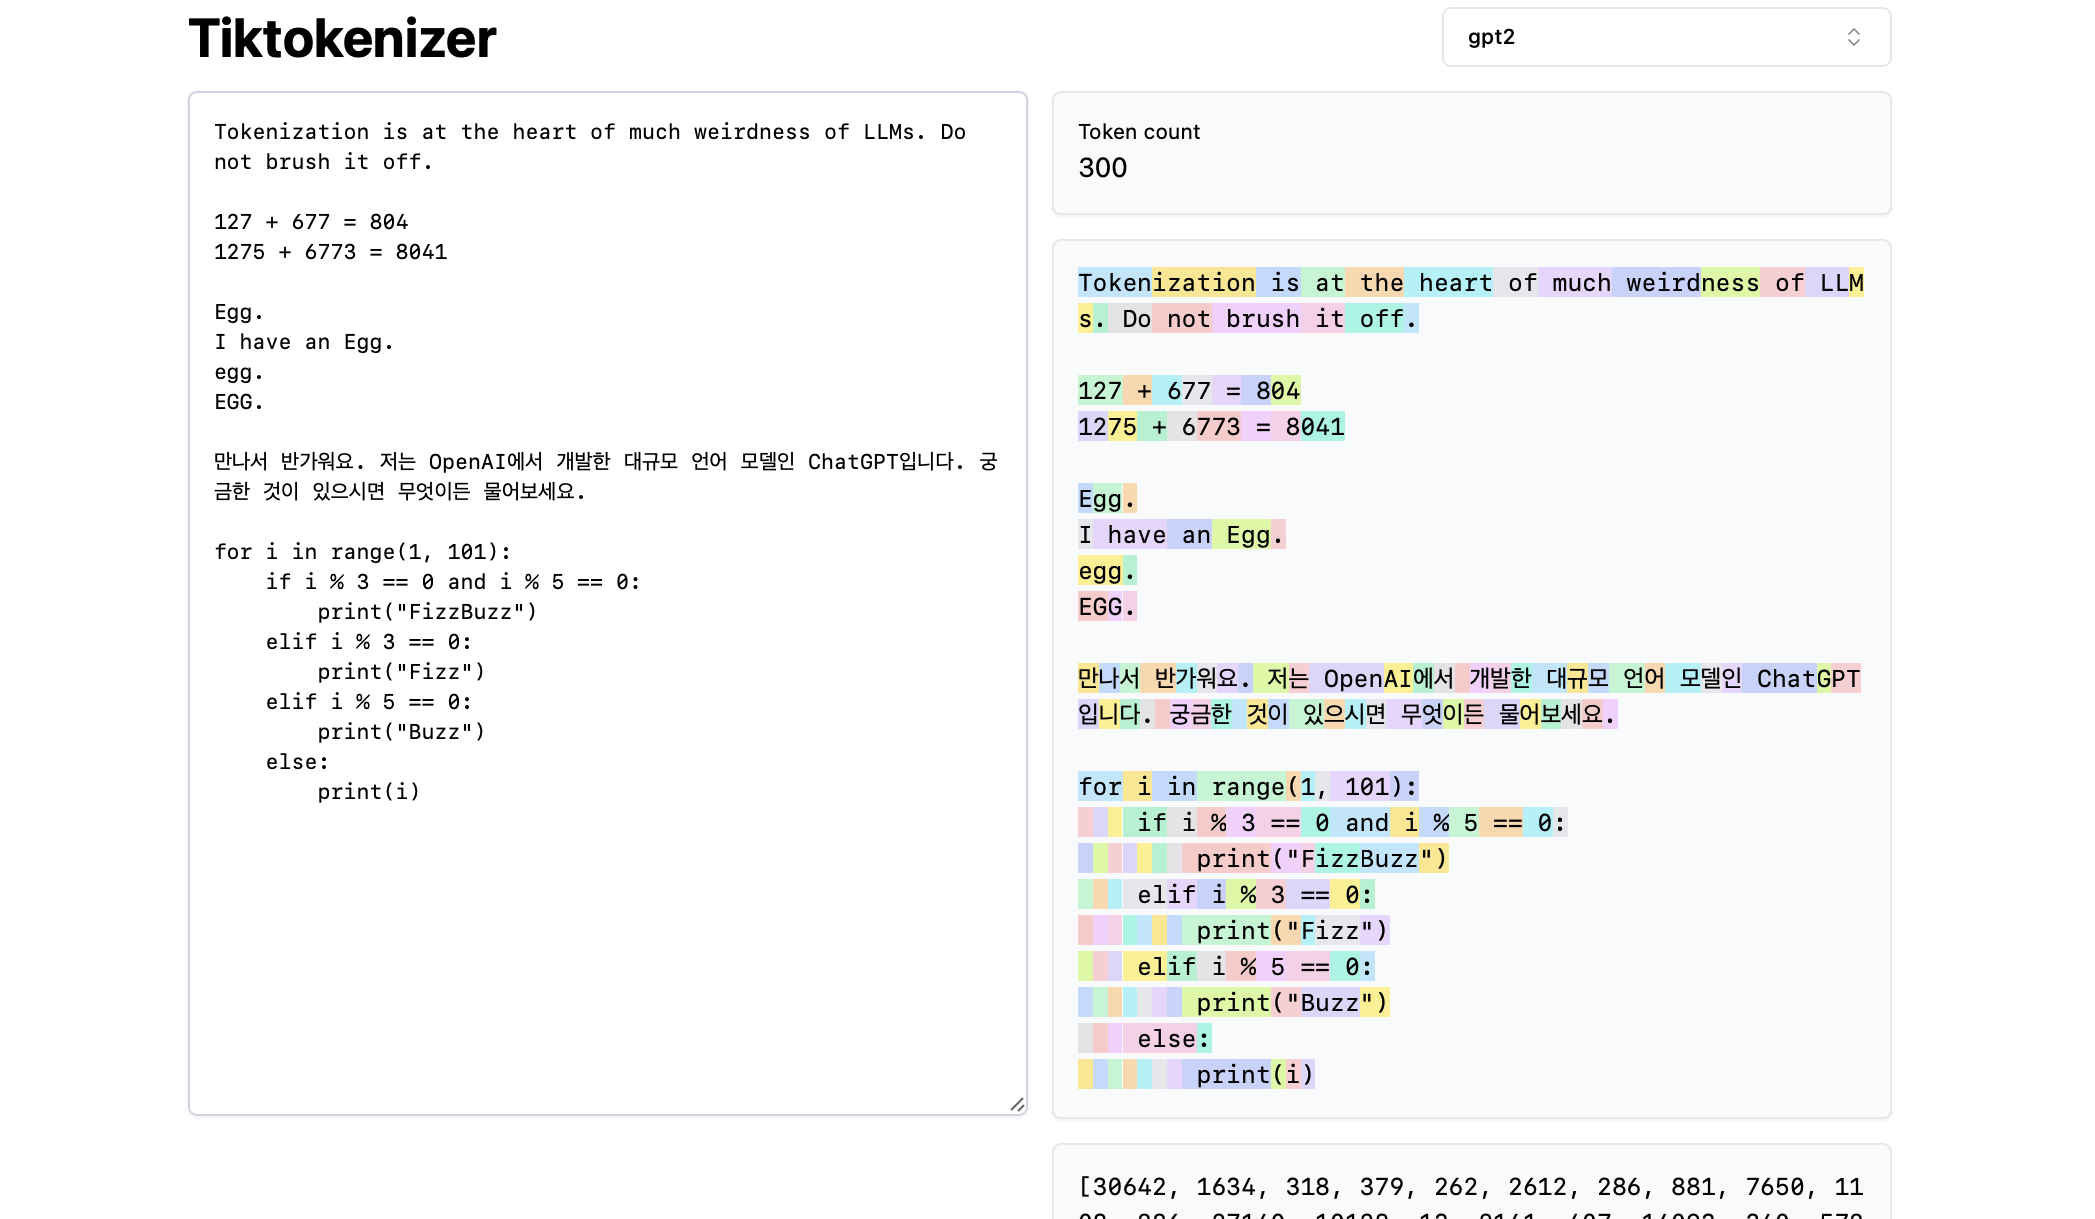
图源:Andrej Karpathy,minbpe 分词讲义(原图,仓库 MIT 许可,原样引用;截图工具为 Tiktokenizer)。
读图时看右侧的三个局部:
- 最上面的英文。
Tokenization被分成几块,一个词未必只占一个 token。颜色表示边界,不表示词性或语义类别。 - 两行数字和几种 Egg 写法。 数字不是固定每位一块;大小写、前导空格也可能改变切分,所以不能只按词数估算 token 数。
- 韩文和代码。 非英语文本、空格与缩进同样需要编码。图中选的是 GPT-2 tokenizer,不能把它的边界和总数当作所有模型的共同规则。
这张图展示的是使用已训练好的 tokenizer。下一节再看:这些片段是怎样从训练语料里逐次合并出来的。
2. BPE:合并高频的相邻片段
BPE 原本是一种压缩思路。Sennrich 等人把它用于机器翻译中的子词学习:从小单位开始,反复合并高频的相邻单位。这里先使用字符和词尾标记演示,Byte-level 变体稍后再说。参见 BPE 论文第 3 节。
2.1 BPE 的训练步骤
直观地说,如果语料中 l 后面经常紧跟 o,把它们合成 lo,就能少用一个位置。随后,如果 lo 又经常紧跟 w,就可以继续得到 low。
训练时,每一轮都执行:
- 统计当前 token 序列中相邻 pair 的出现次数,重复词按词频加权
- 选择频率最高的一对,按固定规则处理并列情况
- 在 token 边界上合并该 pair 的非重叠出现,记录合并顺序
- 重新统计,直到满足词表大小或其他停止条件
这里的 pair 是当前相邻 token,不一定还是单个字符。训练后要保存两样东西:词表,以及按先后顺序排列的合并规则。
2.2 用 low、newer 等单词手算一次训练
用这个小语料:
| 词 | 次数 | 初始 token 序列 |
|---|---|---|
| low | 10 | l o w </w> |
| lowest | 5 | l o w e s t </w> |
| newer | 5 | n e w e r </w> |
| wider | 5 | w i d e r </w> |
| new | 2 | n e w </w> |
</w> 是本例保留的词尾标记,不是所有 BPE 实现都使用它。初始有 11 种 token:10 个字母加词尾标记。
第一轮中,(l, o) 和 (o, w) 都出现 次,(w, </w>) 出现 次。我们约定并列时选择扫描语料最先遇到的一对,所以先合并 (l, o)。
之后 low 的表示变成 lo w </w>。原来的 (o, w) 已经不存在了,不能沿用旧统计。重新计数后,(lo, w) 出现 15 次,下一轮得到 low。
沿用这个并列规则,做到词表大小 18 时,完整的 7 次合并为:
1. (l, o) → lo2. (lo, w) → low3. (low, </w>) → low</w>4. (e, r) → er5. (er, </w>) → er</w>6. (n, e) → ne7. (ne, w) → new本例每次都新增一个条目,因此 。真实训练还要考虑基础字符集、特殊 token、重复候选和停止条件,不能对所有实现都套用“目标词表减字符数就是合并次数”。
如果想逐步观察合并,可以打开 Philip Müller 与 Peter Steinbach 的 BPE Explainer:在训练视图里同时看当前 token 序列、相邻对频次和增长的词表,每前进一步只观察一次合并;再切换到验证视图,看已学到的规则如何切分新文本。它把“训练词表”和“使用词表”分开演示。不同预切分设置会限制哪些相邻对可以合并,比较结果时也要固定这个设置。
2.3 推理时如何分词
推理时不重新统计词频,而是遵循训练得到的 merge rank(合并优先级):
- 按相同的规范化、预分词和基础单位规则处理输入:规范化是按配置整理文本,如统一某些字符形式;预分词是先划出允许内部合并的片段,例如按空格、标点或正则规则划分;基础单位则决定片段最初拆成字符还是字节
- 在当前可合并的相邻 pair 中,优先选择训练时排名最靠前的规则
- 更新序列,继续执行,直到没有可用规则
对上述从字符逐步训练出来的规则,也可以按训练顺序逐条应用,得到相同结果。第 6.4 节为了直接体现优先级,显式选择当前 rank 最小的 pair。
合并顺序由 rank 决定,不能改成从左到右优先合并,也不能直接选词表中的最长片段。例如,假设规则顺序是先合并 (b, c),再合并 (a, b),那么 a b c 应当得到 a bc;先看最左边就合并,会误得 ab c。
再用这组规则切分一个新词 newest:
n e w e s t </w>→ ne w e s t </w>→ new e s t </w>它的字符都在基础词表中,所以即使整个词没有出现过,仍然能表示出来。
一个字节有 8 个二进制位,共有 256 种取值。UTF-8 规定如何把文字编码成字节:例如 A 用一个字节 41(十六进制)表示,你 用三个字节 E4 BD A0 表示。若词表覆盖每种字节,没见过的字也能先拆成这些字节表示,不必用一个未知标记抹掉内容。若某次合并只覆盖 E4 BD,这个 token 就还不是一个完整的 你,需要把后续字节接齐再解码。
GPT-2 的 Byte-level BPE 则从 UTF-8 字节出发,保留全部 256 种字节作为基础单位;同时有自己的正则预分词规则。它能够表示有效 Unicode 文本,不需要因未见过某个字符而输出 <UNK>。不过,单个 token 可能只含一个字符的部分字节,不能保证单独解码每个 token 都是完整字符。参见 GPT-2 官方编码实现。
2.4 BPE 的优缺点
- 训练思路直接,能把高频片段压缩成更少的 token
- 切分由语料、预处理、基础单位和合并顺序共同决定
- 高频不等于语义完整,因此 BPE 不保证按词根或词缀切分
- 没有字节覆盖或其他回退机制的字符级 BPE,仍可能遇到未知字符
3. WordPiece:训练词表,分词时优先匹配最长片段
WordPiece 在 BERT 之前就已提出,后来被 BERT 采用。它的词表训练和推理分词采用不同的规则:原始训练方法公开的细节有限,而推理时的分词流程可以直接核对 Google 发布的 BERT 实现。
3.1 和 BPE 的区别
BPE 的典型训练按相邻 pair 频率合并。WordPiece 的文献描述强调语言模型似然,即选择能让训练语料获得更高概率的词表;GNMT 论文第 4.1 节给出了这种方向。
网上常见的相邻频率比值,可以帮助理解“共现紧密”和“出现得多”的区别。这种评分是教程根据公开资料写出的简化训练方法,并不是 Google 公开的完整原始训练算法。Hugging Face 的教学实现也明确说明这一限制。
3.2 出现得多,和经常一起出现,有什么区别
先看一个简化的统计例子:
- 一对 token 相邻出现 4 次,而它们各自也都只出现 4 次,说明这两段几乎总是一起出现
- 另一对相邻出现 10 次,但两个 token 各自都出现了 100 次,说明它们也经常和别的 token 搭配
用 表示当前 token 的出现次数, 表示相邻 pair 的次数,教学评分为:
前一对得到 ,后一对是 。虽然后一对出现更多,前一对在这种评分下优先。
这个例子只说明评分如何使用出现次数,不是完整的 WordPiece 训练流程。BERT 风格词表还区分词首 token 和以 ## 开头的续接 token,训练统计也应对应这些实际 token;同一个字母在不同位置可能对应不同 token,需要分别计数。这种评分衡量共现关系,并不直接衡量切分的语义质量。
3.3 BERT 如何用 WordPiece 词表分词
BERT 风格 WordPiece 推理依赖最终词表,使用 greedy longest-match-first:
- 对预处理后的一个词,从当前位置开始,寻找词表中最长的匹配片段
- 词首使用普通条目,后续位置使用带
##的条目 - 选中后继续处理剩余部分,不做全局最优搜索,也不回溯
- 如果无法完整切分,原始 BERT 实现会把这个词整体变成
[UNK]
假设玩具词表含有 un、##aff 和 ##able,而没有更长的可匹配条目,则 unaffable 可以切成:
["un", "##aff", "##able"]## 表示续接,不是原文真的有两个井号。实际切分取决于这份 BERT checkpoint(保存下来的模型权重及配套配置)使用的词表,未必与这个例子相同。
两者的推理规则不同:BPE 看合并优先级,WordPiece 看当前位置的最长词表匹配。 两者即使拥有相似的片段,也可能切出不同结果。
4. Unigram:给每种切分计算概率
4.1 同一段文字可以怎样切分
同一个字符串可能有多种合法切分。假设玩具词表只有 a、b、ab,概率分别为 、、,三者相加为 1。
字符串 ab 就有两条路径:
[ab]:路径概率为[a, b]:路径概率为
Unigram 假设一条路径中各 token 独立出现,以 token 概率的乘积给路径评分。最优路径是 [ab],但另一条路径也能拼出这段文本,训练时不应直接忽略它。
词表学习通常先准备一个较大的候选集合,例如训练语料中的字符和高频子串;反复估计概率,评估删除候选造成的损失,再缩小词表。不是枚举所有可能字符串,也不是保证找到全局最优词表。参见 Kudo 的 Unigram 论文第 3.2 节。
4.2 训练用边缘似然,确定性分词用 Viterbi
设输入文本为 ,所有能完整拼回 的合法切分组成集合 。一条切分记为 ,其中 是这条路径的 token 数, 是词表中 token 的概率。那么:
这里 表示把各项连乘, 表示把各项相加;上下标说明哪些项参与运算。对不同路径求和后,上例字符串 ab 的边缘概率为 ,不是只取最大值 。“边缘”指看见了文本,却不知道它走的是哪条切分路径,因此把所有能产生它的路径分数相加。这里计算的是 Unigram 切分模型中的文本概率,用于评价切分方案,与后文语言模型预测下一个 token 的概率不同。
对包含 条文本的训练集,记第 条为 ,最小化的负对数边缘似然是:
这里 是自然对数:它把连乘变成对数之和,并且严格递增,所以不改变最大值所在的候选。训练集各条文本概率的连乘取对数后,成为上面的外层求和;加负号,就把最大化概率改成最小化损失。注意内层对不同切分的求和仍留在对数里面,不能把“和的对数”拆成“对数的和”。
乘积中的 按路径上的每次出现计算,重复 token 也要重复相乘。固定词表后,基本的 soft EM 思路是:
- E 步:用 forward-backward 动态规划,对所有合法路径按后验概率加权,得到每个 token 的期望出现次数
- M 步:把这些期望次数归一化,更新 token 概率;具体实现还可能加入平滑等细节
- 迭代后评估删词造成的似然损失,保留必要的基础单位,剪去影响较小的候选,再重新估计
这里的“后验”是指:已经知道原文是 ab,两种切分各占多大比例。“期望次数”可以是小数,因为路径还没选定,计数要按各条路径的比例分摊;这不表示实际切分会产生半个 token。
在玩具例子里,两条路径的后验权重是 和 。因此 ab 的期望次数是 ,a、b 各是 。如果只统计最佳路径中的整数次数,得到的是 hard EM 的做法;这里的 soft EM 则保留了其他路径的贡献。
把这一个样本的期望次数接着用于一次 M 步:总次数为 ,因此更新后的概率是 、。这演示了“先按当前概率分摊次数,再用次数更新概率”的循环;真实训练会汇总全部文本,也要处理平滑和剪枝。
如果使用时只需要一条确定性切分,则取路径概率最大的结果:
这里 返回使分数最大的切分本身,而不是最大分数;例如前面的 ab 返回 [ab]。
这一步用 Viterbi 动态规划完成,不必穷举所有路径。动态规划在这里可以理解成“记住每个文本前缀的最好结果,后面的计算复用它”。仍看 ab:空前缀的乘积是 1;到 a 的最好分数为 0.4;到 ab 时,比较从空前缀接 ab 得到的 ,和从 a 接 b 得到的 ,保留前者,并记录它从哪里来。
训练时若想把所有路径加起来,同一张路径图就把“取最大值”换成“求和”:到 ab 的总量成为 0.36。forward-backward 还会从文本末尾反向累计,用前后两边的信息计算每条边属于完整路径的权重。因此,训练时需要汇总多条路径的贡献,确定性分词时则只需找出概率最高的一条路径。
选读:候选查找的计算量trie 是按字符共享前缀的查找树;例如
a与ab的查找可以共用首字符a。若输入长度为 、token 最大长度为 ,用 trie 等结构在每个起点至多沿字符检查 步,可以在 时间内构建候选并完成这种简单情形的解码;该界限依赖实现,不能忽略子串复制或匹配的成本。 只描述计算量随 、 增大的量级,不是运行秒数;更一般的复杂度记号见第 7.3 节,第一遍可跳过这个框。
4.3 和 BPE/WordPiece 的对比
Unigram 为多条切分路径分别计算概率,既能选最优路径,也能采样不同切分做 subword regularization(训练时采用不同合法切分,增加同一文本的表示变化)。
它并不天然保证语义更合理,也不能只凭“用了 Viterbi”就断言一定比所有 BPE 实现慢。训练、分词的速度还取决于候选数量、数据结构和实现。BPE 同样可以设置目标词表大小,这也不是 Unigram 独有的能力。
5. SentencePiece:训练和使用分词器的工具包
SentencePiece 是支持 BPE 和 Unigram 的 Tokenizer 工具包。 除了训练子词模型,它还会保存规范化、空白处理、编码和解码规则。因此,SentencePiece 描述的是工具及其处理流程,BPE 和 Unigram 描述的则是子词学习方法。参见 SentencePiece 论文。
5.1 怎样处理原始文本、空格和字符形式
前面的玩具例子先按空格切词,这是为了讲解方便,不是所有子词算法的必要条件。SentencePiece 能直接从原始句子训练,无需调用外部的中文分词器或英文分词器。
例如,空格可以在内部表示成 ▁(U+2581)。假设某个词表包含对应片段,I love NLP 的 token 可能显示为 ['▁I', '▁love', '▁NLP']。这是空格表示方式的示意,不是某个模型的实测切分。
SentencePiece 虽然不依赖外部分词器,仍会按配置处理文本:
- 训练配置可以限制是否跨空格、Unicode script 或数字边界形成片段
- 默认规范化采用基于 NFKC 的规则,也可以自定义;NFKC 是 Unicode 的兼容性规范化,例如可能把全角拉丁字母变成对应的半角形式。空白还可能被整理,因此这一步有时会改变原始写法
decode(encode(text))是否与原始文本逐字符一致,要看规范化和回退配置,不能仅凭使用 SentencePiece 就保证
这些行为都可在 SentencePiece 的训练选项中核对。
5.2 字符子词、字节回退与 Byte-level BPE
LLaMA 1/2 使用 SentencePiece BPE,并对未知字符使用 byte fallback;这种“字符子词 + 字节回退”与 GPT-2“从全部字节开始做 BPE”的设计不同。LLaMA 原始论文明确说明了 SentencePiece 和 UTF-8 字节回退。Llama 3 则使用基于 tiktoken 的 BPE,见 Meta 官方实现。T5 是 Unigram 的常见应用,见 T5 Tokenizer 文档。
另外,character_coverage=1.0 表示保留训练数据里观察到的全部字符,不等于预先收录未来可能出现的所有 Unicode 字符。是否启用 byte fallback,需要单独检查配置。
6. Tokenizer 的训练与使用示例
下面分别演示怎样训练一个小 Tokenizer、查看已有模型的分词结果、统计文本长度,以及自己实现 BPE 的训练和分词循环。它们不共享同一份词表。
6.1 用 Hugging Face tokenizers 训练一个 BPE
仅创建 models.BPE() 不会自动得到 GPT-2 风格的 Byte-level 预处理。下面显式配置字节字母表、预分词器和解码器,语料直接写在代码里,不依赖额外的 corpus.txt。
from tokenizers import Tokenizer, decoders, models, pre_tokenizers, trainers
corpus = [ "I love machine learning.", "I love tokenization.", "大语言模型通过 token 处理文字。",]
tokenizer = Tokenizer(models.BPE(unk_token="<unk>"))tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)tokenizer.decoder = decoders.ByteLevel()trainer = trainers.BpeTrainer( vocab_size=300, min_frequency=2, special_tokens=["<unk>", "<s>", "</s>"], initial_alphabet=pre_tokenizers.ByteLevel.alphabet(), show_progress=False,)tokenizer.train_from_iterator(corpus, trainer=trainer)
text = "I love machine learning. 你好🙂"output = tokenizer.encode(text)print(output.tokens)print(output.ids)assert tokenizer.decode(output.ids) == textassert tokenizer.token_to_id("<unk>") not in output.ids这个例子保留全部字节,所以即使语料没见过 🙂,也能回退到字节表示。300 是目标上限,小语料和最小频率限制可能让实际词表更小。声明 <s>、</s> 为特殊 token,并不会自动在每条序列首尾插入它们;那需要后处理规则。
输出中的可见符号可能是内部字节映射,不能当作原文字符。token 和 ID 取决于这次训练得到的词表,其他 Tokenizer 的输出不能直接套用。接口可对照 Tokenizers 官方 Quicktour。
6.2 查看 GPT-2 的切分结果与 Token ID
下面以公开的 GPT-2 checkpoint 为例,只加载 Tokenizer,不下载模型权重。运行需要安装 transformers 和 tokenizers,并能访问模型仓库。为了复现实验,应记录包版本,并把 REVISION 换成所使用仓库的固定 commit SHA(仓库某次提交的固定标识,避免 main 更新后加载到不同内容)。
from importlib.metadata import versionfrom transformers import AutoTokenizer
MODEL_ID = "openai-community/gpt2"REVISION = "main" # 演示用;正式复现实验请改为固定 commit SHA
tokenizer = AutoTokenizer.from_pretrained( MODEL_ID, revision=REVISION, use_fast=True)print("model:", MODEL_ID, "revision:", REVISION)print("transformers:", version("transformers"))print("tokenizers:", version("tokenizers"))
for text in ["Tokenization is the first step", "大语言模型分词器"]: content_ids = tokenizer.encode(text, add_special_tokens=False) model_ids = tokenizer.encode(text, add_special_tokens=True) print(repr(text)) print("tokens:", tokenizer.convert_ids_to_tokens(content_ids)) print("content IDs:", content_ids) print("content count:", len(content_ids)) print("with special tokens:", len(model_ids))切分结果取决于加载的 Tokenizer。add_special_tokens=True 具体添加什么,由 checkpoint 配置决定,有些 Tokenizer 甚至不会因此增加 token。若换成 LLaMA 2 等默认添加 BOS(Beginning of Sequence,序列起始标记)的 Tokenizer,直接比较 tokenize(text) 和默认 encode(text) 的长度,就可能差一个 BOS。
6.3 统计文本的 Token 数量
沿用上一节加载的 GPT-2 Tokenizer,下面分别统计三段文本的 token 数量,并计算平均每个 token 对应多少个 Unicode 码点:
texts = [ ("English", "The quick brown fox jumps over the lazy dog"), ("中文", "大语言模型分词器的工作原理是什么"), ("混合", "BERT 的 WordPiece 和 LLaMA 的 BPE 有什么区别"),]
for lang, text in texts: ids = tokenizer.encode(text, add_special_tokens=False) chars_per_token = len(text) / len(ids) if ids else 0.0 print(f"{lang}: {len(ids)} tokens, {chars_per_token:.2f} code points/token")Python 的 len(text) 在这里统计 Unicode 码点,不是 UTF-8 字节,也不是信息量。这三句话不是相同内容的翻译,不能据此得出“表达同样的信息,中文固定多花多少 token”。
评估跨语言效率,应使用足够多的可比文本或平行语料,同时固定 Tokenizer 版本、文本规范化规则、是否加入特殊 token,以及数量的统计方式。上下文窗口限制的是 token 数;可容纳多少汉字、英文词或代码行,取决于具体输入,不能用单条示例比例作保证。
6.4 自己实现一个简化版 BPE
下面用 Python 标准库实现按词训练的字符级 BPE。合并操作始终以完整的相邻 token 为单位;分词时则按训练得到的优先级应用规则。
如果把 token 序列拼成字符串,再对它做普通的子串替换,('b', 'c') 这样的规则可能误改 ('ab', 'c') 中的后半段。列表或 tuple 能保留边界,避免这个问题。
from collections import Counter
EOW = "</w>"
def split_words(text): if EOW in text: raise ValueError("</w> is reserved by this teaching tokenizer") return [tuple(word) + (EOW,) for word in text.split()]
def merge_pair(symbols, pair): """Only merge complete, adjacent, non-overlapping token pairs.""" merged = [] i = 0 while i < len(symbols): if i + 1 < len(symbols) and (symbols[i], symbols[i + 1]) == pair: merged.append(pair[0] + pair[1]) i += 2 else: merged.append(symbols[i]) i += 1 return tuple(merged)
def train_bpe(corpus, vocab_size): words = Counter(word for text in corpus for word in split_words(text)) vocab = {token for word in words for token in word} if vocab_size < len(vocab): raise ValueError("vocab_size is smaller than the initial alphabet")
merges = [] while len(vocab) < vocab_size: pairs = Counter() for word, freq in words.items(): for pair in zip(word, word[1:]): pairs[pair] += freq if not pairs: break
# Python preserves insertion order: ties use the first encountered pair. best_pair = max(pairs, key=pairs.get) new_words = Counter() for word, freq in words.items(): new_words[merge_pair(word, best_pair)] += freq words = new_words merges.append(best_pair) vocab.add(best_pair[0] + best_pair[1]) return vocab, merges
def apply_bpe(text, vocab, merges): ranks = {} for rank, pair in enumerate(merges): ranks.setdefault(pair, rank) # Keep the earliest rank if repeated. result = [] for tokens in split_words(text): if any(token not in vocab for token in tokens): raise ValueError("unseen character: this example has no byte fallback") while len(tokens) > 1: candidates = ( pair for pair in zip(tokens, tokens[1:]) if pair in ranks ) best_pair = min(candidates, key=ranks.get, default=None) if best_pair is None: break tokens = merge_pair(tokens, best_pair) result.extend(tokens) return result
corpus = ["low"] * 10 + ["lowest"] * 5 + ["newer"] * 5corpus += ["wider"] * 5 + ["new"] * 2vocab, merges = train_bpe(corpus, vocab_size=18)print(merges)print(apply_bpe("newest", vocab, merges))# ['new', 'e', 's', 't', '</w>']这段实现按重复词频加权,并在推理时复用自己训练出来的规则。相邻重复模式也采用非重叠合并,例如把 a a a 中的 (a, a) 合并为 aa a。
实际项目还不能直接用这段代码替代完整 Tokenizer:按空白切词会丢失原始空白格式,没有 Unicode 规范化、字节回退、ID 分配和高效索引。遇到未见字符会明确报错。若全部词都已不可再合并,训练会提前停止,词表不一定达到目标大小。
从复杂度看,设规则有 条、单个词最初有 个基本单位。先建 rank 表需要 ;推理每轮扫描相邻 pair,至少减少一个 token,因此这个朴素循环最多进行 次 token 检查。这里忽略 Python 字符串哈希和拼接成本,不能把这个教学版本的耗时直接推广到有优先队列、缓存等优化的实际 BPE 实现。
7. 怎样选择 Tokenizer 和词表大小
7.1 常见模型有多少词条,这个数字包含什么
不同文章里的“词表大小”可能指基础子词数、包含特殊 token 的总条目数,或模型 Embedding 的行数。它们不总是相等。
| 具体模型或配置 | Tokenizer | 词表大小及包含的条目 |
|---|---|---|
openai-community/gpt2 | Byte-level BPE | 模型 vocab_size 为 50,257,包含特殊 token |
google-bert/bert-base-uncased | WordPiece | 模型 vocab_size 为 30,522;不能代表所有 BERT 版本 |
| LLaMA 1/2 | SentencePiece BPE + byte fallback | 32,000 词表;具体特殊 token 和配置需随 checkpoint 核对 |
| 初代 Llama 3 | 基于 tiktoken 的 Byte-level BPE | 128,000 个基础/可合并条目,加 256 个特殊 token 槽位,共 128,256 |
google-t5/t5-small | Unigram | 模型 vocab_size 为 32,128;Tokenizer 还涉及基础 SentencePiece 词表和 100 个 sentinel(占位用的特殊标记),不能把模型行数直接当普通子词数 |
数字分别可核对 GPT-2 配置、BERT 配置、LLaMA 配置文档、Llama 3 的特殊 token 定义及 BOS 起始 ID 测试、T5 配置和 T5 的 sentinel 配置。
比较中文处理效果时,需要分别检查能否编码、切分后有多少 token,以及模型实际的中文能力。覆盖全部字节可以解决编码问题;切分效率和语言能力还取决于词表、训练语料与模型训练。
7.2 根据模型和语料选择 Tokenizer
- 使用或微调已有模型:优先使用该 checkpoint 配套的 Tokenizer、特殊 token 和 chat template(把角色与消息排成模型预期输入的格式);不能随意更换词表,否则 ID 与 Embedding 的对应关系会错位
- 从头训练模型:在目标语言、领域和代码样本上比较平均 token 数、最长的那些样本有多少 token、未知字符比例,以及解码后能否还原文本,再决定算法和词表大小
- 多语言需求:检查各语言在训练语料中的覆盖,不要只用一个总平均值,也没有“必须 100K 以上”的通用门槛
- 效率需求:把序列长度、模型参数、输出层计算和实际吞吐一起测;更大的词表通常能把一些文本切得更短,但不保证模型运行得更快
7.3 词表大小对参数量和计算量的影响
本节是选读,涉及模型计算量。记号 表示只追踪输入规模增大时的主要增长项,暂时忽略常数,因此不能直接把式子换算成毫秒。FFN 是在每个位置独立处理特征的前馈网络;全注意力会计算位置两两之间的匹配。KV Cache 是生成时缓存以前 token 的 key/value,避免每一步都重算它们。理解这一节时,先掌握这些计算各自处理什么即可。
例如,把常见的三个小片段合成一个 token,可以缩短序列,同时也会给词表增加一行。这会同时影响模型的参数量和每次计算的运算量,两者需要分别考虑。
令 为模型词表行数, 为隐藏维度, 为序列长度, 为层数。输入 Embedding 的参数量是:
若输出投影不与输入 Embedding 共享权重,输出层还要约 个参数。Embedding 查表不是每个 token 都与整个 矩阵相乘,所以不能把 参数量直接写成整个输入序列的查表计算量。
对稠密 Transformer、全注意力、单条长度 的序列,在所有位置都计算词表 logits 的训练前向中,忽略常数、偏置和逐元素操作,主要矩阵运算量可写成下面的量级。这是按矩阵尺寸逐项计算的估计,attention 和 FFN 的结构可对照 Transformer 原始论文第 3 节:
- :各层线性投影和 FFN,假设 FFN 中间维度与 成比例
- :全注意力中的 token 间交互
- :在所有位置生成完整词表 logits 的输出投影
使用 KV Cache 一次生成一个新 token 时,若当前共有 个可见位置,每步大致对应 ,不能继续把整段训练的 成本照搬过来。实际延迟还受内存带宽、batch size、内核和硬件影响。
例如 时,32,000 行的单个 Embedding 表有 131,072,000 个参数,128,000 行则有 524,288,000 个参数。这个算例只比较 Embedding 表的参数量,没有计算两个真实 checkpoint 的完整模型,也不足以判断总体运行速度。
8. 小结:训练词表和使用词表是两件事
| 方法或工具 | 训练时关注什么 | 使用时怎样分词 |
|---|---|---|
| Character-level | 选择字符集合 | 按规定的字符单位切分 |
| Word-level | 选择词和预分词规则 | 查词表,处理未知词 |
| BPE | 逐步合并高频相邻 pair | 按 merge rank 合并 |
| WordPiece | 文献强调似然;原始训练细节不能用教学公式完全代替 | BERT 风格为 greedy longest-match-first |
| Unigram | 概率估计与词表剪枝,目标涉及所有切分的边缘似然 | Viterbi 选最优路径,或按概率采样 |
| SentencePiece | 集成规范化和子词模型的工具包 | 取决于选用的 BPE / Unigram 与配置 |
比较分词方法时,既要看词表如何训练,也要看推理时采用什么切分规则。Token 可以是词、字符或字节片段。比较效果时,分别检查原文能否完整保留、切分后有多少 token,以及模型在实际任务中表现如何。
参考资料
- Sennrich et al. Neural Machine Translation of Rare Words with Subword Units, ACL 2016:BPE 子词学习
- Wu et al. Google’s Neural Machine Translation System, 2016:WordPiece 的似然训练思路
- Google BERT tokenization.py:WordPiece 最长匹配和
[UNK]行为 - Hugging Face WordPiece 教学实现:明确注明训练算法是基于文献的重构
- Kudo. Subword Regularization, ACL 2018:Unigram、边缘似然和多路径采样
- Kudo & Richardson. SentencePiece, EMNLP 2018:不依赖外部分词的工具包
- Google SentencePiece 选项:字符覆盖、规范化和 byte fallback
- OpenAI GPT-2 编码实现:Byte-level BPE 的基础字节映射与合并顺序
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。