0. 从 4K 扩到 32K,要改 RoPE 的什么
上一篇 RoPE:旋转位置编码 介绍了如何旋转 query 和 key,让点积公式中单独加入的位置因素只依赖位置差。内积仍然取决于 token 内容,并不是距离相同,attention 就一定相同。
RoPE 将 query 或 key 的坐标每两维分成一组,并根据 token 位置旋转这些二维向量。位置每增加一格,各组就按自己的频率增加相应的旋转角度。query 是当前位置用来匹配的向量,key 是被匹配位置的向量。它们旋转后再做点积,得到 attention 匹配分数的一部分。后面三种扩展方案主要调整的就是各组坐标的旋转频率。
这篇继续讨论一个问题:模型原来只在 4K 长度上训练,如果要处理 32K 的文本,RoPE 应该怎么改?
“上下文”是本次预测能利用的前文,长度用 token 数计算。扩展上下文是为了让模型读到更早的文本。本文只讨论怎样调整位置编码,不讨论先把文档做成摘要再输入等方法。
下面依次介绍 Position Interpolation(PI)、NTK-aware scaling 和 YaRN。三种方法都通过调整频率,改变位置差对应的旋转角度。它们的区别在于是否统一缩放所有频率、如何分别处理高频与低频,以及是否额外调整 attention 分数的尺度。
先约定符号,区分模型宽度与单个 head 的宽度:
| 符号 | 含义 |
|---|---|
| 从 0 开始的 token 位置 | |
| 参与 RoPE 的维数;本文假设整个 attention head 都参与, 是正偶数 | |
| 二维旋转对的编号, | |
| RoPE 的 base,数值例子取 ,其他模型未必相同 | |
| 第 对的角频率,即每前进一个 token 增加的旋转角度 | |
| 波长,即旋转一圈对应的 token 距离 | |
| 原训练上下文长度、希望扩展到的长度 | |
| 扩展比例,本文只讨论有限的 |
这里的 4K、32K 分别指 4096、32768 个 token。NTK 的推导还要求 。如果模型只旋转 head 的一部分,需要另行区分 rotary dimension 与 attention 分母使用的 head dimension。
1. 为什么能算出更大的位置编号,还不够
原始 RoPE 在位置 使用角度:
是“位置 、第 对坐标”的旋转角度,单位是弧度;一整圈为 弧度。两个下标表示不同的对象: 表示 token 在文本中的位置, 表示向量中的第几对坐标;不同坐标对使用不同频率。例如 ,只有两对坐标,频率分别是 、;位置 时,它们分别旋转 10 和 0.1 弧度。
这个公式可以计算任意位置,但模型的参数只在有限长度的数据上学过如何使用这些角度。
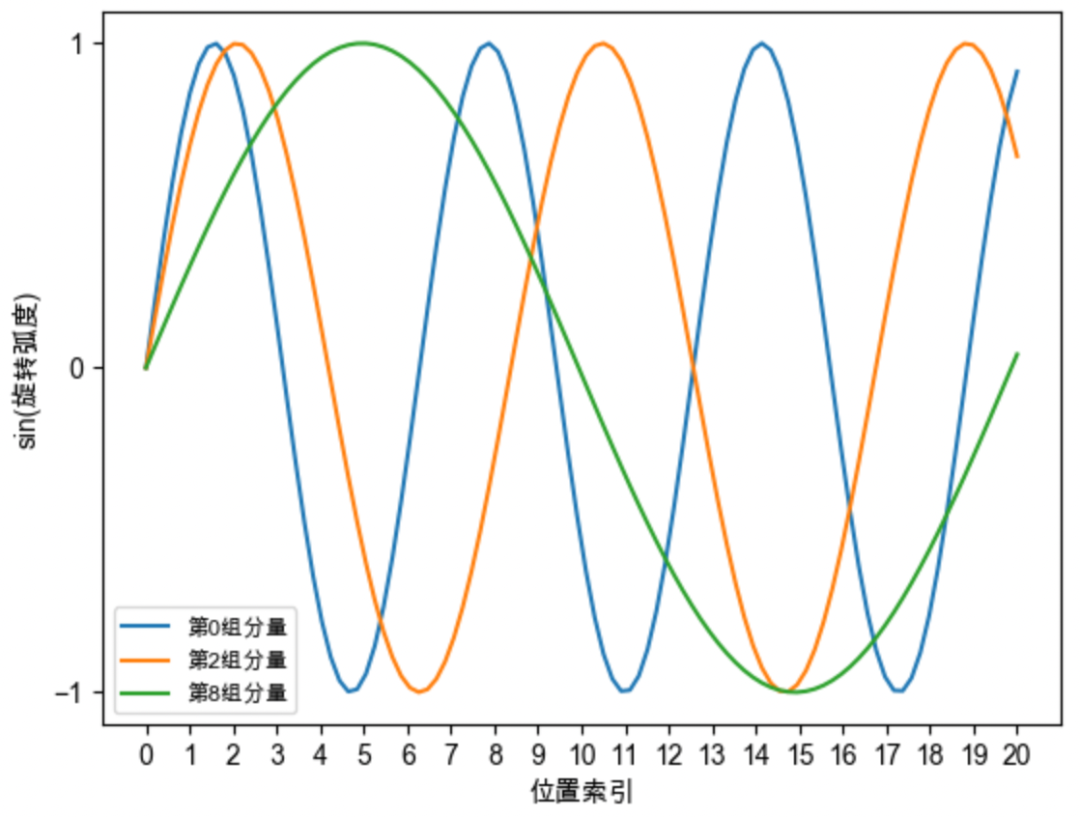
先只看横轴 0 到 20 这一小段:蓝线(第 0 组)转得最快,绿线(第 8 组)最慢;纵轴是 ,不是 attention 分数。两次相邻波峰之间的横向距离就是波长。这里的“频率高低”指同一组随 token 位置变化的速度,不是 token 出现的频率。
图源:ArronAI,《详解基于调整 RoPE 旋转角度的大模型长度外推方法》“周期性”部分;原图未改动。原始图片本地副本。来源页未见明确图片再许可声明,版权归原作者。
旋转会周期性地重复,高频分量在训练区间内可能已经转了好几圈。因此,超过训练长度并不意味着每个角度都是新的。问题在于,多个频率的组合、相对距离和文本依赖关系超出了训练时的覆盖范围,模型未必能正确利用它们;低频分量尤其可能在训练时只转过一个周期的一小段。
缩放位置或频率,是为了让长文本中的角度更接近训练时的范围,但它们不能单独保证长文理解能力。训练数据、微调方式、检索任务与长距离推理任务的差异,也会影响最终表现。
2. Position Interpolation(PI):统一缩放位置
2.1 把位置除以扩展倍数
PI 将位置换成 ,于是:
也就是说,位置除以 与所有频率除以 ,在旋转角度上等价。
例如从 4K 扩到 32K,。位置 16000 使用原来位置 2000 的旋转角度。对任意 ,都有 。
这只是把位置坐标压回连续区间,并不是把内容向量也变成了原来的向量,更不表示模型已经见过所有小数位置坐标或长度为 32K 的依赖关系。PI 原论文配合微调验证效果,不能把这一步当成不微调也能正常处理长文本的保证。PI 原论文
这里的位置坐标可以是小数,不会改变文本中的 token。比如原位置 0、1、2 经 缩放后,以坐标 0、0.5、1 计算角度,原来的三个 token 及其内容向量仍然保留。
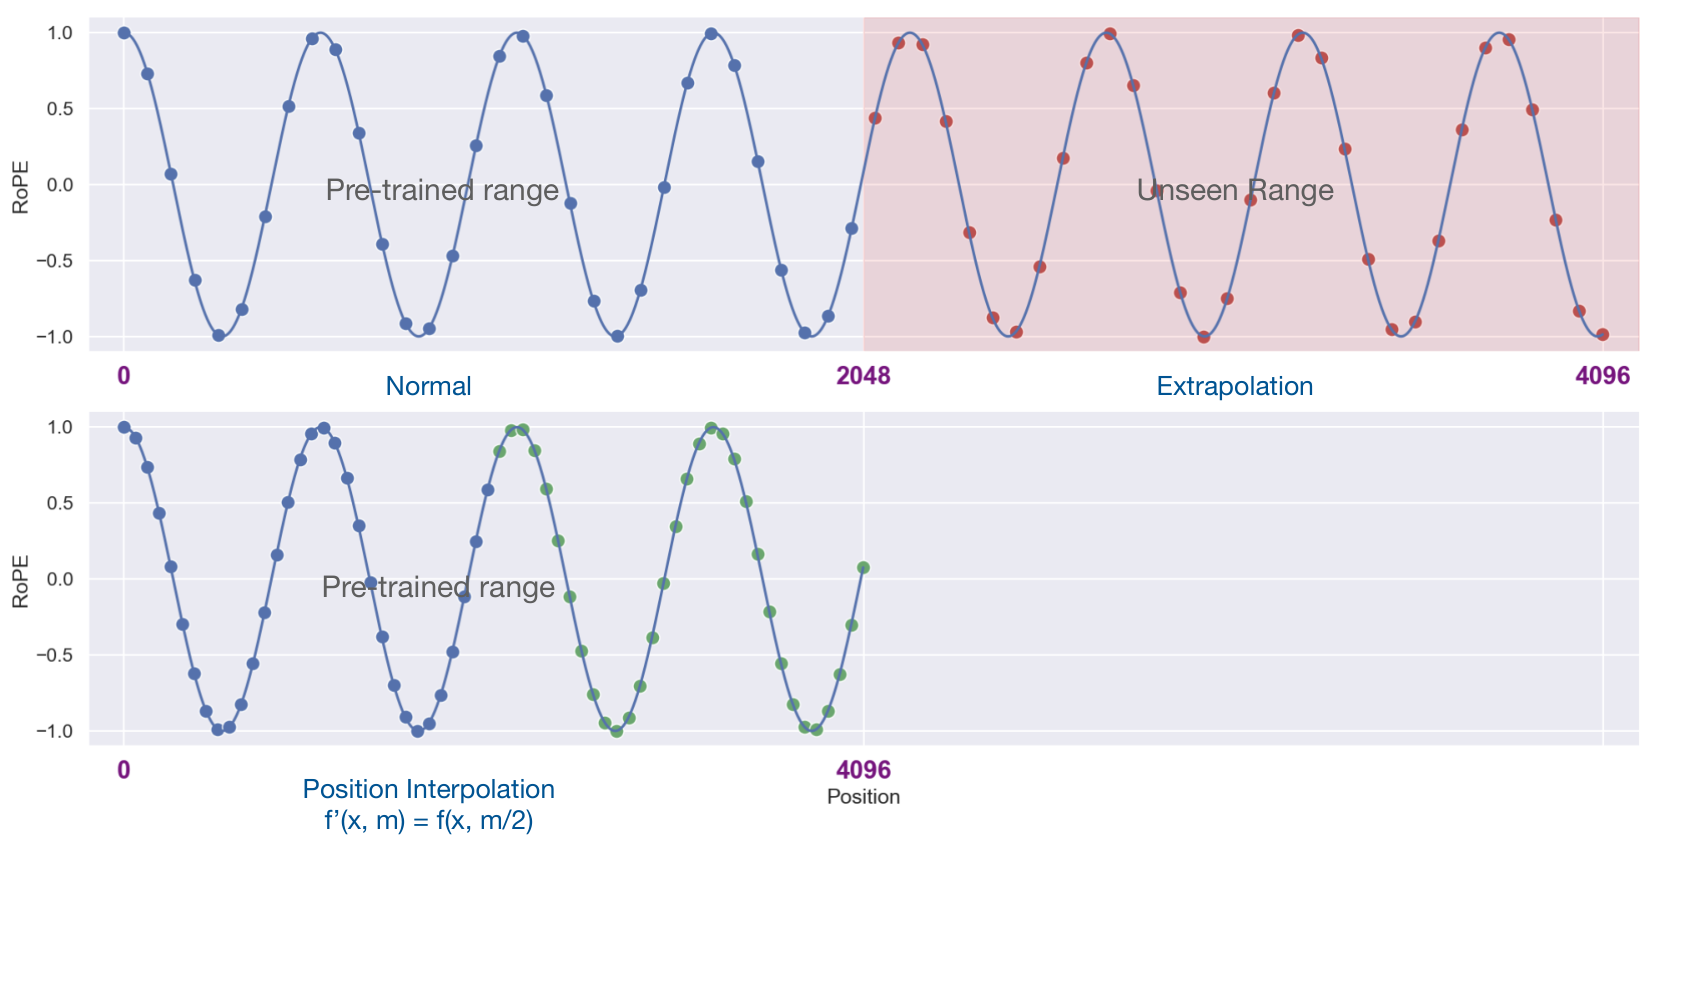
这张原图用的是 2048 扩到 4096,。上排红点继续走进原训练位置区间之外;下排把 4096 个位置用 放回原范围,因此采样点更密。下排标着 4096 的位置,使用的是原坐标 2048 附近的旋转角度。蓝色波形只画一个位置分量,不代表整个向量;“Unseen Range”也不是说红点的每个正弦值都从未出现过。
图源:Chen 等,PI 论文 Figure 1(论文、原图);CC BY 4.0,原图未改动。

2.2 代价是相邻位置的角度差也变小了
相邻位置的角度差从 降到 。例如最高频对 :
角度差从约 变成 。这解释了为什么统一缩放可能影响模型对短距离位置差异的利用。
上述角度差描述的是同一二维内容向量在相邻位置的旋转变化。不同 token 的 query、key 本身包含不同内容,一个 head 也包含多对坐标,因此无法仅凭角度差缩小就判断相邻 token 的最终向量是否接近。
PI 的规则简单,可以压缩所有频率对应的相位范围,但也会改变那些在训练期间已经覆盖了多个周期的高频分量。
3. NTK-aware Scaling:按频率调整缩放比例
3.1 让最高频不变,最低频缩小 s 倍
频率越高,相邻位置的角度变化越大;频率越低,完成一圈需要的距离越长。NTK-aware 希望最高频保持不变,最低频像 PI 一样缩小 倍,中间频率逐渐过渡。
它保留位置 ,只把 base 从 改成 :
NTK-aware 的命名来自 Neural Tangent Kernel 的启发。下面仅推导频率缩放公式,用到的是代数运算,不依赖 NTK 理论。
3.2 推导新的 base 应该是多少
最高频对应 ,无论怎样修改 base,始终有 。
最低频对应 。我们要求的是最低频的波长扩大 倍,不是让它恰好等于目标上下文长度:
把上式中 当成一个未知数,先两边取自然对数():
再两边取指数,得到:
这里也能看出为什么要求 :若只有一对坐标,即 ,它同时是最高频和最低频;当 时,既要求它不变、又要求它除以 ,两种目标无法同时满足。
把它代回每一对的频率,利用幂的乘法规则:
因此:
可以直接检查两个端点: 时比例为 1; 时比例为 。这也是 YaRN 论文附录 A.1 给出的约束。推导出处
例如 ,得到 。如果简单取 ,最低频比例是 ,并不严格等于 。
频率与波长成反比,因此最低频对应这些旋转对中最长的波长。
再用 做一个容易核对的对比。原频率是 :
- PI 得到 ,两对都慢一倍。
- NTK-aware 的新 base 为 ,频率得到 :快的一对不变,慢的一对慢一倍。
真实 head 通常有更多坐标对,中间频率便按指数 逐渐过渡。中间频率的缩放比例由最高频、最低频这两条约束共同确定。
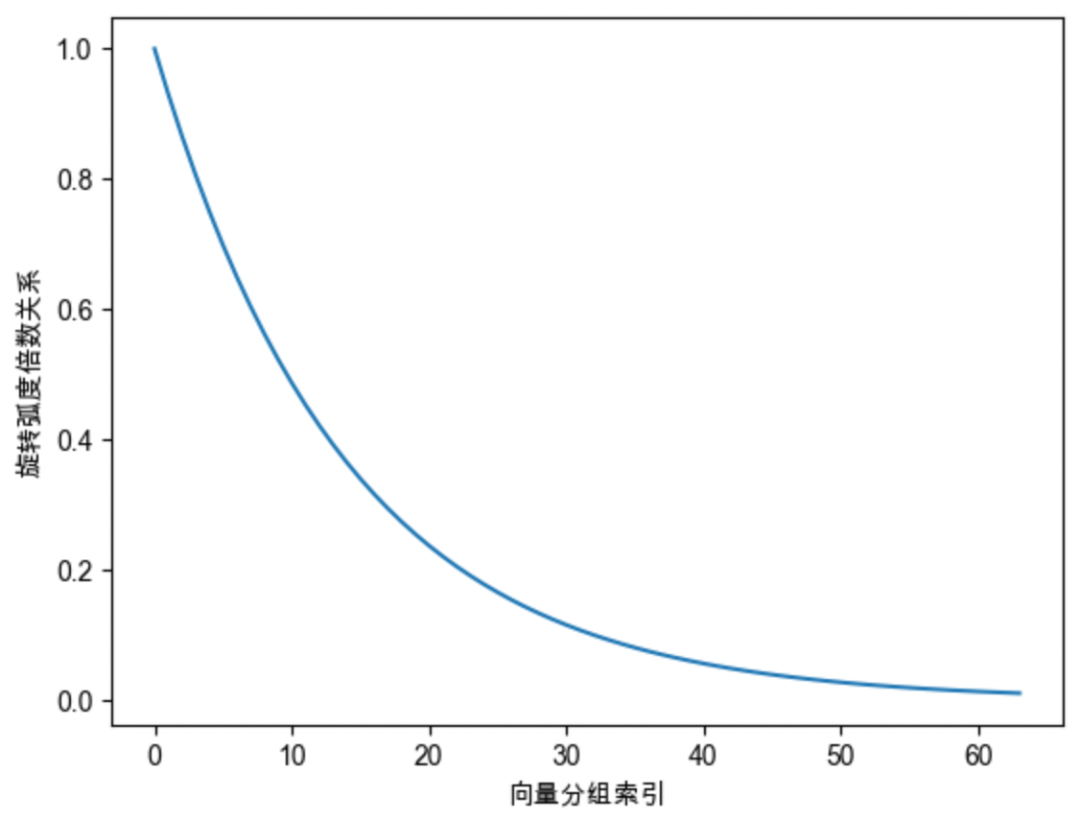
这张图把“越靠后的组,缩得越多”单独画了出来。横轴是旋转对编号,纵轴是新角度与原角度的比例;固定非零位置时,它也等于新频率与原频率的比例。左端为 1,向右逐渐接近 0。原图采用 base 放大 100 倍的例子,不是本文的 ;它适合看按维度逐渐变化的形状,精确端点仍应代入上面的公式计算。
图源:ArronAI,同文“NTK-Aware Interpolation”部分;原图未改动。原始图片本地副本。来源页未见明确图片再许可声明,版权归原作者。
3.3 改完以后,短文本会不会受影响
除 外,其他频率一般仍会变化,而且越低的频率缩小得越多。因此,即使保留了最高频,短文本中的 attention 也可能改变。
而且,它没有像 PI 一样把所有相位压回原区间。对某些高频对,长距离上的相位仍在外推。因此公式里的 是缩放参数,不能直接解释成“模型可靠理解长度必然增加 倍”。是否需要微调、有效扩展到多长,必须看具体模型与评测。
3.4 Dynamic NTK 随长度改频率,旧缓存怎么办
上面的推导是静态缩放:一次运行选定一个 ,所有位置使用同一套频率。
动态缩放则根据当前长度 调整参数。YaRN 论文给出的通用方式是:
不同库计算 Dynamic NTK 缩放比例的公式并不完全一样。例如 Transformers 4.44.2 的 dynamic 实现使用:
其中 是配置中的 factor。这里的 不能不加区别地当作上面的静态 。当 时,括号为 1,base 保持原值。固定版本实现
这一节属于实现细节,第一次只理解静态方案也可以继续读第 4 节。KV Cache 是生成时保存旧 token 的 key/value、避免重复计算的缓存。
动态调整还会影响 KV Cache:如果旧 key 已按旧频率旋转,新 query 却使用新频率,它们就不再遵循同一套相对位置公式。实现需要保持缓存与当前频率一致,例如保存旋转前的 key 再应用当前旋转,或正确重算缓存。因此,修改 base 时也需要同步处理缓存。
仅重旋转旧 key 可以统一本层显式的位置项,却不保证与按新频率重跑整段上下文完全相同:深层缓存来自旧的隐藏状态,而这些状态也受前面各层的 attention 影响。若要求结果与使用新频率重算整段上下文一致,应在本次生成中固定频率方案,或在频率变化后重新执行相应前向。
4. YaRN:高低频分别处理,再调整注意力温度
YaRN(Yet another RoPE extensioN)同时调整分段频率和 attention 分数的尺度。它从原始 RoPE 频率出发构造分段缩放,不需要先套用上一节 NTK-aware 的新 base。
4.1 先看每组坐标在训练长度内转了几圈
对原始频率定义:
表示按训练长度计算的旋转圈数。圈数多的高频分量保留原频率;圈数少的低频分量使用 PI;中间部分混合两者。
以 为例:
| 旋转对 | 波长 ,单位为 token 距离 | 圈数 |
|---|---|---|
| 0 | 6.28 | 651.90 |
| 16 | 62.83 | 65.19 |
| 32 | 628.32 | 6.52 |
| 63 | 54410.14 | 0.0753 |
不同频率对应不同的距离尺度,但这并不意味着模型中的高频只处理局部信息、低频只处理全局信息。
4.2 论文的 ramp:对圈数做线性过渡
YaRN 论文 §3.2 用两个圈数阈值 定义保留原频率的权重:
是一个 0 到 1 之间的混合权重,不是新的角度或频率。它为 1 时完全保留原频率,为 0 时完全采用 PI;取中间值时,两种频率各占一部分。英文 ramp 指中间这段从 0 线性增加到 1 的过渡。
再混合原频率与 PI 频率:
论文对 LLaMA 系列给出的经验值是 。因此:
- ,即 :完全使用 PI
- ,即 :保留原频率
- 两者之间:按圈数线性混合
这两个阈值用旋转圈数定义,因此过渡区间也按圈数线性插值;换成波长后,插值就不再是线性的。论文定义
例如某对坐标在训练区间转过 圈,正好在 1 与 32 的中间,于是 。当 时,新频率为:
实际计算只使用最后这一条新频率,不是把同一个向量分别旋转两次再平均。这里混合的是频率数值。
4.3 实际代码的 ramp:对维度编号做线性过渡
作者发布的代码与 Transformers 4.44.2 使用另一种过渡方式:先把圈数阈值换算成维度编号,再在编号之间线性变化。它与论文的圈数线性 ramp 都保留高频、缩小低频,但过渡区间的数值不完全相同。
代码按旋转对的编号保存频率,因此需要把圈数阈值换算成编号,确定过渡区间的起止位置。将 两边乘以 ,再取对数:
整理得到:
实现取 beta_fast 为高圈数阈值、beta_slow 为低圈数阈值,默认分别为 32 与 1。这两个字段对应的高低阈值需要与论文中的 区分。对本文参数,端点为:
下取整 与上取整 把连续边界变成数组里的整数编号。在这一有效范围内,令:
这里 表示采用 PI 的比例,而上一节的 表示保留原频率的比例。clip 表示把数值限制在 0 到 1 之间。实际实现还处理端点裁剪与重合的情况,不应只复制本例的 20、46。
例如 :
- 论文圈数 ramp 的频率比例约为
- 上面维度 ramp 的频率比例约为
可以把这两个“线性”逐项对照,而不要只看它们都用了 ramp 这个名字:
| 比较项 | 论文公式 | 上面的实现 |
|---|---|---|
| 在什么量上线性过渡 | 训练长度内转过的圈数 | 旋转对的编号 |
| 混合系数越大表示什么 | 越多保留原频率 | 越多采用 PI 缩放 |
| 本例编号 32 的新频率 / 原频率 | 约 0.28078 | 约 0.59615 |
两者分别对圈数和维度编号做线性插值,因此会产生不同的中间频率,这不是浮点误差。复现 checkpoint 时,需要沿用其实际采用的实现。作者实现、Transformers 4.44.2 实现
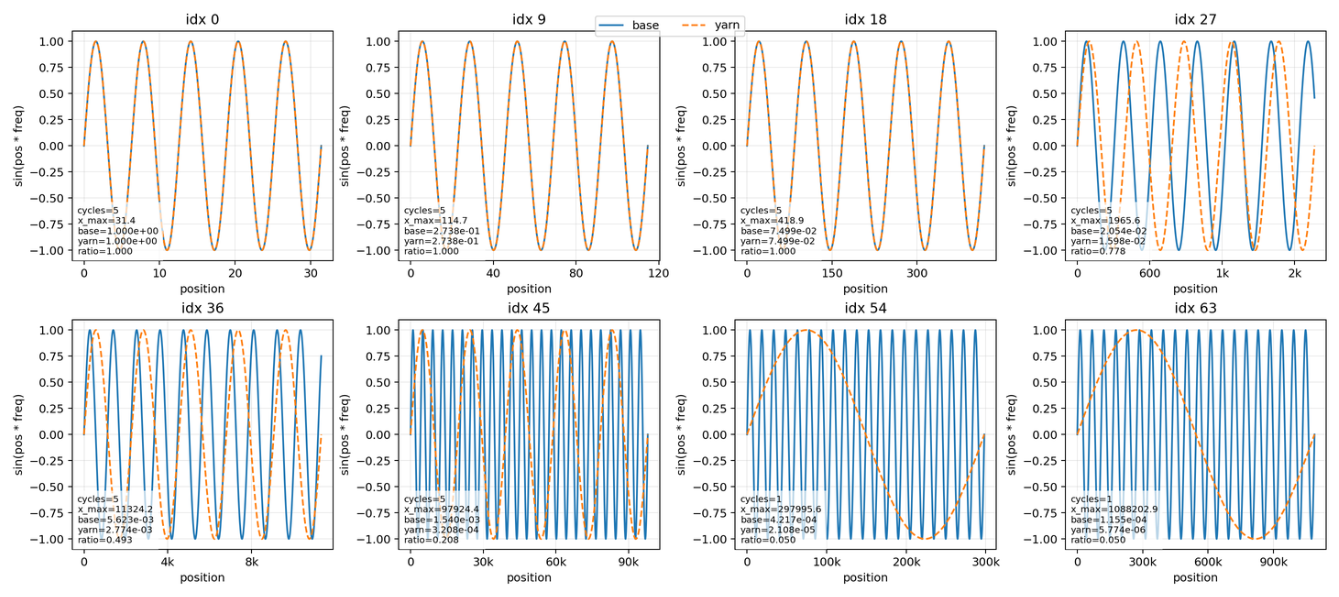
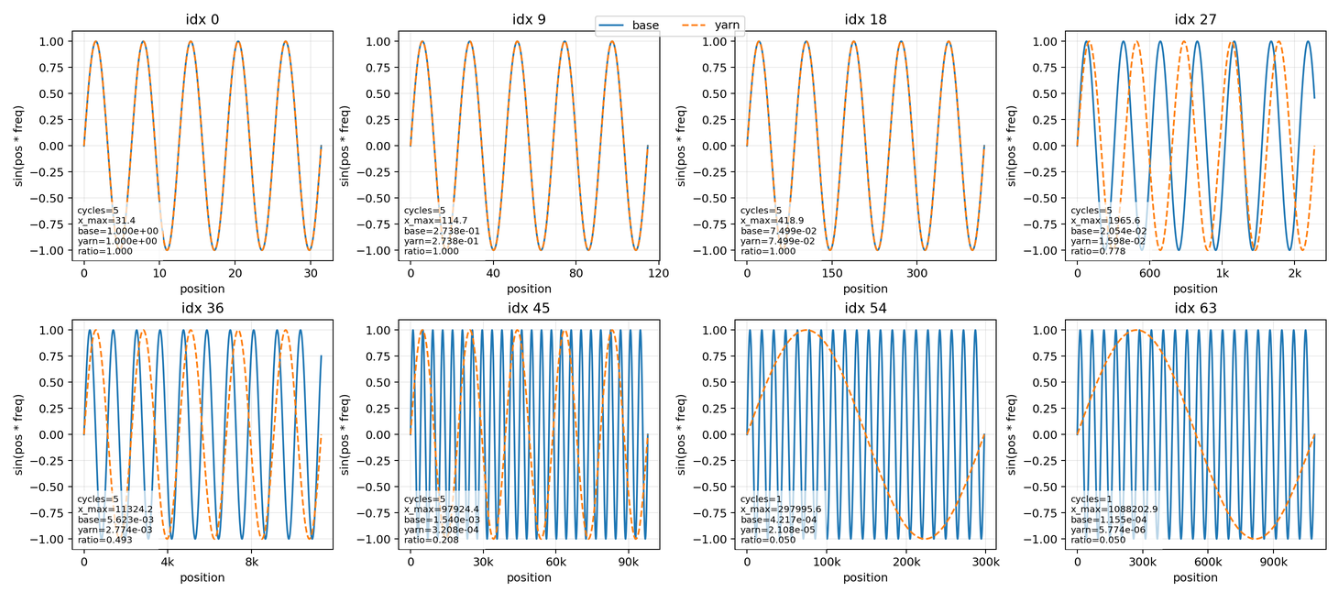
这组图展示了维度 ramp 的效果。蓝色实线是原始 RoPE,橙色虚线是 YaRN;每格的 idx 对应本文的旋转对编号 。原作者采用 ,阈值为 beta_fast=64、beta_slow=1,取整后的过渡边界是 20 和 50,与本文前面的数值例子不同。
按原图每格的 idx 编号,对照下面三组来看:
- **高频,:**两条曲线重合,频率比例
ratio=1。 - **过渡,:**橙线逐渐变慢;频率比例依次约为 0.778、0.493、0.208。这些数符合按编号混合 ,不能把它们拿去验证上一节的圈数 ramp。
- **低频,:**频率降为原来的 0.05,即 ,周期扩大 20 倍。
读图时尤其注意:各格的横轴范围不同,从几十个位置一直到一百多万个位置;只能在同一格内比较蓝线和橙线。最慢一组的长周期是频率计算结果,不表示模型已经可靠理解一百万 token。纵轴仍是正弦值,这组图也没有展示注意力温度的效果。
图源:Aleksa Gordić,Inside the Transformer: The Life of a Token,Figure 10(原图、查看原尺寸图)。保留原图,未修改曲线与数据。来源页未见明确图片再许可声明,版权归原作者。
4.4 调低注意力温度,具体怎么计算
先约定 是使用新频率旋转后的 query、key 矩阵,每行对应一个 token,形状为 ; 的形状为 。这里 是序列长度, 是 value 的维数。单个 head 的 attention 可写为:
把每个 query 与每个 key 的点积排成表,转置符号 用来把 key 的坐标轴与 query 对齐。表的一行对应一个 query,各列是它能读的 key;softmax 把这一行各分数取指数再除以指数总和,得到总和为 1 的权重,然后乘 汇总内容。
softmax 沿 key 方向计算; 是可见位置为 0、屏蔽位置为 的 mask。温度 ,越小会把同一组分数的差异放大。
YaRN 对 LLaMA/Llama 2 给出的经验关系是:
这里用 避免与位置 重名;它就是作者代码的 mscale,有些说明会把这个增益记成 ,写作 。ln 是自然对数。这个经验式适用于这里讨论的扩展范围 ,不是任意缩短上下文的公式,也不是从随机向量方差严格推导出的普遍定律。论文 §3.4 与附录 A.2
当 :
例如某 query 对两个可见 key 的原始缩放分数是 ,权重约为 。除以 后,分数成为 ,权重约为 。这个例子固定了原始分数,只比较温度的影响;实际更换频率时,匹配分数本身也会变化。
所以,YaRN 在这里降低温度,让同一组 attention 分数对应的概率更集中。 时,,恢复原来的尺度。
实现上不必改 softmax:把用于旋转的 cos 和 sin 都乘以 ,就让整个旋转后的 query、key 各乘以 ,从而:
将 query、key 乘以幅度系数会改变向量长度;单独调整旋转频率则仍保持长度不变。上式也用到了本文“整个 head 都参与旋转”的前提;只旋转部分维度时,不能直接声称整个内积都乘了同一个系数。
4.5 为什么不能用平均点积直接推导温度公式
本节分析期望内积公式成立的条件,说明它为什么不足以推导前面的经验温度公式。这部分可以选读,不影响频率与幅度公式的使用。 表示对随机向量取平均,矩阵中的某项就是相应两个坐标乘积的平均值。
对任意随机 query、key,并不存在无需条件的 。
例如,若旋转前的 相互独立且均值为零,旋转后的期望内积仍为零。一个能得到余弦求和的充分条件是:
其中 是对应坐标的共同二阶矩, 是 维单位矩阵。在此条件下,每个二维对有两个坐标,因而:
是对应位置的 RoPE 旋转矩阵。令 且各坐标二阶矩满足上述关系,是充分情形之一,不是必要条件。
即使条件满足,这个有限余弦和仍会振荡,不保证随距离单调下降;真实 attention 还取决于内容、其他 key 与 softmax 归一化。因此不能从“相对位置”直接推出“每个远 token 的注意力都更小”,更不能用它替代 YaRN 温度参数的实验依据。
5. YaRN 论文中的 Proof-pile 困惑度实验
下面用困惑度 PPL 评价模型对测试文本中实际出现的下一个 token 的预测:先对各真实目标的负对数概率取平均,再取指数。例如每一步都给真实 token 概率 ,PPL 就是 4。它更低,表示在相同评测条件下,模型给这份文本中实际出现的 token 分配了更高的几何平均概率,不等于长文问答准确率必然更高。
下面摘录 YaRN 论文 v2 表 1 的部分列。实验使用 10 篇至少有 128K token 的 Proof-pile 文档,采用步长为 256 的滑动窗口方法计算 perplexity(PPL,越低越好)。三个模型的扩展训练窗口都是 8K;训练 token 数并不相同。论文表 1
| 方法 | 训练 token 数 | 2048 上下文 PPL | 4096 上下文 PPL | 8192 上下文 PPL | 10240 上下文 PPL |
|---|---|---|---|---|---|
| PI, | 1B | 3.92 | 3.51 | 3.34 | 8.07 |
| NTK,base 为 20000 | 1B | 4.20 | 3.75 | 3.59 | 6.24 |
| YaRN, | 400M | 3.91 | 3.50 | 3.35 | 6.04 |
这组结果表明,YaRN 在这次实验中使用较少训练 token,取得了与 PI 接近的窗口内 PPL。它不是所有列都最好,例如在 8192 长度上,PI 的 3.34 略低于 YaRN 的 3.35。
这张表只比较上述 Proof-pile 实验中的 PPL。长文检索与复杂推理衡量的是不同能力;比较缩放方法时,还需要指定模型、训练量和评测流程;这张表不足以说明哪种方法在所有任务中都最好。关于 PPL 的计算与比较条件,可接着读 Perplexity。
6. 用代码检查公式,再配置 Transformers
6.1 可独立运行的公式检查
下面只依赖 Python 标准库,返回频率与幅度增益,不加载模型。ramp="cycles" 对应论文公式;ramp="dimension" 对应前述固定版本的默认维度 ramp 计算方式。变量 dim 指参与旋转的维数。
import math
def yarn_parameters(dim=128, base=10000.0, scale=8.0, train_length=4096, beta_slow=1.0, beta_fast=32.0, ramp="dimension"): if not isinstance(dim, int) or dim <= 2 or dim % 2: raise ValueError("dim must be an even integer greater than 2") if not math.isfinite(base) or base <= 1: raise ValueError("base must be finite and greater than 1") if not math.isfinite(scale) or scale < 1: raise ValueError("scale must be finite and at least 1") if not math.isfinite(train_length) or train_length <= 0: raise ValueError("train_length must be positive and finite") if not (math.isfinite(beta_slow) and math.isfinite(beta_fast) and 0 < beta_slow < beta_fast): raise ValueError("require 0 < beta_slow < beta_fast") if ramp not in {"cycles", "dimension"}: raise ValueError("unknown ramp")
def clip01(value): return max(0.0, min(1.0, value))
def boundary(rotations): return dim * math.log(train_length / (2 * math.pi * rotations)) / ( 2 * math.log(base) )
# Match the boundary convention of Transformers 4.44.2. lower = max(0, math.floor(boundary(beta_fast))) upper = min(dim - 1, math.ceil(boundary(beta_slow))) width = upper - lower if upper != lower else 0.001
frequencies = [] for i in range(dim // 2): theta = base ** (-2 * i / dim) if ramp == "cycles": rotations = train_length * theta / (2 * math.pi) keep = clip01((rotations - beta_slow) / (beta_fast - beta_slow)) else: keep = 1 - clip01((i - lower) / width) frequencies.append(theta * (keep + (1 - keep) / scale))
amplitude = 1 + 0.1 * math.log(scale) return frequencies, amplitude
frequencies, amplitude = yarn_parameters()assert len(frequencies) == 64assert math.isclose(frequencies[0], 1.0)assert math.isclose(frequencies[-1], 10000 ** (-126 / 128) / 8)assert math.isclose(1 / amplitude**2, 0.6853403266295983)这段程序用于检查数学关系,不涉及张量布局、KV Cache 或模型质量。维度 ramp 的边界裁剪与前述指定版本一致,其他 YaRN 实现可能不同。即使函数能正常计算,极端参数是否适合模型仍需单独验证。
6.2 固定版本的 Hugging Face 示例
以下示例针对 Transformers 4.44.2 的 Llama 实现,仅构造 RoPE 层,用三个位置检查输出形状,不下载或训练模型。LlamaRotaryEmbedding 是内部类,升级版本后应重新核对。
# Requires torch and transformers==4.44.2.import torchimport transformersfrom transformers import LlamaConfigfrom transformers.models.llama.modeling_llama import LlamaRotaryEmbedding
assert transformers.__version__ == "4.44.2"
config = LlamaConfig( hidden_size=4096, num_attention_heads=32, # head dimension = 128 max_position_embeddings=4096, rope_theta=10000.0, rope_scaling={ "rope_type": "yarn", "factor": 8.0, "beta_fast": 32.0, "beta_slow": 1.0, },)rotary = LlamaRotaryEmbedding(config=config, device="cpu")x = torch.zeros(1, 3, 128)position_ids = torch.tensor([[0, 1, 32767]], dtype=torch.long)cos, sin = rotary(x, position_ids)assert cos.shape == sin.shape == (1, 3, 128)这里保留 max_position_embeddings=4096,因为 4.44.2 的 YaRN 函数直接用这个字段计算原训练长度对应的 ramp;不能同时把它改成 32768,再期待另一个字段自动纠正。在这一版本的 YaRN 路径里,original_max_position_embeddings 不是用于上述计算的替代字段。配置与计算源码
该版本返回的 attention_factor 是上文的幅度 ,随后乘在 cos、sin 上;它不是温度 ,也不是直接把 logits 乘以 。Llama 调用位置
实际使用时,应优先遵循目标 checkpoint 的模型卡、配置与兼容版本,避免覆盖已经训练好的 RoPE 设置。位置 32767 能算出旋转值,只证明公式可计算;有效上下文长度、生成质量、KV Cache 显存以及推理服务的长度上限,都还需要分别确认。
标准库示例可在 CPU 上检查频率和幅度的数值关系。Hugging Face 示例尚无真实模型或 GPU 的运行测试结果,使用时需在对应版本的环境中检查输出。
7. 小结:三种方法分别改了哪些频率
| 方法 | 对频率做了什么 | 使用时的限制 |
|---|---|---|
| PI | 所有频率除以 | 压缩位置范围,也改变短距离角度差 |
| 静态 NTK-aware | 改 base,让最高频不变、最低频除以 | 其他频率仍变动,部分频率仍外推 |
| Dynamic NTK | 随当前长度更新 NTK 参数 | 具体公式依赖实现,需处理 KV Cache 一致性 |
| YaRN | 高频保留、低频 PI、中间混合,再放大 query/key | 论文 ramp 与代码 ramp 要区分,温度是经验设置 |
改完位置编码后,模型还需要能用好这些新的旋转角度,实际效果要在目标任务上测试。使用长上下文配置前,应确认原训练长度、实现中采用的频率公式,以及目标长度对应的训练和评测条件。
参考资料
- Chen et al. Extending Context Window of Large Language Models via Positional Interpolation,2023
- Peng et al. YaRN: Efficient Context Window Extension of Large Language Models,v2,2023;本文对应 §3、附录 A.1/A.2 与表 1
- YaRN 作者代码,用于核对维度 ramp 与
mscale;分支可能更新,固定版本对照见下一项 - Transformers v4.44.2:modeling_rope_utils.py,用于核对
linear、dynamic、yarn的区别 - Transformers v4.44.2:Llama 实现,用于核对
cos、sin的幅度缩放 - Su et al. RoFormer: Enhanced Transformer with Rotary Position Embedding,RoPE 原论文
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。