这是大模型系列中「显存」子系列的第四篇。上一篇微调时怎样节省显存讨论了训练时的参数、梯度与激活;训练完成后,接下来要让模型生成回答。这篇沿一次生成的执行顺序,先看 Prefill / Decode 与 KV 复用,再算权重、缓存和工作区,最后排查 OOM。
普通推理不更新参数,通常也不需要加载梯度和优化器状态。关闭梯度记录后,各层中间结果不必留给反向传播,临时空间在计算后可以释放或复用。但生成后续 token 时还要读取历史 K/V,因此 KV Cache 会跨步骤保留。估算时要重新计算实际仍在使用的张量,不能直接沿用训练显存的固定倍数。
如果还不熟悉 token 怎样经过模型,可以先读 Transformer Decoder 入门。这里不展开采样策略;logits 怎样选出下一个 token,见解码策略。只想估算容量,可以跳到 Llama 参数计数;KV 的完整手算保留在第 2 节。
0. 先确定模型版本和计算条件
下面以原版 Meta Llama-3-8B 为例,默认单设备、完整权重、BF16、无 offload(不把权重或缓存移到 CPU 内存等位置),后续 Llama 版本的参数和限制可能不同。原版支持 8,192 token 上下文;文中的 32K/128K 只用于按相同架构计算更长缓存的大小,不能当成该 checkpoint 的部署能力。Meta 官方说明也指出其示例会按最大长度和 batch 预分配缓存。
沿用显存基础的单位约定: 是参数个数, 是 bytes;、、 分别是权重、KV 和某个临时张量每元素的字节数。容量统一以 GiB 对照,必要时另列 GB。
判断某张卡能否运行模型,先算权重和缓存,再用选定的引擎测试峰值。同一张卡能否跑得下,还会随长度、并发和实现而改变。
1. 一次生成先做 Prefill,再做 Decode
比如输入经过分词有 3 个 token:第一次把 3 个一起送进模型,称为 prefill,末位置的输出可以选出第 4 个 token。接下来把刚选出的第 4 个 token 送入模型,并读取前 3 个的缓存,便能选出第 5 个,这一步称为 decode。用户看到了第 4 个 token,并不表示第 4 个的 K/V 已经算好;它在下一次前向时才写入。
Prefill 处理一段输入并建立 KV;decode 通常为每个活动请求处理一个新 token,复用已有 KV。
下图用 表示本次处理的 Query 数, 表示可访问的总 Key 数, 表示一个注意力头的向量维度。
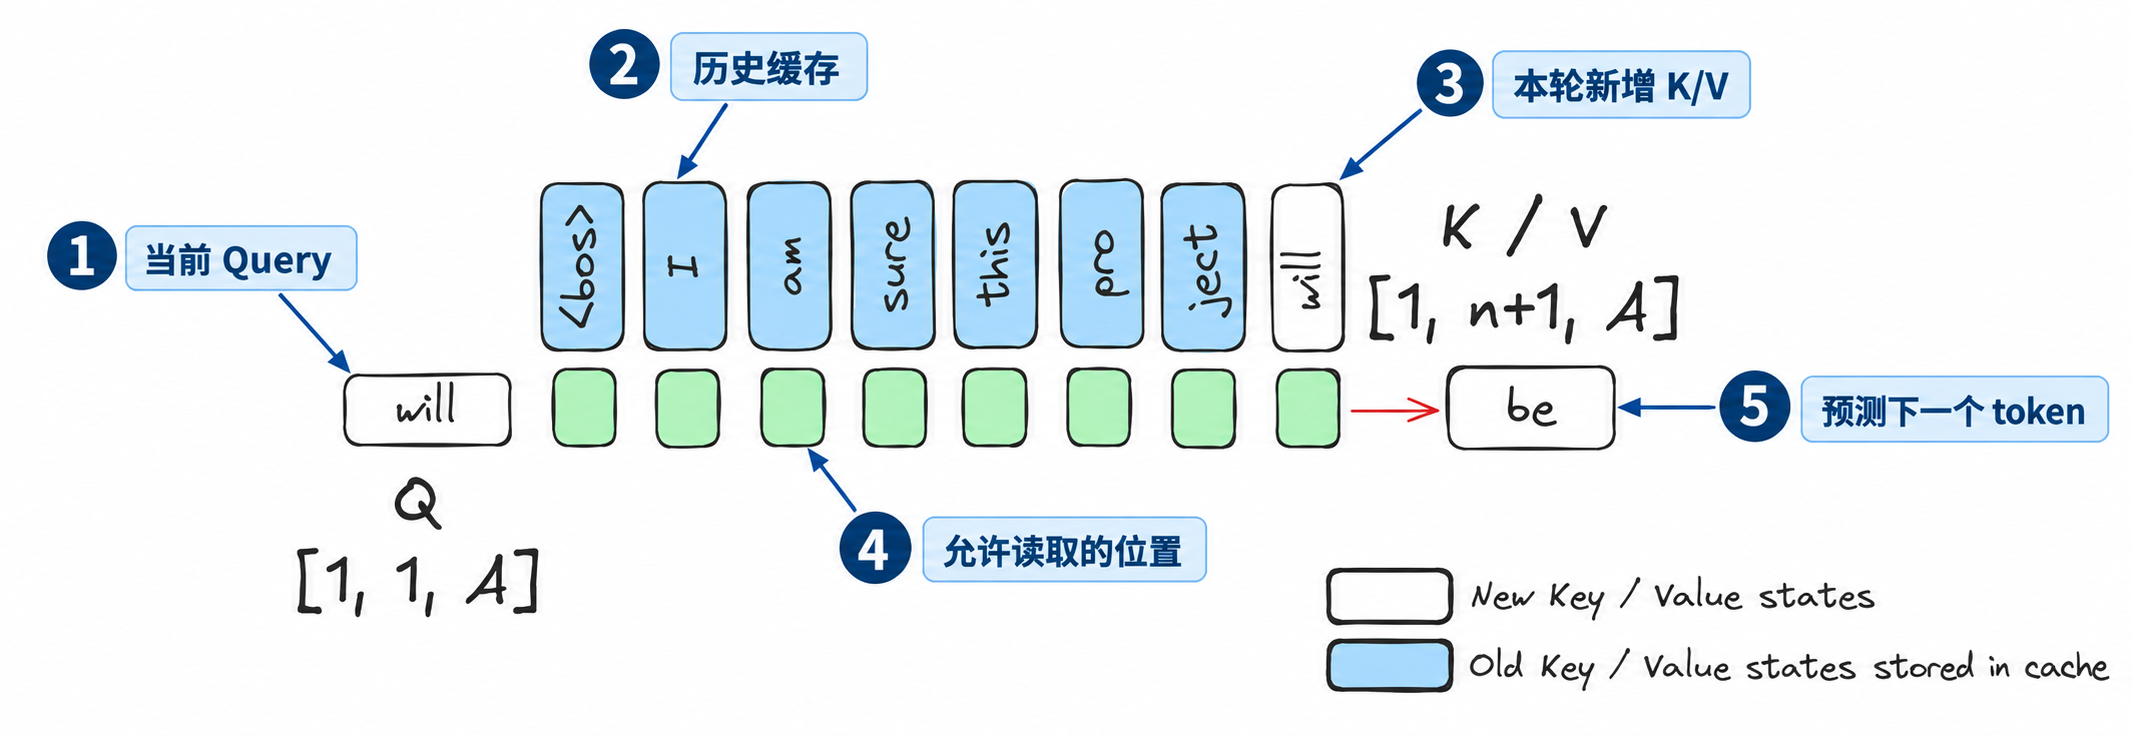
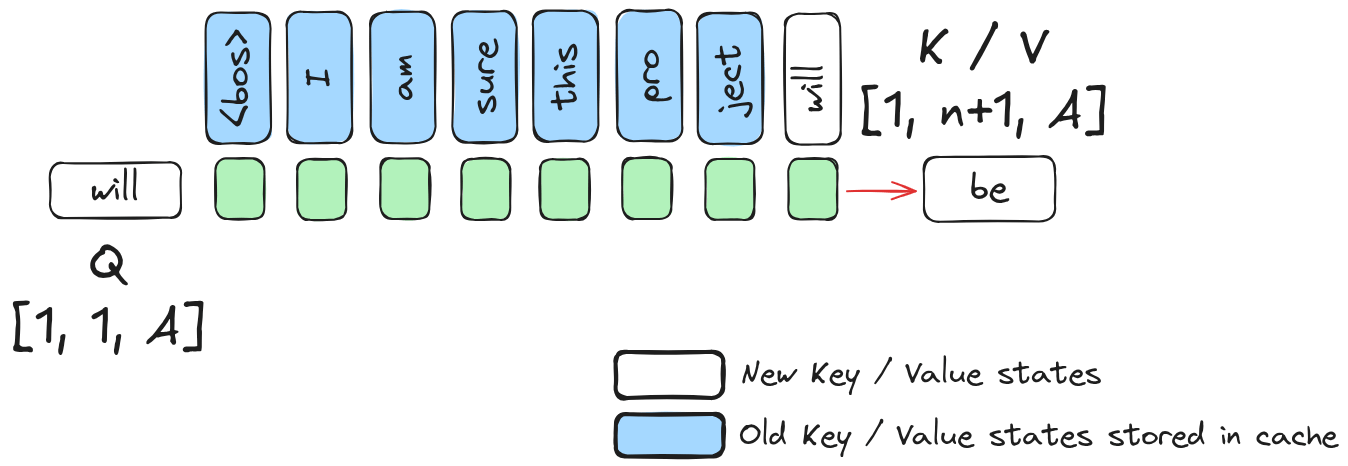
图:单步 decode 的 KV Cache,中文编号与引线为辅助标注。原图:Rémi Ouazan Reboul、Arthur Zucker、Luc Georges(Hugging Face),Continuous batching,CC BY-NC-SA 4.0。查看未加中文标注的原图。
- ① 当前 Query: 左侧
will是本轮已知输入,只有一个 Query,所以绿色区域只有一行;[1,1,A]依次表示 batch、Query 数、头维度。图按单个 attention head 简化, 对应本文 。 - ② 历史缓存: 蓝色的
<bos>到ject已有各自的 K、V,无需本轮重新计算;图把同一位置的两份向量合写为 K / V。缓存保存的是向量,不是此前的 attention 权重。 - ③ 本轮新增 K/V: 上方白色
will的 K、V 追加到缓存,因此[1,n+1,A]的中间一轴是历史 个位置加当前 1 个。本轮 、,每步 Query 数不变,缓存长度却继续增长。 - ④ 允许读取的位置: 绿色格表示当前 Query 可以读取全部这些位置,并不表示权重相同。实际权重仍由点积分数和 softmax 决定,不能看到同色就平均分配。
- ⑤ 预测下一个 token: 右边红箭头指向
be,代表经过模型后续处理得到的下一个 token。此时新增缓存的是will,还不是be;下一步把be作为输入时,才计算它的 K、V。
长 prompt 的 Prefill 更容易形成较大的矩阵乘;小 batch Decode 每步工作量小,却仍要读取权重和历史 KV,常受内存带宽限制。两者不能被固定称为「算力阶段」或「带宽阶段」:batch、上下文、硬件和实现都会改变瓶颈。SARATHI 论文据此讨论了 Prefill / Decode 调度。首 token 延迟、逐 token 延迟和整体吞吐也应分开观察。
图中历史 K/V 为什么可以直接拿来用?关键是因果注意力下,后来追加的 token 不会改变旧位置的结果。
2. KV Cache 为什么能复用历史结果
下面用前向公式和一个单头手算解释缓存更新。先理解「旧位置不受新 token 影响」,再看每层具体缓存了什么;算例可以按需阅读。
以下仍讨论 decoder-only、causal self-attention、普通推理模式。单头手算暂省略 batch、多头拼接、位置变换和输出投影;隐藏维度记作 ,每头维度记作 ,不把二者混用。
2.1 Key 向量与投影权重
设某层当前 token 的输入是行向量 ,单个 attention head 的维度为 。这一层的投影参数为:
当前 token 的 Query、Key、Value 分别是:
是模型参数,推理时通常不变; 是对一个 token 算出的向量。把不同位置的 按行放在一起,才得到随上下文增长的 。追加新 token 时增长的是 K 和 V,不是 W_K 和 W_V。
在带 RoPE 的模型中,Query 和 Key 还要按正确的位置进行旋转,通常缓存已经完成位置变换的 Key。具体缓存内容应与模型实现一致,不能为了复用而改变位置编号。
2.2 为什么历史结果可以复用?
因果注意力中,旧位置不能看到后来追加的 token。在模型参数、位置编码和旧上下文不变,且关闭训练随机性的条件下,追加 token 不会改变旧位置在各层的结果。
因此,已经处理了 个 token 时,可以保存每一层的:
当前只需计算 ,沿序列维追加:
然后计算新位置这一行 attention:
这里需要区分三个对象:
- 是点积分数
- 是完成缩放并加上 mask 的 attention scores
- 是 softmax 后、和为 1 的 attention weights,用它与 V 相乘
softmax 把每个分数取指数,再除以全部允许位置的指数之和:。其中 是当前要算权重的位置, 遍历所有允许关注的位置。例如分数 变成权重 ;为避免数值溢出,可以先给所有分数减去同一个最大值,结果不变。这里 是自然对数, 是它的反函数。
在允许关注的位置取 0,在被屏蔽的位置取 。若缓存中只有过去和当前的有效 token,这一行没有未来位置需要屏蔽;批处理的 padding、预分配缓存的空槽位仍需处理。 只是这一层这个 head 的输出,还要经过剩余网络和词表投影才能预测下一个 token。Transformer 原论文给出了 scaled dot-product attention 的定义。
2.3 三个位置的单头注意力算例
下面用三个位置的假想隐藏向量演示一次单头计算,不把它们当作某个真实单词的向量。设 :
前两个位置计算完成后,缓存是:
来到第三个位置,只计算新向量 、、,追加后得到:
第三个位置可关注全部三个位置,因此:
也可以把三个位置一起重算,在完整 的 score 矩阵上加 causal mask,再取第三行,结果相同。KV Cache 省掉的是旧位置的重复投影和重复网络计算;这一行仍然要读取历史 K、V 并做 attention。
核算时先检查投影、缩放、softmax 权重和加权求和四步;把缓存路径与整段重算的第三行对照,可以检查复用是否改变了结果。
2.4 缓存省了多少计算,什么时候会失效
对于单层单头,处理新位置的 attention 计算量随缓存长度 增长,约为 。KV Cache 省掉了重复计算,但上下文越长,新 query 仍需要读取越多的 K/V,因此 Decode 的计算量不会一直不变。每一层都要保留自己的 K/V;怎样按多层、多请求和 KV 头数核算容量,见第 4 节的容量公式。
缓存也不是无条件复用:如果旧 prompt、模型权重、位置处理方式改变,原有缓存可能失效。滑动窗口、GQA/MQA、缓存量化或分页管理会改变保存方式,应分别分析。Prefill/Decode 的缓存形状和更新流程可对照 Hugging Face Caching 文档。
思考:为什么通常不缓存历史 Query?
普通自回归 Decode 要计算的是新位置的输出,所以需要当前 Query 查询历史 K、V。历史 Query 用于计算历史位置的输出,下一轮无需再计算那些输出,自然不需要保存它们供这一步使用。这是当前生成流程下的结论,不代表 Query 在任何算法里都不能缓存。
3. Llama-3-8B 的参数量与权重显存
3.1 一个 token 会经过哪些层
为核算参数,只需记住这条路径:token ID 经 embedding 变成长度 的向量,经过 个 Transformer block,再由 LM head 投影成 个词表分数。每个 block 包含 attention、FFN 和归一化层。
是隐藏维度, 是层数, 是词表大小。attention head 是注意力中的一路投影与汇总,不是输出词表分数的 LM head;每个注意力头的维度是 。下面分别数 Query 与 KV 的投影宽度,再数 FFN 和词表矩阵。
| 超参数 | 符号 | Llama-3-8B 的值 |
|---|---|---|
| Transformer 层数 | 32 | |
| 隐藏维度 | 4,096 | |
| query 头数 | 32 | |
| KV 头数 | 8 | |
| 每头维度 | 128,且 | |
| FFN 中间维度 | 14,336 | |
| 词表大小 | 128,256 |
这些结构值可从 Meta 模型配置和模型实现核对。输入 token embedding 与输出 LM head 不共享权重;线性层没有 bias,RMSNorm 各有 个缩放参数。RoPE 的频率等 buffer 不属于可训练参数。
3.2 逐个数注意力和 FFN 的权重矩阵
以下矩阵用「输入维度 × 输出维度」记法。PyTorch Linear.weight 常按相反顺序存储,但参数个数相同。
| 每层矩阵 | 形状 | 参数个数 |
|---|---|---|
| 16,777,216 | ||
| 4,194,304 | ||
| 与 相同 | 4,194,304 | |
| 16,777,216 | ||
| 注意力小计 | 41,943,040 | |
FFN gate_proj | 58,720,256 | |
FFN up_proj | 与 gate_proj 相同 | 58,720,256 |
FFN down_proj | 58,720,256 | |
| SwiGLU FFN 小计 | 176,160,768 | |
| 两个 RMSNorm | 8,192 | |
| 单个 Transformer block | 上述各项之和 | 218,112,000 |
这里先数模型里有多少个参数,下一步才乘以每个参数占用的字节数,换算成权重显存。
为什么 FFN 有三个矩阵?对一个行向量 ,Llama 的 SwiGLU FFN 可写成 。前两路都把 个数变成 个数,再逐元素相乘(),最后投影回 ;SiLU 是一个逐元素非线性函数。这就对应两份 与一份 。RMSNorm 则调整向量尺度并逐维乘上可训练系数,所以每个 norm 只数 个参数。计算参数量时,知道这些矩阵各自的作用即可,暂时不必掌握每个算子的完整推导。
3.3 加上词表矩阵和末层 RMSNorm,得到总参数量
两个词表矩阵各有 个参数;32 层 block 共 6,979,584,000 个;最后的 RMSNorm 还有 4,096 个。因此:
一份未分片、使用同一存储宽度的裸权重满足 。BF16 的 ,因此:
FFN 占单个 block 约 80.8%,占全模型约 70.2%。 前者是 ;后者是 。因为全模型还包含两个大词表矩阵,不能把「block 内 80%」直接说成全模型占比。
这也说明 FlashAttention 不会缩小已加载的权重:它优化的是注意力执行方式,权重矩阵本身仍在。
3.4 不同位宽下的权重数据大小
| 存储方式 | 字节/参数 | Llama-3-8B 裸权重 GiB |
|---|---|---|
| FP32 | 4 | 29.9151 |
| BF16 / FP16 | 2 | 14.9575 |
| FP8 / INT8 | 1 | 7.4788 |
| 打包 INT4 | 0.5 | 3.7394 |
各行采用上面逐个矩阵算出的 8,030,261,248 个参数;不能把模型名称里的「8B」直接当作精确参数量。
低位宽各行只计算所有参数采用同一位宽时的权重本身的数据大小,未计 scale、可能的 zero-point、高精度层和对齐,不是 checkpoint 或运行进程的实测大小。分片、offload、混合 dtype 和共享权重还会改变每张卡的显存占用;MoE 也不能只按每个 token 使用的参数量估计全部已加载权重。
4. KV Cache 的内容与容量计算
4.1 缓存前文的 K 和 V,省掉重复计算
KV Cache 为后续 token 保存每层历史位置的 K/V;过去的 Query 不属于这份持久缓存。为什么旧结果可复用,以及新 token 如何与旧缓存拼接并得到输出,完整推导与手算例子见第 2 节的缓存前向机制。下面只计算这份缓存需要多少存储。
4.2 MHA、GQA、MQA 对应不同 KV 头数
| 机制 | 关系 | 含义 |
|---|---|---|
| MHA(Multi-Head Attention) | 每个 query head 有一组 K/V | |
| GQA(Grouped-Query Attention) | 常见为 | 每组 query heads 共用一组 K/V |
| MQA(Multi-Query Attention) | 所有 query heads 共用一组 K/V |
通常每组包含 个 query heads,要求能均匀分组;GQA 也可广义地包含 MHA 和 MQA 两个端点。Llama-3-8B 是 32 个 query heads、8 个 KV heads,每组 4 个 query heads。GQA 论文讨论了这些架构之间的取舍。
共享的是 K/V,不是所有 query 的 attention scores。因此缓存按 数,显式分数张量仍按 数。高效实现可直接复用 KV;若 kernel 临时展开 KV 到 query 头数,那是额外工作区,不应误记成架构规定的持久缓存。
把“共享 K/V”画出来,就不容易把 Query 头数误代进缓存公式。
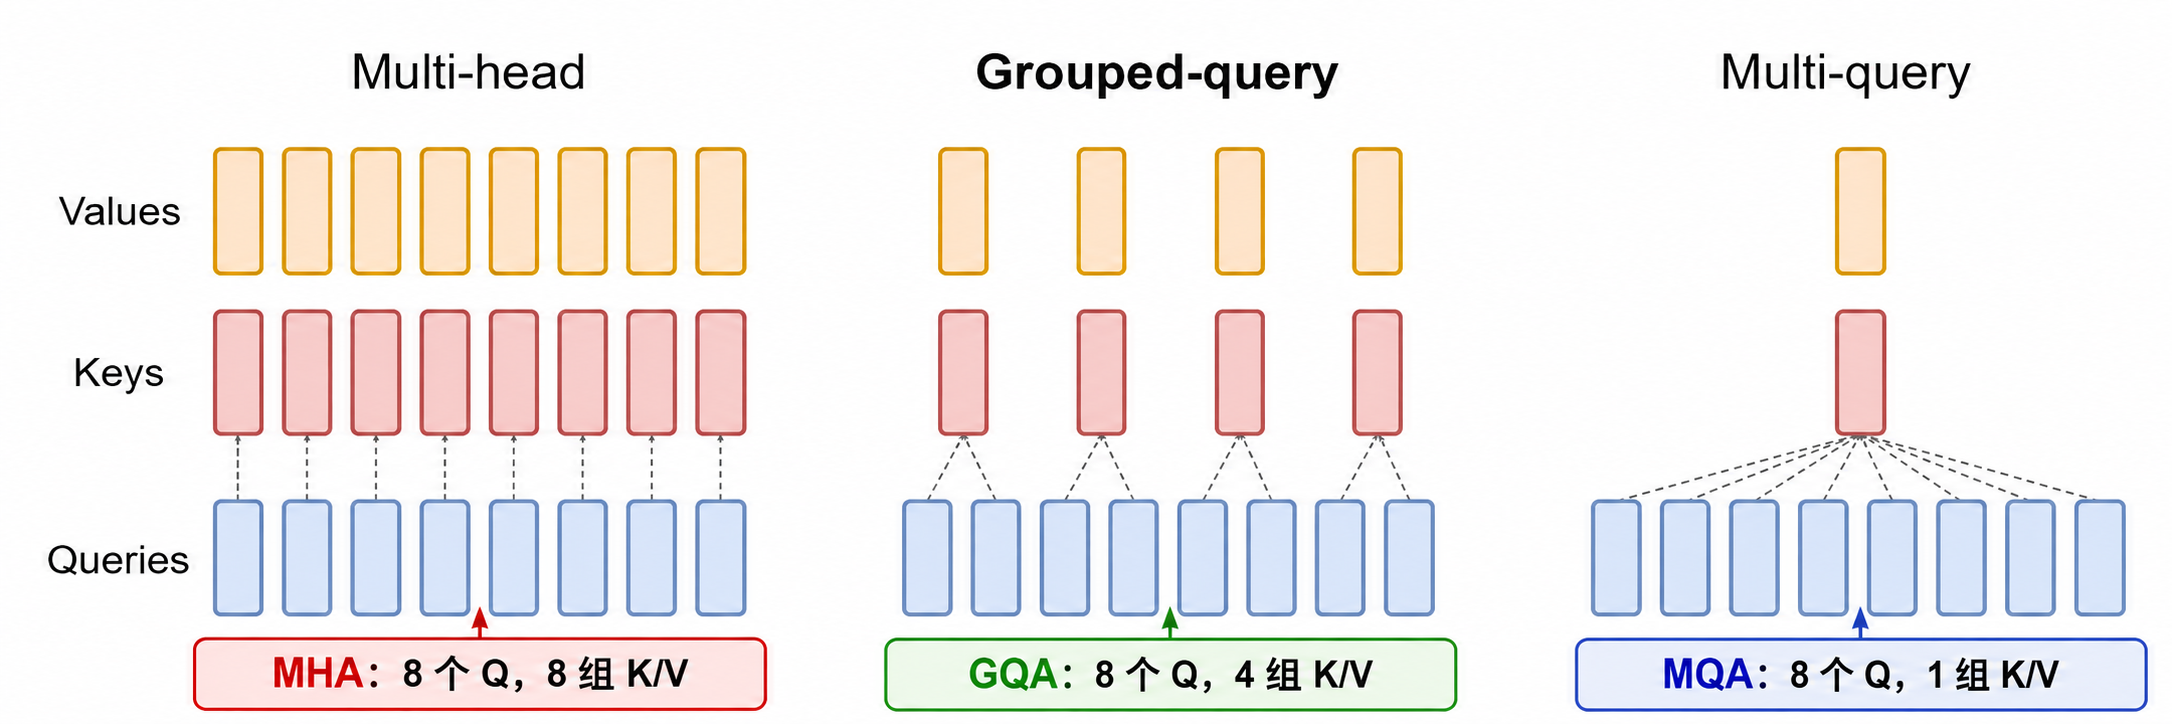
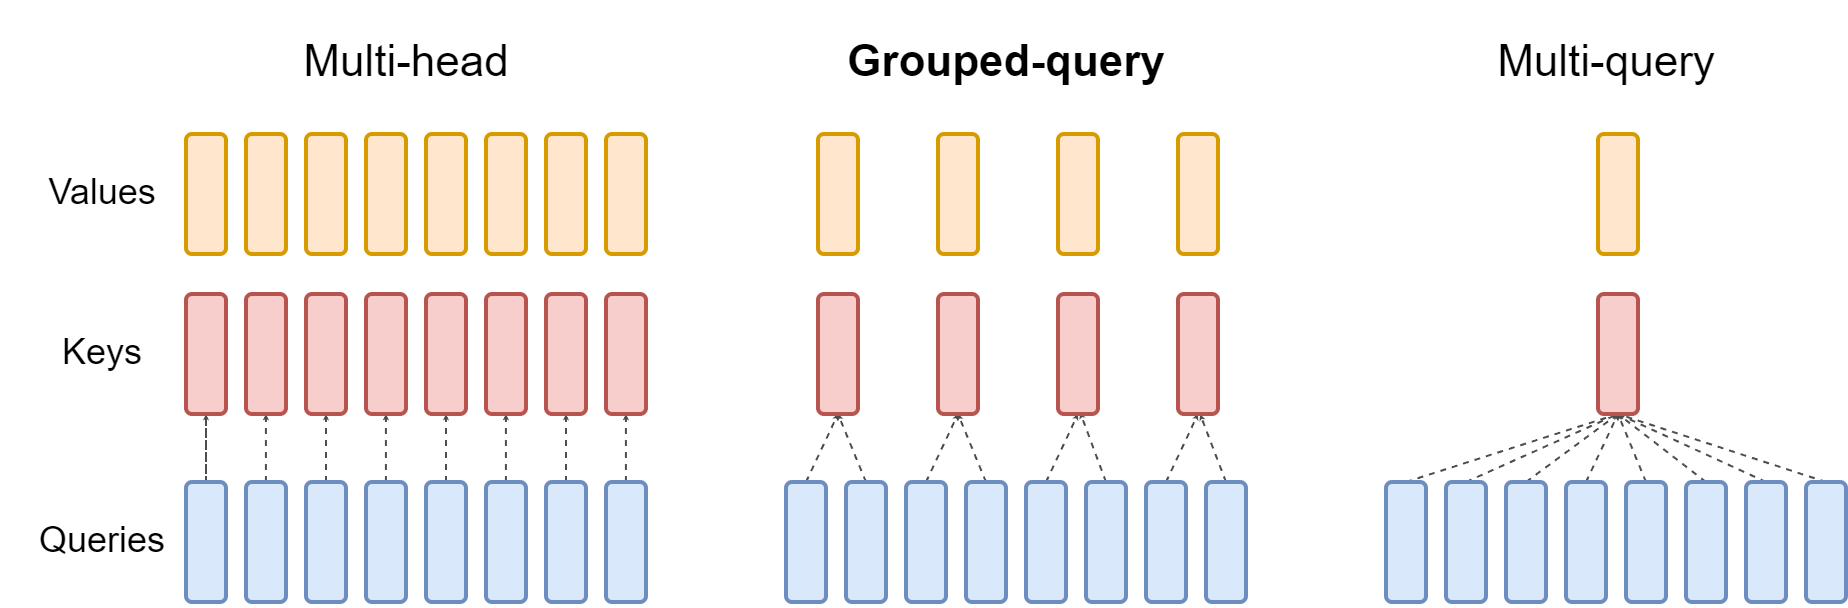
来源:Joshua Ainslie 等,GQA,Figure 2;中文为辅助标注;查看原图。原图采用 CC BY 4.0 许可。
- 蓝色 Q 数量不变:原图三个面板都画了 8 个 Query 头;共享的是红色 K 与黄色 V,不是把每个 Q 的输出合并为一个。
- 中间每两个 Q 共享一组 K/V:这是图中的 8 Q / 4 KV 教学配置。本文 Llama-3-8B 用的是 32 Q / 8 KV,即每四个 Q 共享,不能照抄原图头数。
- 缓存按实际 K/V 头数存:相同层数、长度、头维度和 dtype 下,图中三种缓存量之比为 8:4:1。注意力仍分别为各 Query 头计算,缓存缩小不等于全部注意力计算同比缩小。
4.3 按层数、头数和 token 数计算 KV 大小
一层的 K、V 各有逻辑形状 ,每个元素占 bytes。下面假设每层的缓存配置相同。
方括号表示多维数组的各轴长度: 是同时缓存的请求数, 是每个请求已处理的 token 数, 是每个 token 保存的 KV 头数,每个头有 个数。把各轴相乘得到一份 K 的元素数;再乘 2 是同时保存 K 和 V,乘 是每一层都有独立缓存。这样就能逐项数出缓存里的元素,而不必猜一个经验倍数。
对于变长请求,把 换成长度和:
是已写入缓存的 token 数,包括已处理的 prompt 和生成 token;刚从 logits 采样出、尚未送入下一次前向的 token,未必已写入缓存。
这个公式假设无共享、无裁剪、完整注意力,且每层 K/V 的头数、维度、dtype 相同。滑动窗口、混合层结构、压缩潜变量缓存、量化 scale 和特殊架构需要改按实际层/张量求和。Padding 到最大长度的实现也可能占用 ,而非有效长度和。
4.4 Llama-3-8B 的 KV 容量算例
单请求 BF16 KV 的每 token 大小为:
| 缓存长度 | 逻辑 KV | 占 BF16 权重的比例 | 加 BF16 权重的小计 |
|---|---|---|---|
| 512 | 64 MiB | 0.42% | 15.0200 GiB |
| 2,048 | 256 MiB | 1.67% | 15.2075 GiB |
| 4,096 | 512 MiB | 3.34% | 15.4575 GiB |
| 8,192 | 1 GiB | 6.69% | 15.9575 GiB |
| 32,768(外推) | 4 GiB,约 4.2950 GB | 26.74% | 18.9575 GiB |
| 131,072(外推) | 16 GiB,约 17.1799 GB | 106.97% | 30.9575 GiB |
后两行超过原版 8K 上下文限制。它们说明缓存随长度增长的规模,不构成扩展上下文后的质量保证。所有小计都还没有工作区与运行时开销。
并发也必须计入:8 个相互独立的等长 8K 请求,逻辑 BF16 KV 共 8 GiB;若由同一模型副本服务,只加一份权重。评估并发能力时,需要把所有活动请求的缓存一起计入。
5. 缓存只有这么多内容,为什么实际占用更大
5.1 预留空间和没填满的分页块也占显存
静态缓存可能直接为最大 batch 和最大长度分配;动态缓存和分页缓存则采用不同的增长与复用策略。
若分页块长为 个 token、每请求独立分配、没有前缀共享,已分给请求的 KV 存储近似为:
这里未计页表、元数据、量化 scale 和引擎预留空闲块。比如 ,两个请求长 17、33,逻辑上有 50 个 token,却需要 32+48=80 个 token 的块容量。
PagedAttention 让逻辑连续的序列可以映射到不连续物理块,减少连续大块预留的浪费;每个序列的最后一块仍可能没填满,不能说内部碎片被完全消除。在上述简单模型中,尾块浪费少于 个 token 槽位。原论文还利用块共享与 copy-on-write 管理候选序列。
引擎可能提前建立很大的 KV 池。空闲池块虽暂不含有效请求内容,仍已占显存,所以请求减少时进程显存未必同步下降。
5.2 什么情况下能共享前缀缓存
前缀共享要求 token 前缀、模型及影响 KV 的配置一致,并且引擎启用了这项功能;仅仅语义相近的 prompt 无法据此共享。相同前缀的块可以复用;不共享的后缀仍按请求分别保存。统计实际占用时,共享的物理块只计算一次。vLLM 的前缀缓存设计说明了按块识别与复用的做法。
5.3 多张卡怎样分缓存,什么时候还会复制
- Tensor Parallel(TP):常按 head 或矩阵维度切分。只有 KV 头能够按该实现均匀切分、没有复制时,才可按分片数缩小每卡 KV;TP 数大于 KV 头数时,有些引擎会复制 KV heads,有些组合不受支持
- Pipeline Parallel(PP):按层分配,每张卡只缓存自己负责的层。若切层不均或有额外边界/通信数据,各卡峰值会不同
- Data Parallel(DP):不同副本处理不同请求;通常每个副本都保留完整模型,不是把单请求模型状态均分
计算每卡占用时,应按该卡拥有的层、KV heads、请求和副本数求和。参数、KV、临时工作区与通信 buffer 的切分方式也不一定相同。
6. Prefill 与 decode 的临时工作区
6.1 Prefill 一次处理一段,decode 通常只处理一个 token
若本次新处理的 query 长度是 、可访问的总 key 长度是 :
| 当前层临时对象 | 典型形状 | 影响因素 |
|---|---|---|
| hidden states | 一次调度的 token 数 | |
| Q | query 头数 | |
| 新 K/V | 各 | KV 头数 |
| FFN gate/up 等 | 各约 | 融合、覆盖写和复用策略 |
| 显式 attention scores | 是否完整存成张量,以及采用的 dtype | |
| 完整 logits(若保留) | 是否只计算所需位置、是否分块 |
从零开始的整段 prefill 有 ;常规单步 decode 有 。Chunked prefill 让 变小,但历史 key 长度 仍会增长,完整请求的最终 KV 也不会凭空减少。Speculative decoding 一次可验证多个新位置,不总是 。
只知道这些形状还不能把它们全部相加当峰值:张量可能顺序创建、共用内存、融合计算、升为 FP32,或被引擎预分配。推理通常不需要为反向保留所有层的激活,因此也不应机械乘上层数 。
6.2 分数矩阵、FFN 与 logits 的容量算例
假设 、、,某个实现把完整 scores 存成 BF16 张量。 是每个分数元素的存储字节数,本例 BF16 取 2,则这个单层张量为:
若实际 scores/softmax 使用 FP32,则同样形状需要 128 GiB。causal mask 只遮住上三角,不代表一个普通稠密张量会自动只存一半。
同一 32K 外推下,一个 BF16 FFN 中间张量 为 0.875 GiB;有多少个同时存活由实现决定。8K prefill 若保留所有位置的 BF16 logits, bytes 约为 1.9570 GiB;若只需要末位置 logits,实现可能避免保留这份完整张量。
这些数字各自对应一个张量。只有知道哪些张量会同时存在,才能计算峰值,不能把它们直接全部相加。
6.3 FlashAttention 省下的是哪些中间结果
估算显存时,FlashAttention 减少的是上面显式保存 scores/softmax 的中间存储;权重、持久 KV 和其他算子的工作区仍需计入。不能因为启用它,就把整个推理过程的工作区记成零。
它如何不保留完整分数矩阵,却维持同一个归一化结果,见下一篇FlashAttention 的在线 softmax 合并、分块算例与因果掩码。这里只用这个结论决定是否把完整 scores 张量计入目标实现的显存占用;实际 kernel 和 decode 专用路径还须核对。
FlashAttention 的分块推导
- FlashAttention 的完整分块前向:从大矩阵到逐块计算。
- GPU 存储层级:区分 HBM、寄存器和 shared memory。
- 普通 attention 的矩阵计算:先看完整分数矩阵,再沿两块前向图理解累计。
- 在线 softmax 手算与递推:给分子、分母统一缩放基准。
- 因果掩码与 CPU 参考代码:处理位置偏移和全遮蔽行。
7. 权重、KV 与工作区的优化方法
7.1 权重量化
第 3.4 节只改变了权重编码的位宽。部署量化模型时,还要计入元数据、高精度层与解包/反量化工作区,并验证任务质量和实际速度。
权重量化并不自动改变 或激活 dtype。原始 BF16 checkpoint 也不会只靠填一个 quantization="awq" 参数就完成 AWQ 量化。量化方法与 checkpoint 必须匹配,详见量化进阶部分。
7.2 KV 头数、存储精度与分配策略
- GQA/MQA 减少 。Llama-3-8B 的 GQA 缓存是同头维度、同层数 MHA 假设的四分之一。它是模型架构选择,不能在部署时直接把头数改小而保持原模型行为
- KV 量化 减少 。若 BF16 的 2 bytes 变成 FP8 的 1 byte,32K 外推的 KV 编码数据由 4 GiB 变成 2 GiB;scale、后端支持和质量误差另计
- 分页与共享 减少空置空间和重复前缀,不改变每个独有 token 必须存的 K/V 元素数
FP8 KV 存储不等于需要或使用 FP8 矩阵乘;支持条件由设备、CUDA/ROCm、内核和版本共同决定,不能笼统写成「H100 以上才可用」。vLLM 0.9.1 的 KV 量化说明列出了 dtype 与 scale 的配置。
7.3 工作区与调度
高效 attention、chunked prefill、限制一次处理的 token 数、减少不需要的 logits,分别针对不同临时对象。改动后仍要复测吞吐、首 token 延迟和每 token 延迟;显存减少不一定同时提高所有性能指标。
8. 先估算显存,再上设备测试
8.1 单请求的权重与 KV 大小
BF16、已缓存 8,192 token 时:
这还不是实际分配池,更不是总峰值。假想 32K 时,类似小计为 18.9575 GiB,但原 checkpoint 的 8K 限制仍需遵守。
8.2 vLLM 0.9.1 配置示例
以下配置使用 vLLM 0.9.1 接口;运行需要已授权的模型访问、兼容的 GPU/CUDA 与安装环境。配置中的预算值仍需根据目标设备上的峰值测量调整。
from vllm import LLM, SamplingParams
llm = LLM( model="meta-llama/Meta-Llama-3-8B-Instruct", dtype="bfloat16", max_model_len=8192, gpu_memory_utilization=0.9, kv_cache_dtype="auto",)params = SamplingParams(max_tokens=32, temperature=0.0)outputs = llm.generate(["The main idea of a KV cache is"], params)print(outputs[0].outputs[0].text)max_model_len 约束 prompt 加输出可接受的总长度;gpu_memory_utilization 是引擎预算参数,不是「留 10% 就一定安全」的保证。KV 池还受权重、工作区、block 配置和引擎调度影响。vLLM 版本文档是调整参数的依据。
Transformers 也有多种缓存与 attention 实现,不能概括成「原生一定没有内存高效 attention」或给出无条件的引擎性能排名。应按目标版本支持的实现、服务需求和实测结果选择。
8.3 容量计算器与 OOM 排查
前面的公式用于计算张量大小。排查 OOM 时,可以先计算已知数据所需的最小空间,再根据报错阶段缩小范围。即使这一数值低于设备容量,运行时的额外开销仍可能导致 OOM。
权重与 KV 容量计算器
计算器的输入含义如下:params 使用实际参数量,weight_bytes 使用权重的常驻存储宽度;lengths 是每个活动请求已写入缓存的 token 数,容量规划时可填目标 prompt 加生成预算。kv_heads 使用 KV 头数,kv_bytes 单独读取缓存 dtype。权重量化不会自动量化 KV,函数也不会检查模型的上下文上限。
下面只算单设备、完整权重、无前缀共享的逻辑下界。输入长度是 token 数,不是字数;代码不会加载模型,也不计量化元数据或运行时开销。
from math import isfinite
def estimate_memory(lengths, *, params=8_030_261_248, layers=32, kv_heads=8, head_dim=128, weight_bytes=2, kv_bytes=2): """Return raw weights + logical KV, excluding all runtime overhead.""" lengths = tuple(lengths) counts = (params, layers, kv_heads, head_dim) if any(type(x) is not int or x <= 0 for x in counts): raise ValueError("model counts must be positive integers") if not lengths or any(type(t) is not int or t < 0 for t in lengths): raise ValueError("lengths must be nonnegative integer token counts") for width in (weight_bytes, kv_bytes): if isinstance(width, bool) or not isfinite(width) or width <= 0: raise ValueError("storage widths must be finite positive bytes") weights = params * weight_bytes kv = 2 * layers * kv_heads * head_dim * kv_bytes * sum(lengths) return { "weights_GiB": weights / 2**30, "logical_KV_GiB": kv / 2**30, "subtotal_GiB": (weights + kv) / 2**30, }
print(estimate_memory([8192]))# weights_GiB: 14.957527..., logical_KV_GiB: 1.0,# subtotal_GiB: 15.957527...; this is not the process peak.如果算出的单设备常驻下界已超过该设备可用容量,这个配置在不分片、不 offload(把数据移到 CPU 内存等位置)的前提下不可行。反过来,下界小于容量并不保证能运行,还需要按下文测试实际峰值。
按 OOM 发生阶段排查
OOM 出现在哪一步,比模型名称里的「几 B」更能缩小范围。这是检查顺序,不是仅凭症状就能确定的诊断。
| 出现时机或症状 | 优先检查的显存占用 | 先做什么 |
|---|---|---|
| 模型刚加载就失败 | 权重常驻量、加载期间临时副本、设备已有占用 | 核对实际参数量、加载 dtype、分片和空闲容量 |
| 短 prompt 能跑,长 prompt 失败 | Prefill 工作区、logits、缓存预分配 | 固定并发,逐步增加输入长度并记录峰值 |
| 生成一段后失败,或并发提高后失败 | 已缓存 token、请求副本、KV 池容量 | 固定输入,分别增加生成长度和活动请求数 |
| 反向或第一次 optimizer step 才失败 | 已保存激活、梯度、延迟创建的 optimizer state | 分开测前向、反向、首次更新 |
| 请求结束后进程占用仍高 | 可复用 KV 池、分配器缓存、仍被引用的张量 | 对照引擎池统计与 allocated/reserved,别直接认定泄漏 |
该用什么输入测试,要记录哪些结果
- 先找出报错阶段:是加载、prefill、decode、反向,还是第一次 optimizer step 时 OOM?每个阶段需要保存的数据不同
- 核对存储精度:权重、KV、梯度和 optimizer state 分别是什么 dtype?量化了权重不等于量化 KV
- 核对长度和并发:prompt 加生成预算是否超出模型限制?beam、并行采样和多个请求是否增加缓存副本?是否预分配最大长度?
- 核对实现:实际用了哪个 attention kernel?是否保存完整 logits?是否开启前缀缓存、chunked prefill、CUDA Graph?不要仅看配置名称
- 分清各个显存统计值:PyTorch 的 allocated 是活跃张量占用,reserved 是分配器管理的内存,后者已包含前者;不能把两者相加。进程总占用还可能有 PyTorch 之外的分配
- 按真实负载测峰值:覆盖短输入、接近上限的输入、长生成和目标最大并发;记录模型 revision、引擎/驱动版本、dtype、attention backend、并行方式、实际 token 数、峰值显存与输出质量。初始化/热身和稳态都要看,多进程引擎要看实际 worker;按测量方案同步异步 GPU 操作,再记录吞吐、首 token 延迟和生成延迟
推理时还要确认没有意外构建反向图:model.eval() 不会关闭梯度记录,应结合 torch.no_grad() 或 torch.inference_mode()。模式差异见PyTorch 文档。
empty_cache() 可以归还分配器中未使用的缓存块,但不会释放仍被张量引用的内存;它不能替代减少真正存活的数据。PyTorch 内存管理说明是排查 allocated/reserved 差异的入口。
每轮只改一个变量:固定输出和并发增加输入,观察 prefill;固定 prompt,分别增加输出预算和活动请求数,观察 decode 与缓存池。前面已经列出了各类优化减少哪些数据的占用,测完之后再对照第 7 节选择方案。
如果失败发生在训练阶段,先按训练状态与张量生命周期确认梯度、主权重和 optimizer state,不能用这里的推理小计乘一个固定倍数来代替训练显存计算。ZeRO处理模型状态分片,SFT 与 LoRA讨论微调配置;训练激活还要结合 micro-batch、序列长度与 checkpointing 单独测量。
容量计算器给出的是存储下界;部署时应以上述实际负载测试得到的峰值、吞吐和输出质量为准。
9. 小结
- 权重按实际参数量乘存储字节;Llama-3-8B 的 BF16 裸权重约 14.9575 GiB
- KV 按 KV 头数、缓存 token 数和缓存精度计数;GQA 的 query 头数不能直接代入 KV 公式
- 有效缓存内容、分给请求的块和整个缓存池各有多大,要分开计算;多卡还要看哪些数据被切分、哪些被复制
- KV Cache 复用每层历史 K/V;当前 Query 仍需读取并计算历史 attention
- FlashAttention 减少 attention 的中间存储,不会消除权重或持久 KV;其分块推导留到下一篇
- Prefill/decode 的工作区形状不同,先算权重和缓存,再测真实运行峰值
比较优化方法时,应说明它减少了哪些计算、存储或传输,并在目标 batch、序列长度和硬件上测量收益。
下一篇读大模型显存(五):FlashAttention 为什么能省显存:从完整 attention 分数矩阵出发,看分块计算如何在不保留大矩阵的情况下得到同一个结果。
参考资料
原论文与实现文档
- Vaswani et al., Attention Is All You Need
- Dao et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Milakov and Gimelshein, Online normalizer calculation for softmax
- Hugging Face Caching,v4.57.1
- Triton Fused Attention 教程
- NVIDIA Ampere Architecture In-Depth
- Agrawal et al., SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills
延伸阅读
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。