这是大模型显存系列的第一篇。想估算需要多少显存,先要弄清数据用什么精度保存、有多少份副本,以及哪些数据会同时留在显存里。本文先介绍这些基础,再计算一套 Adam 训练配置的状态大小。下一篇《大模型显存(二):ZeRO 如何分摊训练显存》会接着解释多张卡怎样共同承担这些训练状态。系列先讲训练和微调,再进入推理;如果已经遇到 OOM,也可以按需查看显存速查清单。
0. 模型为什么会显存不够
先用一个简单模型解释几个术语:**参数(权重)**是模型学到的数;张量是把数按一定形状排成的数组;激活是模型处理当前输入时算出的中间结果。例如只有 的小模型中, 是参数,输入 和结果 都会参与计算,但不是要训练的参数。大模型把同样的过程扩展为许多矩阵运算。
推理是使用已有参数回答问题;训练还要根据答案的误差调整参数。显存是 GPU 存这些数及临时结果的空间,OOM(Out of Memory)就是某次申请需要的空间超过可用容量。后文说的 dtype 是“一个数采用什么存储类型”,如 FP32、BF16;buffer 则是一块暂存数据的空间。
一个模型能否运行,首先取决于某个时刻需要同时保存的数据能否放进显存。GPU 显存可能采用 HBM 或 GDDR 等技术,所以 HBM 只是显存的一种;后文引用 FlashAttention 论文时,沿用论文的 HBM 层级名称。
显存够用,也不代表运行就一定快。模型装得下之后,速度仍可能受到计算、显存带宽、通信或调度的影响。本文先解决容量问题:每份数据是什么、占多少、什么时候释放。
1. bit、byte、GB 与 GiB
1 bit 只有 0、1 两种状态,8 bits = 1 byte。 个 bit 有 种编码:无符号整数范围是 到 ;补码有符号整数范围是 到 。
| 位宽 | 编码数 | 无符号整数范围 | 补码有符号整数范围 |
|---|---|---|---|
| 4 bit | 16 | 0 到 15 | -8 到 7 |
| 8 bit | 256 | 0 到 255 | -128 到 127 |
| 16 bit | 65,536 | 0 到 65,535 | -32,768 到 32,767 |
容量有两套常见单位:
| 十进制 | 字节数 | 二进制 | 字节数 |
|---|---|---|---|
| KB | KiB | ||
| MB | MiB | ||
| GB | GiB |
例如 ;它们表示同一份数据,不是少了一块显存。本文的十进制参数速算用 GB,按二进制张量大小计算时用 GiB,两者不混用。
后文统一记号: 表示参数个数, 表示存储字节数, 表示每个元素的字节数,不是 bit 数。为了区分对象,用 、、 分别表示权重、梯度和 KV 的存储宽度。
2. 浮点数的数值范围与精度
2.1 浮点数怎么表示
浮点数类似科学计数法:,一部分记录有效数字,一部分记录数量级。下面的公式说明每一部分二进制位怎样表示数值;第一次阅读可以先记住“范围决定能存多大,分辨率决定能分多细”,再直接看 2.2 节。一个普通的二进制浮点数可以理解为「符号 × 有效数字 × 2 的指数次幂」。对正规数,更具体地写成:
这里 是符号位, 是 位小数部分的整数编码, 是指数编码,bias 是指数偏移量。零、非正规数、无穷大和 NaN 有专门规则,不都服从这个式子。
指数位主要决定能覆盖的数量级;小数位主要决定同一数量级中相邻可表示数的间隔。把这两点分开,就能理解 BF16 为什么范围大,却不擅长保存细小更新。
2.2 FP32、FP16 与 BF16
| 格式 | 符号/指数/小数位 | 字节 | 最大有限值(约) | 1 附近向上的相邻间隔 |
|---|---|---|---|---|
| FP32 | 1 / 8 / 23 | 4 | ||
| FP16 | 1 / 5 / 10 | 2 | 65,504 | |
| BF16 | 1 / 8 / 7 | 2 |
BF16 的指数位数与 FP32 一样,动态范围接近,但两者的最大有限值并不完全相同。它的小数位比 FP16 更少,因此相同数量级下的分辨率更粗。BF16 原论文讨论了这种取舍。
两种常被混淆的误差:
- 舍入损失:BF16 在 1 附近的间隔是 。在舍入到最近值的条件下,把 存成 BF16 会得到 1;这里的 0.001 本身可以表示为非零近似值,只是加到 1 上太小
- 下溢到零:数本身太小。FP16 的最小正非正规数是 ,所以 舍入到 FP16 可变成 0;有些硬件路径还会把非正规数直接冲零
FP16 训练常用 loss scaling:loss 是衡量预测误差的标量,反向传播由它求出参数的梯度。把 loss 乘一个缩放因子,会把梯度也同比放大;在更新前再除回来,以减少小梯度的下溢风险。它不能修复所有舍入误差,也不能保证所有模型都适合 FP16。PyTorch AMP 文档说明了这一用途及其限制。
2.3 FP8 与整数低位宽
FP8 仍是浮点数,常见 E4M3 和 E5M2 分别分配 4/3、5/2 个指数/小数位。按 FP8 Formats for Deep Learning中的格式,E4M3 最大有限值为 448,E5M2 为 57,344。其他 FP8 变体可能不同,不能只写「FP8」就假设相同范围。
低精度张量通常还需要 scale(缩放系数):例如先把原值除以 scale,再用低精度存储,使用时乘回 scale,以映射到合适的范围;超出范围可能被裁剪,可表示区间内仍有舍入。存成 FP8 与硬件原生执行 FP8 矩阵乘不是一回事,内核、设备与训练配置都要匹配。
INT8 和 INT4 用整数编码,通常分别有 256 和 16 个量化级别。INT4 只有在打包存储时才相当于 0.5 字节/元素;用一个 byte 存一个 4-bit 值并不会自动得到这个压缩率。scale、可能的 zero-point、高精度层和对齐也要另算。量化基础会解释映射过程。
3. 参数量乘字节数,只算了一份权重
「参数个数 × 每个参数的存储字节数」只计算一份指定存储格式的权重。它既不包含另存的梯度和 optimizer state,也不说明计算过程中会生成多大的激活。
同一模型在下面三个地方采用的格式可能不同:checkpoint(保存到磁盘的模型文件)中的格式、模型加载后常驻的格式、算子执行时采用的计算 dtype。例如 autocast 选择部分算子的低精度计算,不等于永久多出一份低精度模型,详见第 5.2 节。
了解权重计算包含哪些数据后,可以接着看参数矩阵与位宽容量表:那里集中列出标称 7B 的换算、Llama-3-8B 的精确参数个数,以及分片、共享权重和量化元数据的影响。
4. 推理时要存什么,各自存多久
逐个生成 token(文本切分后的基本单位)时,注意力机制会用到前文的 Key 和 Value,简称 K、V。KV Cache 就是把这些历史结果存起来,避免每生成一个新 token 都重新计算全部前文。它随输入和生成长度变化;模型权重则在同一次推理中保持不变。下面的 Q 是 Query,FFN 是前馈网络,logits 是输出词表中各 token 尚未归一化的分数。这些中间张量和算子临时空间都要占显存。
| 对象 | 用途 | 通常保留多久 |
|---|---|---|
| 权重 | 每一步前向计算 | 模型加载期间保留 |
| KV Cache | 保存后续注意力要用的历史 K/V | 请求期间增长;结束后回收或保留为可复用前缀 |
| 激活与临时工作区 | Q/K/V 投影、FFN、attention、logits、采样等 | 随算子执行创建、复用或释放 |
| 运行时其他内存 | CUDA 上下文、图捕获、分配器预留、通信等 | 随框架及配置变化 |
这里先说明各类数据做什么、需要保留多久;KV 的头数、缓存形状和长度求和公式集中在推理显存篇。
为避免重复计数,把对象分成互不重叠的四类,则在时刻 的设备占用可记为:
其中 表示时间, 的意思是“从整次运行的所有时刻中找最大值”,这才是峰值。真正需要的是 。各项峰值不一定同时发生,不能把不同时间测到的峰值直接当成一次运行的精确总峰值。
请求结束后,引擎可能把不再使用的空间留在缓存池里,供下次请求复用。所以缓存中有多少有效内容,和引擎已经分配了多少显存,是两个不同的数。
5. 训练比推理多存哪些数据
预训练和 SFT(监督微调)都属于训练,都会通过 loss、反向传播和优化器更新参数。两者使用的数据和训练目标有所不同:常见语言模型预训练从大量文本中预测后续 token,SFT 则用示范数据教模型完成指定任务。全参数训练会更新全部参数;冻结部分参数或只训练 LoRA 等新增参数时,所需的梯度和优化器状态也会改变。
先顺着一次训练看这些额外数据从哪里来。模型用当前参数做前向,产生预测;损失函数 loss 给出预测与目标的差距;反向传播计算每个参数的梯度;优化器根据梯度决定下一次怎样修改参数。自动求导工具 autograd 会记录计算关系并保存反向需要的中间值,所以训练通常要比只做前向多存一些激活。
例如 ,输入 ,目标为 0,损失取 。当 时,、,梯度为 。这里 表示“其他条件不变时,略微改变 ,loss 会变化多快”;正梯度意味着沿减小 的方向走一个足够小的步子可降低当前损失。最简单的 SGD 更新是 , 是学习率;取 ,就得到 。
Adam 还会保留两份随训练更新的统计量: 记录近期梯度的带符号平均趋势, 记录近期梯度平方的平均量级。它们帮助优化器平滑方向,并按各参数的梯度尺度调整步长。每个参数各有自己的 和 ;一个含一百万个数的权重张量,对应的 、 也各含一百万个数。它们是跨训练步保留的 optimizer state(优化器状态),并非本轮算完就丢弃的临时激活。第 5.3 节会手算一次:怎样更新这两个统计量,再用它们修改权重。
5.1 用一套 Adam 配置算出每参数 16 字节
混合精度指在同一次训练中组合不同数值格式。这里用低精度执行部分计算、用高精度保留较细的更新。下面指定一个教学用配置:每个可训练参数保留 BF16 权重和 BF16 梯度,优化器另有 FP32 主权重与 FP32 Adam 状态,不分片(不把状态拆给多张卡)、不 offload(不把状态移到 CPU 内存或磁盘)。主权重是同一组参数的高精度版本:先更新它,再转成供计算使用的低精度副本;它不是另一套独立学习的模型。
| 对象 | 存储精度 | 字节/参数 | 用途 |
|---|---|---|---|
| 计算用权重 | BF16 | 2 | 前向和反向计算 |
| 梯度 | BF16 | 2 | 累积本轮导数,供更新使用 |
| 主权重(master copy) | FP32 | 4 | 接收较精细的参数更新 |
| Adam 一阶矩 | FP32 | 4 | 梯度的指数移动平均 |
| Adam 二阶矩 | FP32 | 4 | 梯度平方的指数移动平均 |
| 模型状态合计 | 16 | 不包括激活与工作区 |
因此这一配置的模型状态为:
所谓“一阶矩”在这里就是对梯度求平均,“二阶矩”是对梯度平方求平均。这里的 是未中心化二阶矩估计,不是方差;方差还涉及减去均值的平方。Adam 的定义可以用来核对状态含义。
只将这套配置的梯度改成 FP32、其他副本不变,就得到:
若额外保留 BF16 梯度暂存或 FP32 累积 buffer,还需再加,18 也不是适用于所有配置的常数。FP16 计算权重和梯度也各占 2 字节,但数值行为与 BF16 不同。
5.2 开了 autocast,不代表常驻两份权重
torch.autocast 按算子选择计算 dtype,并不定义完整的 optimizer 存储方案。常见 PyTorch AMP 写法保留 FP32 模型参数,部分运算临时使用低精度;梯度会累积到对应参数的梯度张量里。不能仅凭开启 BF16 autocast,就断言常驻一份 BF16 参数加一份 FP32 master copy。官方 AMP 示例从默认精度模型开始,正体现了这种区别。
例如,若实际持有的是 FP32 参数、FP32 梯度、FP32 Adam 两个状态,模型状态同样为 字节/参数,但组成与上一节不同。autocast 的转换缓存、临时张量和优化器实现所需的额外空间仍另计。
因此看配置时至少问四件事:参数以什么 dtype 常驻?梯度如何保存和累积?有没有独立主权重?optimizer state 的 dtype 是什么?仅凭“混合精度”这一名称无法确定这些细节。
5.3 为什么常保留 FP32 状态
下面具体计算 Adam 保存的两个统计量。令 表示第几次优化器更新, 是这次更新所用的梯度;初始化 。Adam 的逐元素计算为:
控制保留多少历史。以 为例,每一步的 是“上一步平均值的 90% 加新梯度的 10%”;再过一步,旧梯度的影响又乘一次 0.9,所以叫指数移动平均。这里只保存移动平均值,不保存每一步的历史梯度。 同理,只是先将梯度平方,因此正、负梯度都会对它贡献非负的大小信息。
由于 ,前几步的移动平均会受到零初值的影响。例如第一步 ,梯度前的系数只有 0.1;一般地,前 步梯度的系数之和为 。Adam 用下面的偏差修正补偿这种初始化效应,再更新模型参数:
这里 是更新前的参数, 是学习率;小正数 避免分母为零,并影响很小梯度下的数值行为。分子保留方向,分母按该参数近期梯度的量级缩放步长。公式是普通 Adam、未加 weight decay 的情形;真实训练中的 loss 不一定每一步都降低。AdamW 额外的权重衰减不改变这里 、 的基本含义。
接着算上面的单参数例子。 取 、第一步梯度 、、、、:
- ;。
- ;。
- 。这与前面 SGD 的 0.96 不同,因为更新规则不同。
- 下一步即使换了一批数据、得到 ,仍接着上一轮的统计量计算:,。然后用 的修正因子更新权重,不能把第一步的 0.1、0.001 继续当分母。
因此,梯度可以在完成一次更新后清理,而 、 要留到下一次。以本篇的存储配置为例,上述 更新作用于 FP32 主权重,再转换为 BF16 计算副本;转换只改变表示精度,不增加另一组训练目标。Adam 原论文与 PyTorch Adam 算法给出了这些更新定义。
长时间反复加上很小的更新量,会遇到前面介绍的舍入问题;FP16 还可能遇到范围不足。FP32 状态和主权重能减少这些风险,但不代表完全没有数值误差。8-bit optimizer、不同状态 dtype、随机舍入或不保留主权重的方案也存在,必须按具体实现与收敛结果判断。混合精度训练论文给出了保留高精度主权重的经典动机。
5.4 一轮训练中,数据何时创建、何时释放
一次普通训练迭代大致是:
- 前向:创建中间张量;autograd 保存反向需要的部分激活
- 反向:计算并累积梯度;不再需要的已保存激活可陆续释放
- 优化器更新:读取梯度与状态,更新权重;部分 optimizer state 到第一次更新才初始化,因此第一步可能突然占用更多显存
- 清理梯度:清零或解除梯度张量引用;缓存分配器可能仍保留这块物理内存以便复用
反向为什么还要读取前向的中间值
把模型稍微加长:输入 先经过 ,再经过 ,损失为 。这里 是两个可训练参数, 是中间激活, 是输出,目标取 0。取 ,前向得到 。反向按链式法则从最后往前算:
算 的梯度时,还需要前向算出的 ;算更早的 时,还要把梯度经过第二层传回来。自动求导会按算子的求导规则保留需要的值,并不是把每一个临时结果都完整复制一份。保存引用也可能延长已有存储的寿命,而不产生额外副本。如果不保留某些中间值,就必须在反向需要时重算它们,这正是激活检查点的出发点。PyTorch Saved tensors解释了按需保存及共享存储的行为。
同理,若固定 、只训练 ,可以不保存 的参数梯度,但仍要计算 ,把误差传给 。因此“冻结某层权重”和“整个前向都不需要反向记录”是两回事。这也解释了 LoRA 为什么仍有激活占用;具体保存哪些张量由求导需求与实现决定。若某段既无可训练参数,也不需要向更早的可训练部分传梯度,则可能不必记录这一段,参见 PyTorch requires_grad 规则。
同一个模型,为什么序列更长会占更多训练显存
一份形状为 的 BF16 激活,包含每批 条序列、每条 个位置、每个位置 个数。取 ,每个 BF16 元素占 2 字节,它占 字节,即 32 MiB。若其他条件不变, 或 翻倍,这一张量也翻倍;模型参数量则没有改变。
这只是一份张量,不是“一层只有 32 MiB”。一层可能还要保留投影、非线性输入等多份结果;普通 attention 的某些中间矩阵还会随 增长。能否逐层相加,要看哪些张量同时存活、是否共享存储,以及是否用了融合或重算。因此参数状态估算之后,还需要用实际小批次和序列长度测激活峰值。
再看权重更新与张量生命周期
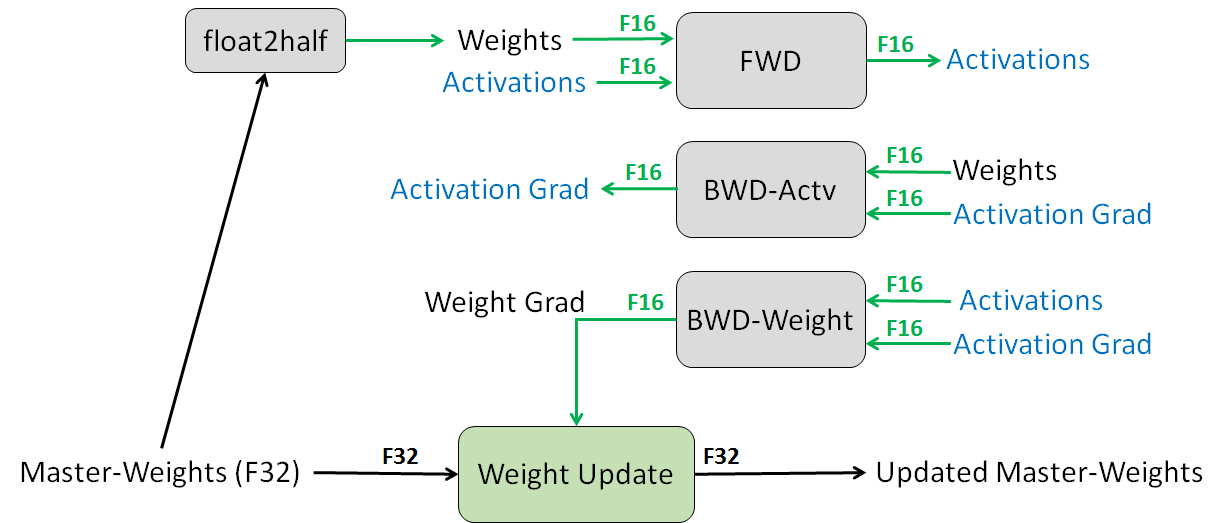
可以沿着混合精度训练论文的原图,追踪“计算用权重”和“更新用权重”为什么同时存在。图中的 F16、F32 分别表示 FP16、FP32;FWD 是前向,BWD 是反向,Grad 是梯度,Master-Weights 是高精度主权重。
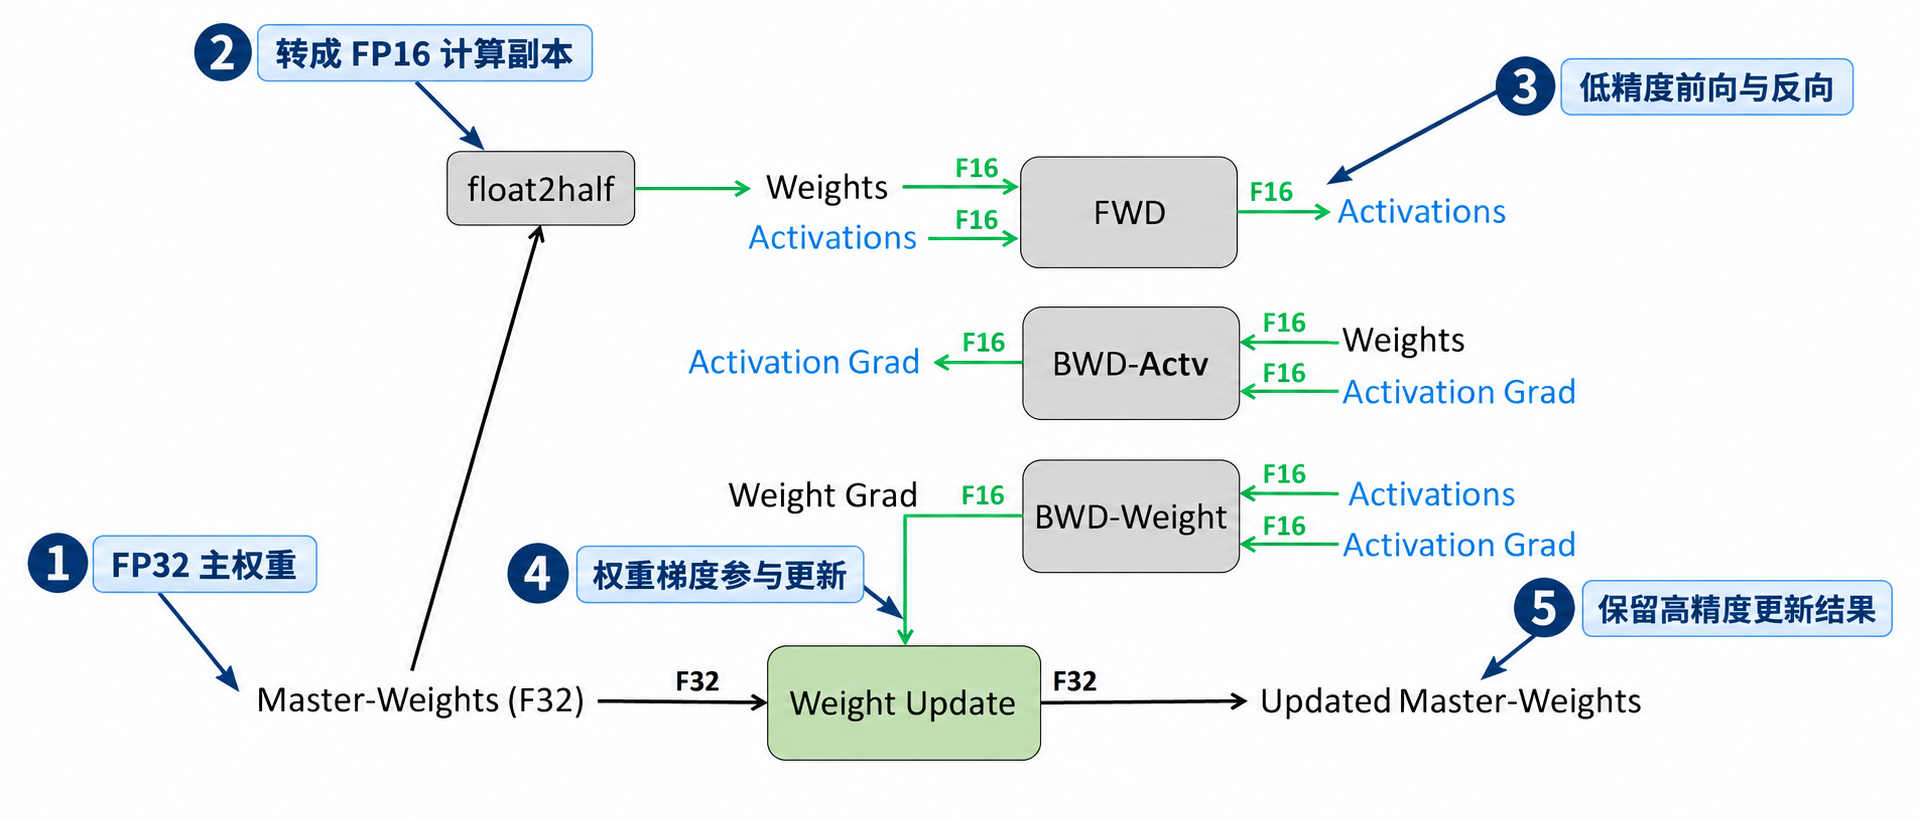
原图:Paulius Micikevicius 等,Mixed Precision Training,Figure 1;中文编号与引线为辅助标注;图片版权归原作者。查看未加中文标注的原图。
- ① FP32 主权重: 左下黑色路径保存用于更新的高精度权重,并送入 Weight Update。保留这份权重能减少小幅更新在低精度舍入时丢失的问题。
- ② 生成计算副本: 向上的黑箭头把主权重送到 float2half,转换成 FP16,绿色箭头再把它送往计算。转换副本不意味着删除原来的 FP32 主权重。
- ③ 低精度前向与反向: FWD 是前向;BWD-Actv 和 BWD-Weight 分别计算激活梯度、权重梯度,绿色 F16 标出图中的低精度输入输出。该图表达论文中的数据路径,不表示所有实际算子的内部累加都必须用 FP16。
- ④ 权重梯度参与更新: BWD-Weight 输出的 Weight Grad 沿绿色折线进入更新框,和黑色路径送来的主权重一起参与更新。激活梯度用于继续反向传播,不等同于要更新的权重本身。
- ⑤ 更新结果保持高精度: 右下输出新的 FP32 主权重,下轮再从它产生计算副本。图中没有画完优化器状态,不能只数这些框就得出训练峰值显存。
这张图讲的是论文中的 FP16 流程,前面 16 字节表格用的是 BF16 教学配置,不能直接把 F16 当成 BF16。图里也没有画 Adam 的 、激活释放时机或全部临时空间,因此它解释的是权重更新路径,不是训练峰值显存的完整清单;autocast 的具体存储仍按第 5.2 节区分。
Gradient accumulation(梯度累积)把多个 micro-batch(每次前向/反向的小批次)的梯度相加,累计到约定次数后才执行一次 optimizer step;要模拟大批次的平均损失,还需按样本数或有效 token 数正确归一化。不必让它们的完整计算图同时留在显存。若每次都正常反向且不保留图,激活峰值主要随单个 micro-batch 变化,梯度则保留到这些 micro-batch 全部处理完。梯度怎样累加、什么时候更新,以及 token 数不同时怎样归一化,见微调篇的梯度累积手算。Activation checkpointing(激活重计算)则通过反向时重算一部分激活来换显存。
因此,训练总占用还要计入激活、工作区和其他内存:
其中 saved-act 是留给反向的激活,workspace 是未包含在其中的临时空间。通信 bucket、优化器临时 buffer、分片 gather 峰值等都不能漏掉。常规 teacher-forcing(把真实前文喂给模型、并行预测后续 token)的全序列训练通常不使用生成用的持久 KV Cache;估算时不需要额外加上生成用的 KV Cache。
再把“何时保留、何时释放”放到真实时间线上看。下面是 PyTorch 官方教程中 ResNet50 训练的分配快照,用来认识生命周期;它不是本篇 7B 模型的显存测量。
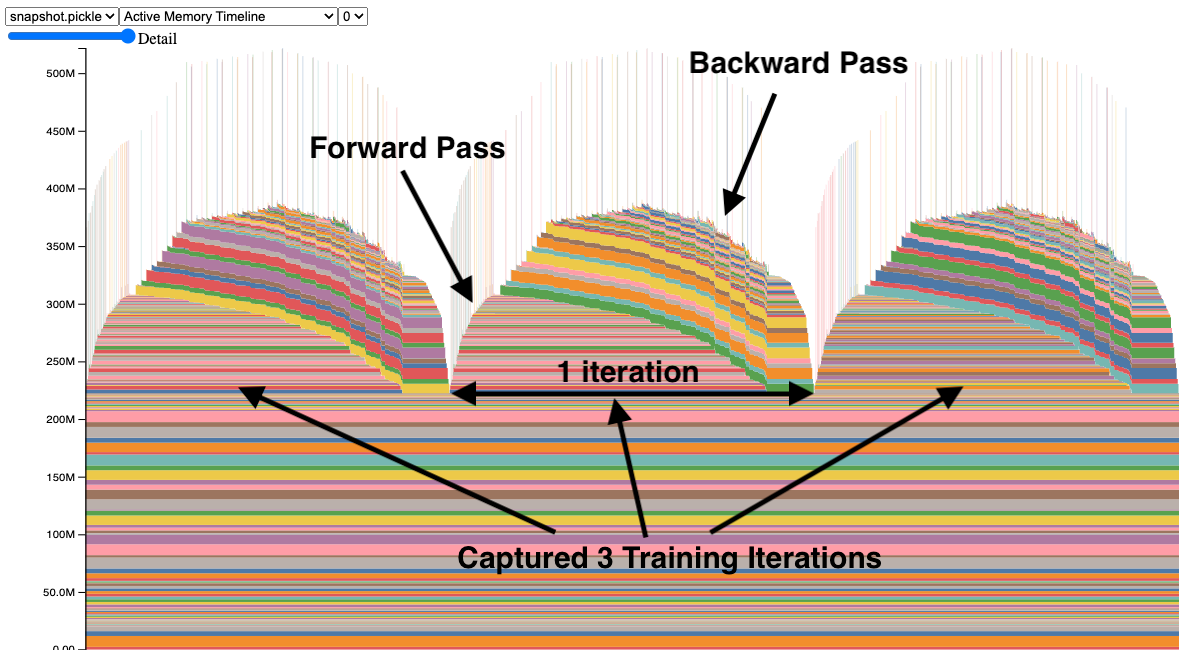
原图未改动:Aaron Shi、Zachary DeVito,Understanding GPU Memory 1;原始图片。版权归原作者及 PyTorch/相关权利人;网页未单独标明图片许可。
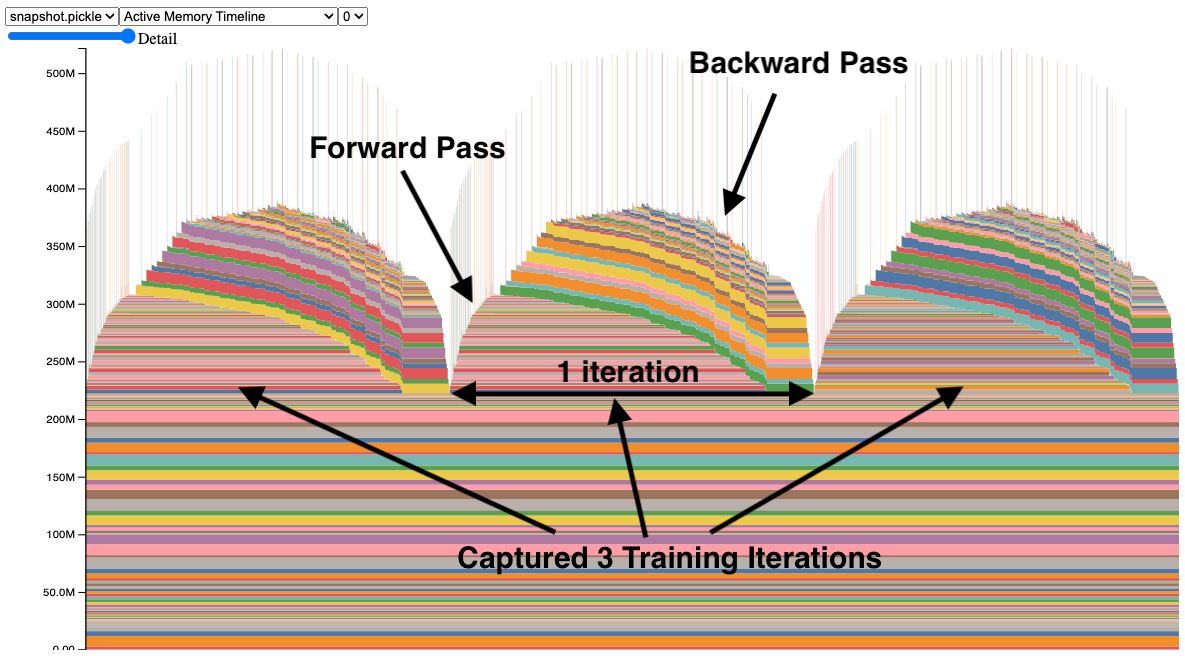
- 横向看时间,纵向看同时存在的分配量:三组起伏对应三轮迭代,不能把三轮峰值相加。
- 前向升高、反向降低:已保存的中间张量要等到反向使用后才能释放。底部贯穿多轮的条带表示长期存在的分配,但不能仅凭颜色就判断它一定是权重或 Adam 状态;这张快照每个分配单独着色。
- 细尖峰也是占用:原教程指出这些尖峰包括卷积算子的临时 buffer。它们说明只数长期张量会漏掉瞬时工作区;具体数值不能直接迁移到 Transformer。
5.5 7B 模型的推理权重与训练状态大小
先用 100 万个可训练参数核对:BF16 权重 MB,BF16 梯度也是 2 MB;主权重、、 分别是 MB。合计 MB。把参数量换成恰好 (7B 中 B 是 billion,十亿),采用相同的存储配置就得到 字节,即 112 GB。模型名称里的“7B”通常是近似值,估算显存时应使用实际参数量。
| 场景 | 明确假设 | 小计 |
|---|---|---|
| BF16 推理权重 | 一份完整 BF16 参数 | 14 GB,约 13.0385 GiB |
| 16 字节训练模型状态 | 第 5.1 节的五项,不分片 | 112 GB,约 104.3081 GiB |
| 18 字节训练模型状态 | 只将该配置梯度换成 FP32 | 126 GB,约 117.3466 GiB |
表中只列权重或模型状态,没有包含运行时的显存峰值。“112/14 = 8”比较的是指定配置的训练状态与推理裸权重,训练总显存与推理总显存未必相差 8 倍。冻结参数、LoRA、ZeRO、offload 和优化器选择都会改变需要保存的数据。ZeRO 论文中的模型状态分析也必须连同其精度假设一起使用。
6. 下一步:让多张卡分摊训练状态
现在已经知道权重、梯度、优化器状态和激活分别是什么,也能按精度计算每份数据的大小。下一篇《大模型显存(二):ZeRO 如何分摊训练显存》会从一个实际问题出发:既然训练状态这么大,为什么多加几张卡,单卡还是可能装不下?我们会看哪些数据重复保存、怎样分片,以及分片要付出什么通信代价。之后再把这些认识用到微调操作,最后讨论推理。
想进一步了解低位宽怎样表示原来的数,可选读量化:从基础到 GPTQ/AWQ;想了解权重衰减,可选读Adam/AdamW 与 Weight Decay。它们都不是继续阅读显存子系列的必修前置,更多主题见知识地图。
7. 小结
- 字节数、计算精度与存储精度要分别写清,GB 和 GiB 要统一换算
- 权重、梯度、optimizer state、训练激活、推理 KV 的用途不同,需要保留的时间也不同
- 每参数 16 字节对应特定存储配置;autocast 本身不决定常驻的参数副本
- 先算权重和状态占多少,再用实际输入和并发量测试运行峰值
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。