0. 成功了几次,成功率又是多少#
抛一枚硬币,如果已经知道正面朝上的概率,可以用二项分布算出:抛 10 次,恰好出现 3 次正面的概率是多少。反过来,如果只知道抛了多少次、出现了多少次正面,又该怎样估计正面朝上的概率?贝叶斯方法可以用 Beta 分布描述这个未知概率。如果结果超过两类,则可以用多项分布描述各类出现的次数,用 Dirichlet 分布描述各类概率。
本文从 Gamma 函数讲起,推导这些分布的密度和后验更新公式,再说明 Gamma、Beta 与 Dirichlet 之间的关系。Gamma 函数用于计算这些密度中的归一化常数。
阅读前需要熟悉指数、阶乘和条件概率,并知道积分可以表示面积。第 1 节的递推证明用到分部积分,首次阅读可先跳过证明,记住 Γ(n)=(n−1)!(n 为正整数)即可。
对有密度的连续分布,密度曲线下方、某个区间内的面积,就是落入这个区间的概率;单点的密度值本身不是概率。“归一化”就是让整个取值范围内的积分等于 1。理解这一点后,就可以从 Gamma 函数出发,构造下面几种概率密度。
1. Gamma 函数#
这里 t 是积分变量,α>0 是函数的输入:
Γ(α)=∫0∞tα−1e−tdt.它不是概率分布,而是一个返回正数的函数。对 Γ(α+1) 分部积分,取 u=tα、dv=e−tdt;边界项为 0,于是得到 Γ(α+1)=αΓ(α)。又因为 Γ(1)=∫0∞e−tdt=1,对正整数 n 就有 Γ(n)=(n−1)!。例如 Γ(4)=3!=6。
2. Gamma 分布#
把 Gamma 函数等式两边同时除以 Γ(α),得到归一化等式:
1=∫0∞Γ(α)tα−1e−tdt.把被积函数作为概率密度,就得到速率为 1 的 Gamma 分布:
fT(t)=Γ(α)tα−1e−t,t>0,α>0.要调整这个分布的取值尺度,可以作变量替换 t=βx,其中 β>0。积分变量也随之变化,因此需要同时代入 dt=βdx:
1=∫0∞Γ(α)(βx)α−1e−βxβdx,fX(x)=Γ(α)βαxα−1e−βx,x>0.额外的 β 来自积分宽度的变化,这就是系数为什么是 βα,而不是 βα−1。有了这个系数,变换后的密度在整个取值范围上的积分仍然是 1。
其中,α 称为形状参数(shape parameter),主要决定分布曲线的形状;β 称为速率参数(rate parameter),也叫逆尺度参数(inverse scale parameter),其倒数 β1 是尺度参数(scale parameter),控制横轴尺度。形状参数固定时,速率越大,取值越集中在较小的数附近;均值为 α/β,方差为 α/β2。SciPy 的 Gamma 参数约定 使用 scale=1/beta。
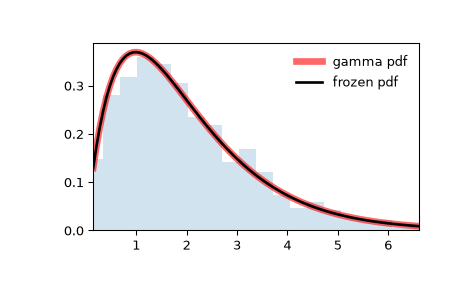
先看左侧峰顶,再沿曲线向右看长尾;柱子高低与曲线的贴合程度反映这一次抽样的波动,单根柱子不需要精确落在理论线上。
图中横轴是取值,纵轴是密度;这里形状参数为 α=1.99,速率为 β=1。红线和黑线是同一个密度,只是 SciPy 的两种调用写法;浅蓝直方图来自 1000 个随机样本。大多数取值落在左侧,右侧拖着长尾。直方图会随抽样波动,理论曲线不会。原图:SciPy Gamma 示例,SciPy Developers,BSD 许可,未改动。
3. 二项分布#
二项分布描述 n 次独立试验中的成功次数。每次试验只有成功和失败两种结果,成功概率均为 p。
令 K 是成功次数,则 P(K=k∣p)=(kn)pk(1−p)n−k,k=0,…,n。其中 (kn)=n!/[k!(n−k)!] 计算成功位置的选择数。例如三次试验恰好成功两次,有“成功成功失败”等三种顺序,每种概率都是 p2(1−p),所以总概率是 3p2(1−p)。
这个公式只在整数 k=0,…,n 上取非零值,其他取值的概率为 0。
NOTE固定参数的二项模型中,p 不必是随机变量。若采用贝叶斯方法描述对未知 p 的不确定性,可以为它指定先验分布,也就是看数据前对未知参数的分布;后面的 Beta 分布就是一种选择。
4. 用小球位置理解二项分布#
假设所有球的位置都独立地均匀分布在 [0,1],重合的概率为 0。先向长度为 1 的桌子上扔一个红球,把它的位置记为 x,也就是上面的 p。再扔一个白球,它落在红球左边的概率就是 x(或 p)。如果独立地扔 n 个白球,其中有 k 个落在红球左边,那么给定 x(或 p)时,次数 K 的条件分布为:
P(K=k∣p)=(kn)pk(1−p)n−k,k=0,…,n.固定红球位置后,左侧白球的数量服从二项分布。现在红球位置也是随机的,相当于给 p 指定了 U(0,1) 先验。想求不限定红球位置时的概率,就要把各个位置下的结果按密度加权积分:
P(K=k)=∫01P(K=k∣p)p 的密度1dp.这里可以直接积分是因为密度为 1,换一个先验就不能省略权重。
这个积分也可以通过小球的排序求出。P(K=k) 表示随机放置 n 个白球和 1 个红球后,红球左边恰好有 k 个白球的概率。这里红球的位置未知。
假设 k=1,相当于把 n+1 个球中的第 2 个涂成红色,左边就有 1 个白球:P=n+11
假设 k=2,就把第 3 个球涂成红色,左边有 2 个白球:P=n+11
…
所有排序位置等可能,所以对每个 k=0,…,n,都有:
P(K=k)=(kn)∫01pk(1−p)n−kdp=n+11.
5. Beta 函数#
前面红球的 n+1 个排序位置等可能,因此 P(K=k)=1/(n+1)。除以组合数得到 ∫01pk(1−p)n−kdp=k!(n−k)!/(n+1)!。
在上式中,令 k=α−1、n−k=β−1,则 n=α+β−2。把积分变量换为 t,在正整数参数下得到:
∫01tα−1(1−t)β−1dt=(α+β−1)!(α−1)!(β−1)!.前面用小球计数,只能推导出参数为正整数的情况。对任意实数 α,β>0,Beta 函数定义及其与 Gamma 的关系为:
B(α,β)=∫01tα−1(1−t)β−1dt=Γ(α+β)Γ(α)Γ(β).任意正实数参数下的恒等式见 NIST DLMF 5.12.1;前面的小球例子没有证明这个更一般的结论。本节的 β 表示第二个形状参数,与 Gamma 分布中的速率参数含义不同。
6. 用 Beta 分布更新未知成功率#
密度为 f(p)=pα−1(1−p)β−1/B(α,β),0<p<1。分母恰好是分子的积分,所以起归一化作用。Beta(1,1) 的密度恒为 1,是均匀先验;Beta(α,β) 的均值为 α/(α+β)。
NOTE在贝叶斯推断中,Beta 分布是 Bernoulli、二项、负二项和几何分布的共轭先验;这些分布都涉及成功与失败的试验。conjugate prior 这篇回答解释了共轭先验的含义。
先验描述的是看数据之前,参数可能取哪些值。似然则是在数据已经固定的情况下,比较哪个参数值更容易产生这份数据。根据数据更新后得到的参数分布叫后验。贝叶斯公式告诉我们:把先验乘以似然,再归一化,就得到后验。
Bernoulli 分布就是只试验一次的二项分布,结果为成功 1 或失败 0。“共轭”说的是先验乘上似然后,后验仍属于同一个分布族。
-
[1] Binomial 分布(二项分布)描述给定成功概率 p 和试验次数 n 时,成功 k 次的概率分布。
-
[2] Beta 分布描述未知成功概率 p 的不确定性。α,β 是分布的形状参数,不直接等于观察到的成功和失败次数。如果先验为 Beta(α0,β0),观察到 k 次成功、n−k 次失败后,后验为 Beta(α0+k,β0+n−k);这就是 Beta 先验与二项分布似然的共轭关系。
为什么参数可以直接相加?贝叶斯公式中,与 p 无关的系数都并入归一化常数:
f(p∣k,n)∝先验pα0−1(1−p)β0−1似然pk(1−p)n−k=pα0+k−1(1−p)β0+n−k−1.符号 ∝ 表示“两边只差一个与 p 无关的正系数”。最后一式正是 Beta 密度的形状。例如先验 Beta(1,1),三次试验有两次成功,后验为 Beta(3,2),后验均值为 3/5,而非样本频率 2/3;差别来自先验。
这个均值也可以看成两部分的加权平均:先验均值是 1/2,三次观察的成功率是 2/3。先验参数之和为 2,观察次数为 3,所以后验均值为 (2×21+3×32)/(2+3)=3/5。这里的 2 只是这组 Beta 参数在均值计算中的权重,不是说我们真的做过两次试验。后验分布还保留了对 p 的不确定性;只报告 0.6 这个均值,会丢掉分布有多集中的信息。
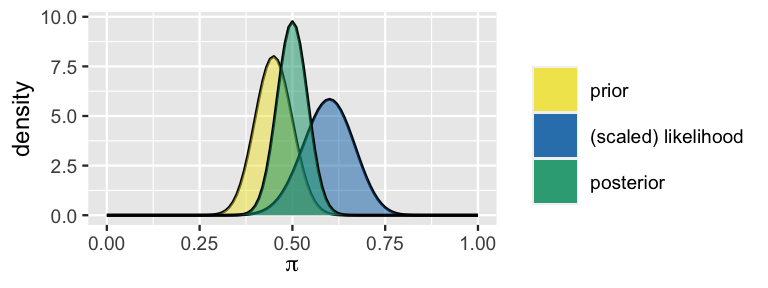
上图换用教材中的另一组数,让“更新”变得可见:黄色先验是 Beta(45,55),调查数据为 50 次中成功 30 次,绿色后验就是 Beta(75,75)。横轴 π 是未知成功率,纵轴是密度;蓝色是为了比较形状而缩放到积分为 1 的似然。绿色曲线把先验偏好的约 0.45 和数据偏好的 0.6 结合起来,并比先验更集中。它不是把黄、蓝两条曲线逐点取平均,而是先相乘、再归一化。
原图未改动:《Bayes Rules!》第 3 章,Alicia A. Johnson、Miles Q. Ott、Mine Dogucu,CC BY-NC-SA 4.0。原图链接。
7. 多项分布#
这里有 K 个互斥且穷尽的类别,概率向量 p=(p1,…,pK) 满足 ∑ipi=1。独立试验 n 次,各类别次数为 x1,…,xK,满足 ∑ixi=n。多项分布给出这些次数的联合概率;Dirichlet 则可以描述未知 p 的不确定性。
NOTE[2] Multinomial Distribution 即多项分布,可以理解为多维的“二项分布”。
各类别计数的联合概率为:
P(X1=x1,…,XK=xK∣p)=∏ixi!n!i∏pixi=∏iΓ(xi+1)Γ(n+1)i∏pixi.这里 ∏ 表示把各类别对应的项相乘。第二个等号只用了 Γ(r+1)=r!;下一节会解释阶乘系数为什么出现。
8. 多项分布为什么要乘阶乘系数#
沿用前面的小球例子,可以这样理解多项分布:
把 n 次试验想成 n 个有编号的小球,每个球独立地以概率 pi 进入第 i 个箱子。这里有 K 个箱子,不是 n 个箱子:
P(X1=x1,…,XK=xK∣p)=x1!⋯xK!n!i=1∏Kpixi.符号 ∏ 表示把各类别对应项相乘,例如 ∏i=1Kpixi=p1x1⋯pKxK。
固定一种类别序列,它的概率是 ∏ipixi;相同计数对应 n!/(x1!⋯xK!) 种序列,所以乘上这个系数。例如三次试验的计数为 (2,1,0),类别概率为 (0.5,0.3,0.2),可能的序列为 AAB、ABA、BAA,总概率是 3×0.52×0.3=0.225。用隔板可以表示各组计数,但随机放隔板本身并不自动等价于独立投球的多项模型。
9. 用 Dirichlet 分布更新多个类别的概率#
这里随机对象是概率向量 p,而不是前面观察到的计数 xi。令参数向量 α=(α1,…,αK),每个 αi>0:
f(p)=B(α)1i=1∏Kpiαi−1,B(α)=Γ(∑iαi)∏iΓ(αi).它只在 pi≥0、∑ipi=1 的概率单纯形上有概率质量;密度公式在内部 pi>0 使用。单纯形就是“所有合法概率向量的集合”:例如三分类中,知道前两个概率,第三个就是 1−p1−p2。因此它只有 K−1 个自由坐标,归一化积分也在这些坐标上进行。SciPy 定义
正文用 p 表示概率向量,用 xi 表示各类别计数,以免把两个随机对象混淆。
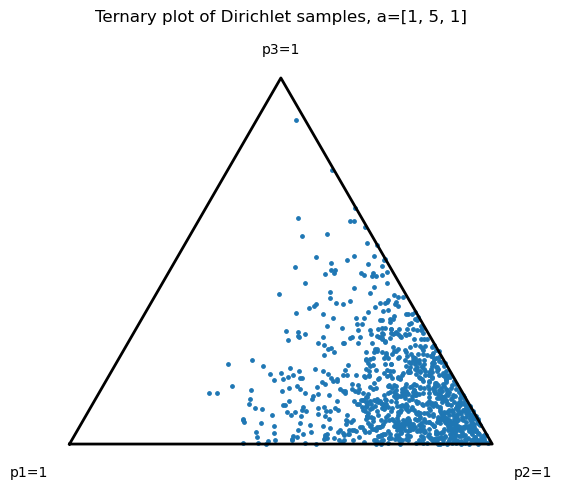
先找三个角上的 p1=1、p2=1、p3=1,再看蓝点往哪一角聚集。这里右下角最密,表示第二个概率往往较大;三角形内部的位置同时决定三个概率,不能把横纵位置当成两个互不约束的参数。
每个蓝点代表一整组 (p1,p2,p3),三个概率加起来为 1。三个顶点分别表示某一类概率为 1;靠近右下角的点表示 p2 较大。这张图使用 α=(1,5,1),所以样本更多地靠近右下角,而不是均匀铺满三角形。它画的是未知概率向量的样本,不是三类事件各发生了几次。原图:UC Berkeley Stat 238,Lab 5,CC BY 4.0,未改动。
这里的 B(α) 是多元 Beta 归一化函数,不是前面的二参数 Beta 分布。计算方法是把各个 Γ(αi) 的乘积除以 Γ(∑iαi)。
NOTE多项分布给定 K 个互斥类别的概率向量 p,描述各类别计数的分布;Dirichlet 分布描述未知概率向量 p 的不确定性。若先验为 Dirichlet(α1,…,αK),观测到各类别计数 m1,…,mK 后,后验为 Dirichlet(α1+m1,…,αK+mK)。形状参数 αi 不直接等于观测计数。这与 Beta–二项分布的共轭关系类似。
以一次试验只产生一个类别(例如掷骰子)的场景为例,令 X 为各类别的出现次数。独立老虎机各自的成功率不要求总和为 1,不能直接当作同一个多项分布的类别概率。
各类别的概率组成向量 p,这些概率相加为 1。
用分布记号写,就是 X∣p∼Multinomial(n,p)。
可以为概率向量 p 选择 Dirichlet 先验。
下面用掷骰子的例子说明,观察类别计数后怎样更新概率向量。
这里考虑一个可能不均匀的骰子,不知道每个面朝上的概率。将各面出现次数记为向量 m=(m1,…,mK),总次数为 n=∑imi。给定概率向量 p,这些计数出现的概率(似然)是:
P(X=m∣p)=∏imi!n!i∏pimi.把它看作似然时,已经观察到的 m 保持不变。我们改变 p,看哪些类别概率更容易产生这份计数。
观察到试验结果后,可以用贝叶斯公式(Bayes rule)求未知参数 p 的后验密度:
f(p∣X=m)=P(X=m)P(X=m∣p)f(p).分母 P(X=m) 表示在给定先验下,观察到计数向量 m 的概率:把每一种合法概率向量 p 下的似然,按先验密度加权,再积分。
P(X=m)=∫SP(X=m∣p)f(p)dp=∏imi!n!B(α)B(α+m).S 是前面介绍的概率单纯形,积分使用它的 K−1 个自由坐标;α+m 表示各坐标分别相加。第二个等号的计算方法是:先合并幂次,剩下的积分恰好是参数为 α+m 的 Dirichlet 密度所需的归一化常数。它不包含待推断的 p,因此是后验归一化所需的常数。
分子中的先验是前面的 Dirichlet 密度。将似然、先验和刚算出的分母代入贝叶斯公式,阶乘系数与 B(α) 抵消,得到:
f(p∣X=m)=P(X=m)P(X=m∣p)f(p)=B(α+m)1i∏piαi+mi−1.推导的关键是指数相加:f(p∣m)∝∏ipiαi−1∏ipimi=∏ipiαi+mi−1。分母只依赖已经观察到的计数 m,不依赖待推断的 p,因此可以并入常数 c。这里 c=1/B(α+m) 起归一化作用,使后验密度的积分为 1。
由此得到,未知参数 p 的后验仍服从 Dirichlet 分布:
p∣X=m∼Dirichlet(α1+m1,…,αK+mK).也就是说,每个类别的先验参数加上该类别的观测次数,就得到后验参数。
例如一个三面骰子的先验为 Dirichlet(1,1,1),观察计数 (2,1,0) 后,后验为 Dirichlet(3,2,1)。各面的后验均值是 (3/6,2/6,1/6):未出现的第三面仍保留正概率。一般地,第 i 个概率的均值为 αi/∑jαj,观察后用更新后的参数代入即可。
这说明如何更新一个骰子的类别概率;它本身还不是选择老虎机的决策算法。若每台机器只返回成功/失败,就分别用 Beta 后验,Thompson Sampling 每轮对每台机器抽一个候选成功率,再选择候选值最大的机器,具体过程见 Sampling Method。
10. 从 Gamma 采样得到 Dirichlet 和 Beta#
这几个分布不只是公式里都出现了 Gamma 函数。我们还可以从 Gamma 分布采样,生成 Dirichlet 样本:独立抽取 Yi∼Gamma(αi,rate=1),再令 pi=Yi/∑jYj,所得向量就服从 Dirichlet(α)。所有 Gamma 必须使用相同 rate,归一化时这个共同尺度会抵消。NumPy 的采样说明
当 K=2,p2=1−p1,Dirichlet 密度就化为 p1α1−1(1−p1)α2−1/B(α1,α2),即 p1∼Beta(α1,α2)。所以,二分类的 Dirichlet 分布可以用一个 Beta 分布表示:它描述 p1,另一个概率由 p2=1−p1 确定,并不是两个彼此独立的成功率。
NOTE如何根据已有分布采样?可以接着看 Sampling Method。