0. 生成器和判别器各自要学什么#
GAN 有两个模型:生成器 G 根据随机输入 z 生成样本,判别器 D 判断样本像不像真实数据。D(x) 越接近 1,表示判别器越倾向于认为 x 是真实样本。原始论文把训练目标写成:
GminDmax[Ex∼pdatalogD(x)+Ez∼pzlog(1−D(G(z)))]这个式子的意思是:判别器希望括号里的值越大越好,生成器则希望它越小越好。实际训练时,D 和 G 交替更新,并不会在一步之内同时求出最优解。
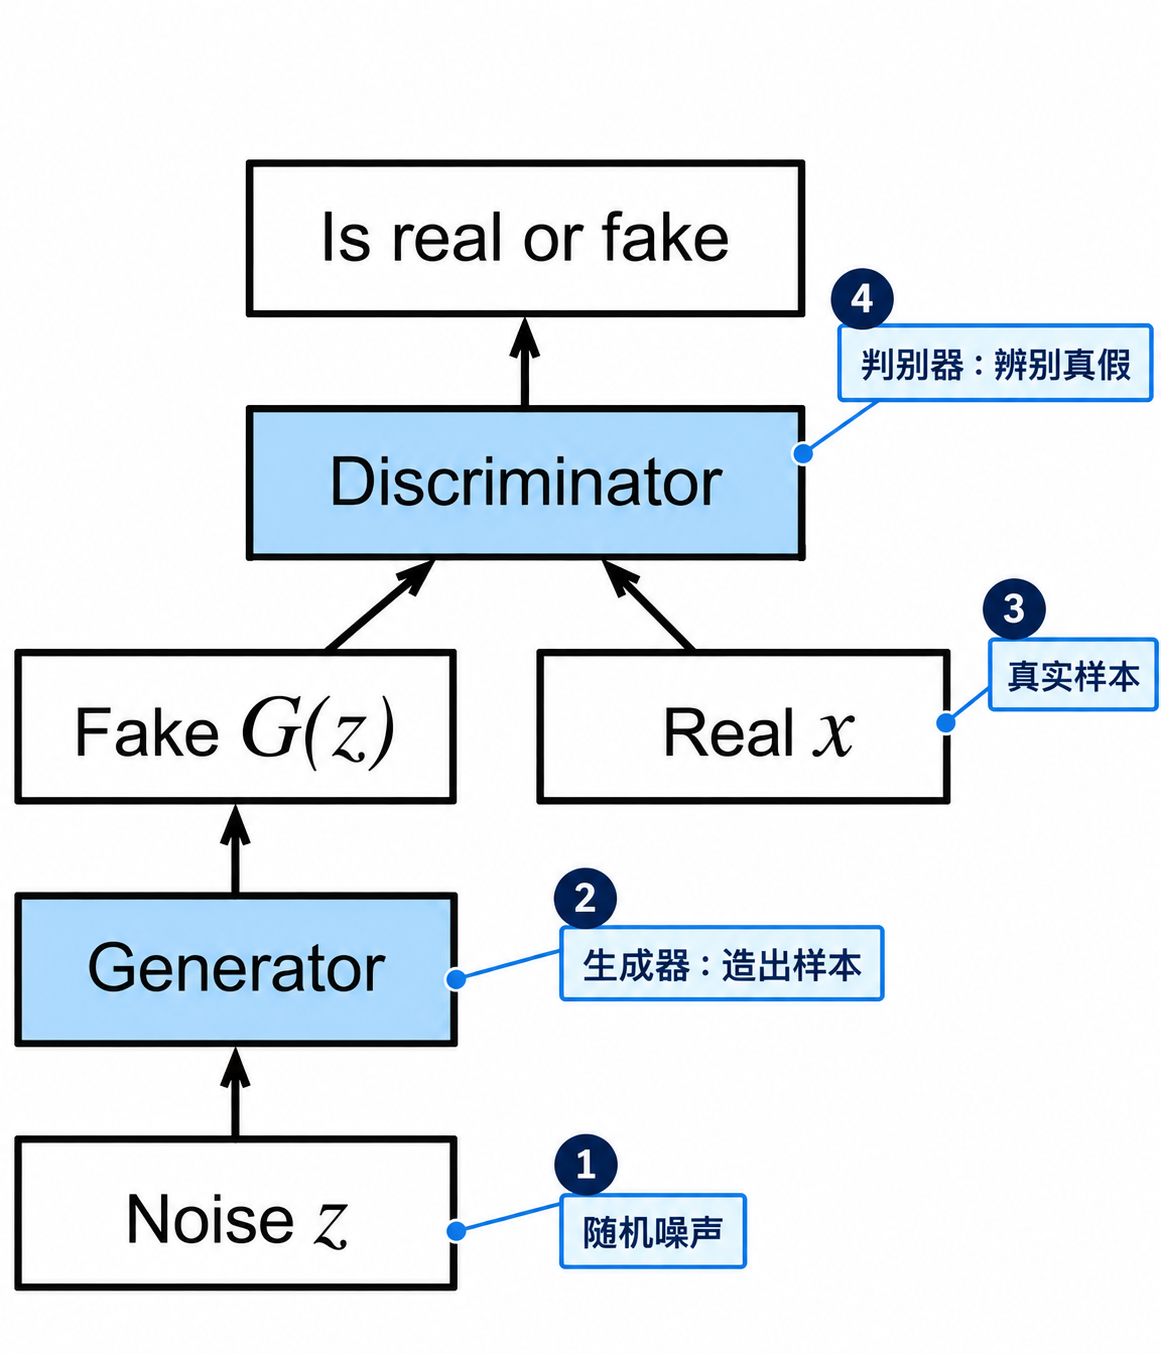
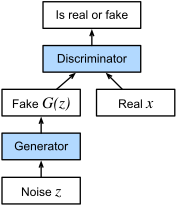
- 从①向上读:噪声 z 先进入②生成器,变成假样本 G(z),再进入④判别器。噪声提供不同的输入,生成器负责把它变成与真实数据形状相同的样本。
- ②输出的假样本要交给④判断;仅仅“生成了一张图”还不等于学到了真实数据分布,训练要利用判别器的反馈继续调整生成器。
- 右侧③的真实样本 x 不经过生成器,直接送入同一个判别器。两条输入路径解释了损失中为什么分别有真实样本项和生成样本项。
- ④对两类输入辨别真假。图中黑色箭头画的是前向数据流,没有画参数更新或反向梯度;蓝色引线只对应中文标注。
原图:《Dive into Deep Learning》GAN 章节,Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,CC BY-SA 4.0。此版本添加中文辅助标注,标注版同样采用 CC BY-SA 4.0;查看原始图片。
0.1 用样本平均近似期望#
这里 x 是训练集中的真实样本,pdata 是产生真实样本的分布;z 是随机噪声向量,pz 是我们自己选的噪声分布,例如标准正态。G(z) 与 x 形状相同,例如都是一张图片。训练时,我们不断抽取新的输入样本,并更新 G、D 各自的网络参数。
Ex∼p[f(x)] 表示按分布 p 对 f(x) 加权平均。实际训练通常无法遍历整个分布,因此抽取 m 个样本,用 m1∑i=1mf(xi) 近似期望。于是前面的目标在一个 batch 上变成:
V=m1i=1∑m[logD(xi)+log(1−D(G(zi)))].第一个期望对真实样本上的 logD(x) 求平均,第二个期望对噪声样本对应的 log(1−D(G(z))) 求平均。采样时,无需为每个噪声指定一张真实图片作为生成目标。本文使用自然对数。若正确类别的预测概率从 0.1 提高到 0.9,负对数损失就从约 2.303 降到 0.105,所以它会惩罚“很自信地判断错误”。
下面先把判别器看成一个普通的二分类模型,写出它的损失;再看怎样利用判别器的输出训练生成器。推导需要对数和求导基础;比较两种生成器损失的梯度时,还会用到链式法则。
1. 判别器和生成器的损失函数#
1.1 判别器:把真实样本和生成样本分开#
判别器要把真实样本 x 判为真、生成样本 G(z) 判为假。更新 D 时固定 G。
设标签为 y∈{0,1},模型认为样本为真的概率为 d,则二元交叉熵为
ℓ(d,y)=−ylogd−(1−y)log(1−d).代入 y=1,只剩 −logd;代入 y=0,只剩 −log(1−d)。因此,真实样本标签为 1、生成样本标签为 0 时,分别求平均再相加就得到判别器损失:
LD=−Ex∼pdatalogD(x)−Ez∼pzlog(1−D(G(z))).等价地,判别器最大化 V(D,G)=−LD:
V(D,G)=Ex∼pdatalogD(x)+Ez∼pzlog(1−D(G(z))).
1.2 生成器:让生成样本更像真的#
生成器想让判别器把生成样本当成真的,也就是让 D(G(z)) 变大。更新 G 时先固定 D;原始总目标中的真实样本项与 G 无关,因此生成器只需最小化:
LGminimax=Ez∼pzlog(1−D(G(z))).训练刚开始时,生成样本通常很容易被识别为假,D(G(z)) 可能接近 0。此时判别器已经很确定“这是假的”,原始损失传给生成器的梯度可能很小,更新就会很慢。论文还提出另一种训练写法:直接要求生成器提高判别器给生成样本的“真实”分数,即最小化
LGalternative=−Ez∼pzlogD(G(z)).论文把这个替代损失称为 non-saturating loss(非饱和损失)。它和原始损失都希望提高 D(G(z)),但函数形式和梯度不同。训练初期,非饱和损失通常能给生成器提供更强的梯度信号。不过,梯度还要穿过整个判别器才能到达生成器,因此换一种损失也不一定能解决所有梯度问题。
损失值的大小并不能直接说明梯度有多大,需要实际求导来比较。设判别器最后一个 sigmoid 的输入为实数分数 u,输出 d=σ(u)=1/(1+exp(−u))。它把任意实数映射到 (0,1) 内,供模型表示“真实”的概率。由求导可得 dd/du=d(1−d)。对一条生成样本:
dudlog(1−d)=−d,dud(−logd)=d−1.例如 d=0.01 时,两者分别是 −0.01 和 −0.99。通过链式法则,它们还要乘上从 u 到生成器参数的导数;所以上面的数值只比较了最后输出层传回去的梯度,生成器最终收到的梯度还取决于后面的连乘。
1.3 换了生成器损失后,总目标有什么不同#
采用原始极小极大目标时,生成器最小化、判别器最大化同一个 V(D,G):
GminDmax V(D,G)=GminDmax[Ex∼pdatalogD(x)+Ez∼pzlog(1−D(G(z)))].若生成器采用上面的替代损失,判别器的目标不变,但不能再说双方都在优化同一个极小极大目标。
2. 交替更新判别器和生成器#
一次训练迭代可拆成两步:
- 更新 D:抽真实数据和噪声,将生成样本作为标签 0 的输入,最小化 LD。这一步不更新 G,通常将生成样本从 G 的计算图中分离。
- 更新 G:再抽噪声,通过 G 和 D 计算生成器损失。固定 D 的参数,但仍要通过 D 对其输入求导,才能把梯度传回 G。若把整个 D 前向过程都放进不记录梯度的区域,G 就收不到信号。
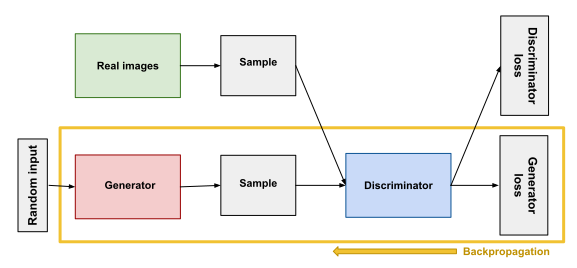
沿图中黄色框读生成器这一步:黑色箭头从随机输入向右走,直到 Generator loss;黄色反向箭头则从损失穿过 Discriminator,回到 Generator。经过判别器求梯度,不等于更新判别器参数。上方真实图片分支不参与这次生成器损失,更新的只有生成器;这正是“冻结参数”和“切断计算图”的区别。
图源:Google Developers,The Generator,Figure 1,CC BY 4.0。保留原图,黄色框与箭头均为原作者标记。
minGmaxD 表示一个模型要最小化、另一个要最大化,不要求每一轮把 D 完全训练到最优。原始论文 Algorithm 1 在每轮中先更新判别器 k 次,再更新生成器一次。算法框中的生成器使用原始极小极大损失,正文另外提出了前述非饱和损失;实现时要明确选用哪一种。