0. AUC 评估什么
本文的 AUC 指 ROC-AUC。它回答的问题是:模型能否让正样本的分数排在负样本前面?AUC 可以用 ROC 曲线下的面积表示,也可以通过比较正、负样本的分数来计算。下面先推导这两种算法为什么等价,再看推荐任务为什么还需要按用户计算 GAUC。AUC 只评价排序;概率准不准、某个阈值下分类对不对,还需要另外评估。
例如两个正例的分数是 0.9、0.2,两个负例是 0.8、0.1。四对正负样本中,正例有三对排在前面,AUC 为 。如果把所有分数平方,顺序不变,AUC 还是 0.75,但分数的具体数值已经改变。AUC 因而不能单独说明预测概率是否可信;怎样比较预测概率与实际发生频率,见概率校准。这个例子只有四个样本,也不足以判断模型是否校准。
1. 从分类阈值画出 ROC 曲线
理解 AUC,可以先从 ROC (Receiver operating characteristic) 曲线和混淆矩阵看起。
混淆矩阵统计给定分类阈值下各类样本被判对和判错的数量:
| 真实类别 | 预测为正 | 预测为负 |
|---|---|---|
| 正例 | TP:真正例 | FN:假负例 |
| 负例 | FP:假正例 | TN:真负例 |
先约定:真实标签 1 为正例,0 为负例;分数 越大越倾向正类,预测规则为 时判正, 是阈值。TP 是真正例数,FN 是漏掉的正例数,FP 是误报的负例数,TN 是判对的负例数。、 分别是真实正负例总数,评估集必须两类都有。
绘制 ROC 曲线主要用到 2 个指标:
True positive rate (TPR):真正率,也叫 Recall(召回)、Sensitivity(灵敏度),表示所有正样本中被模型预测为正样本的比例。
阈值降低时,TPR 只会增加或不变。阈值高于所有分数时 TPR 为 0,低于或等于最小分数时 TPR 为 1。分数不必是概率;即使在 内,按 判正时,阈值为 1 也会保留得分恰好为 1 的样本。
False positive rate (FPR):假正率,表示所有负样本中被模型误判为正样本的比例。
阈值降低时,FPR 也只会增加或不变。阈值高于所有分数时 FPR 为 0,低于或等于最小分数时 FPR 为 1。
每个阈值对应一对 FPR、TPR。把阈值从高于最大分数逐渐降到最小分数,曲线从 走向 ;横轴是 FPR,纵轴是 TPR。只有跨过实际出现的分数时,有限样本上的计数才会改变。 ROC 曲线如下:
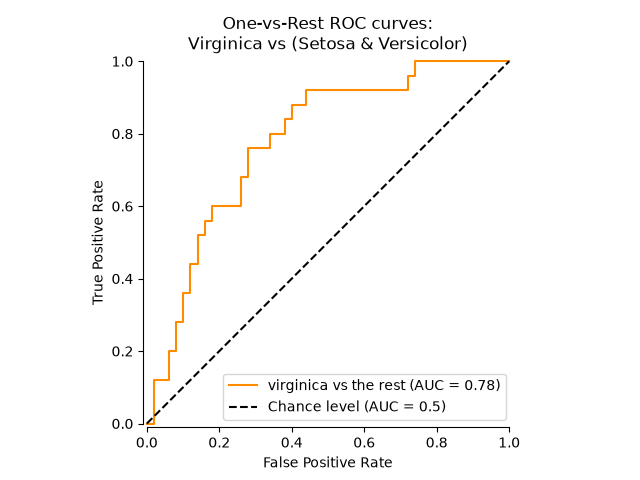
先沿橙色阶梯从左下向右上看:竖直上移增加检出的正例,水平右移增加误报的负例。每个位置对应一个阈值,不能把整条曲线当成某一个固定阈值的表现。
图源:scikit-learn 官方 ROC 示例,The scikit-learn developers,BSD-3-Clause 许可,原图未修改。这里把 virginica 设为正类,其余两类设为负类;橙色阶梯线随阈值降低向右上方移动,横轴为 FPR,纵轴为 TPR,黑色虚线是随机排序的总体基准。图例的 AUC 为 0.78,来自官方鸢尾花实验,和后面四样本手算的数据不同。
左上角 表示没有误报且没有漏报。同一 FPR 下 TPR 越高越好;不能把 TPR 当作总体正确率,因为它只看真实正例。分数与标签无关时,总体的 ROC 是对角线;有限样本的随机排序曲线会在其附近波动,不要求每个阈值下恰好相等。
2. 曲线下面积为什么能评价排序
“ROC 曲线越靠左上方越好”是直观判断,可以用曲线下的面积(Area Under the Curve,AUC)来量化:面积越大,表示整体排序表现越好。但两条曲线可能交叉,所以 AUC 较大不保证每个阈值或每个 FPR 区间都更好。AUC 为 1 时,存在一个阈值能把正、负样本完全分开;等价地,所有正样本的分数都高于所有负样本(没有跨类别并列)。这不表示任意阈值下 :阈值高于所有正样本时, 仍为 0。
从排序的角度理解 AUC,需要先回顾 和 。
给定阈值 与模型输出分数 : 是所有正样本中满足 的占比; 是所有负样本中满足 的占比。它们是样本集合在该阈值下的统计量,不是单个样本的“预测为正概率”。即使模型输出的是校准后的概率,比较两个分数的大小 ,也只是在比较排序。
ROC 上某一个点满足 ,只说明在这个阈值下,正样本被判为正的比例高于负样本被误判为正的比例;不能据此推断任意一对正负样本的分数顺序。AUC 则通过所有阈值对应的曲线面积评价整体排序。
TIP分别从正样本和负样本中独立、均匀地抽取一个,AUC 等于正样本分数更高的概率,加上两者同分概率的一半。改变决策阈值得到 ROC 曲线,AUC 就是这条曲线下的面积。
回头读 ROC 图时,可以把阈值想成从最高分向最低分移动的扫描线:越过一个正样本,曲线向上增加 ;越过一个负样本,曲线向右增加 。正样本越早出现,后续向右走时下方累积的面积就越大。这把“按分数排队”和“计算 ROC 面积”连成了同一件事;遇到同分组时,需要一起处理该组,并与逐对比较中同分计半分的约定对应。
想进一步看几何解释,可对照 Matthew Drury 的格点证明和 Alexej Gossmann 的逐对比较与面积计算。它们分别从样本对和积分解释同一个结论;本文继续使用下方包含同分处理的公式。
3. AUC 的计算
有限样本的 ROC 可以用梯形面积直接计算。下面用样本对计数,说明面积为什么与排序相对应。
3.1 逐对比较正负样本
设正例有 个、负例有 个,总共有 个正负样本对。对每一对,正例分数更高记 1,相同记 0.5,更低记 0,最后取平均:
上标 、 分别表示正负例, 是指示函数:条件成立为 1,否则为 0。
为什么它等于面积?无并列时,从高分到低分扫阈值,遇到正例只让 ROC 向上走,遇到负例则向右走 。这条横线的高度,是已经扫过、比该负例分数高的正例比例。因此该条面积就是“胜过这个负例的正例数”除以 ;对所有负例相加便得到上式。有并列时按整个并列组连接 ROC 点并计算梯形面积,恰好给每一对同分的正负样本计 0.5。
举个例子:
| class | label | pre |
|---|---|---|
| A | 0 | 0.1 |
| B | 0 | 0.4 |
| C | 1 | 0.3 |
| D | 1 | 0.8 |
共有 2 个正样本、2 个负样本,可以组成 2 * 2 对正、负样本。
正样本 C 排在 1 个负样本前面。
正样本 D 排在 2 个负样本前面。
因此,该模型的 AUC 为:
如果正、负样本的输出得分相同,这一对按 0.5 计数。
| class | label | pre |
|---|---|---|
| A | 0 | 0.1 |
| B | 0 | 0.4 |
| C | 1 | 0.4 |
| D | 1 | 0.8 |
共有 2 个正样本、2 个负样本,可以组成 2 * 2 对正、负样本。
对于正样本 C,它胜过 A 得 1 分,与 B 同分得 0.5 分,合计 1.5。无需人为决定并列样本的先后。
正样本 D 排在 2 个负样本前面。
因此,该模型的 AUC 为:
逐对比较的复杂度是 ;若用总样本量 表示,最坏为 。
3.2 用正样本的秩和计算 AUC
对 个正样本和 个负样本按预测分数从低到高排序,可以用正样本的秩计算 AUC。如下表:
| class | label | pre | rank |
|---|---|---|---|
| A | 0 | 0.1 | 1 |
| B | 0 | 0.4 | 2.5 |
| C | 1 | 0.4 | 2.5 |
| D | 1 | 0.8 | 4 |
根据上表的 :
第 1 个正样本 C 的 。它的分数高于 A(计 1),与 B 相同(计 0.5),比较得分合计为 ,恰好等于 。
第 2 个正样本 D 的 ,分数高于两个负样本,比较得分为 。
无并列时,把正例也按分数从低到高编号,第 个正例的秩减去 ,就是比它低分的负例数。注意“秩更大”表示“得分更高”,不要与表格中行的位置混淆。
这样就能算出每个正样本排在多少个负样本前面,得到:
若多个正例彼此并列,逐个计算 不一定还能解释为各自胜过的负例数,但上面的总和公式仍成立:所有正例之间的秩贡献合计仍是 ,减掉它后只剩正负例比较的贡献。排序复杂度为 。
出现并列分数时,所有并列项都取可占秩的平均秩。例如 4 个样本并列占第 秩,则每个样本的秩都是 。这恰好对应每个跨类别并列样本对在 AUC 中计 0.5。
上表的 AUC 为 。对另一组没有并列的四样本数据 ,正样本分别胜过 1 和 2 个负样本,所以 AUC 为 。
4. 为什么推荐任务要按用户计算 GAUC
广告推荐中仍可使用全局 AUC,但如果业务重点是“同一用户的候选商品如何排序”,全局 AUC 会把不同用户的商品分数也放在一起比较,没法单独反映每个用户内部排得好不好。
例如要为每个用户选择最靠前的商品,我们先关注用户内部的相对分数。实际广告系统也可能需要概率校准来估计收益,这部分仍需要另外评估,不能只看 GAUC。
组内排序和全局排序的差别,可以用两个用户的推荐结果来说明。
假设用户 A 和 B 各自的正例都排在该用户的负例前面,那么两个用户内部的 AUC 都为 1。这里关注的是推荐顺序;分数是否能解释为概率、某个阈值下分类是否正确,需要另外评估。
例如,在一组包含四个正例、四个负例的八样本数据中,两个用户内部都可以排对,而合并后四个正例分别胜过 4、4、2、2 个负例。全局共有 16 个正负样本对,AUC 就是 。降低全局 AUC 的是新增的跨用户比较。
用更小的四样本例子,可以逐对核算这个差别:用户 A 的正负例分数为 0.9、0.8,用户 B 的正负例分数为 0.2、0.1。两个用户内部都排对,AUC 均为 1;混在一起有四个正负对,其中 B 的正例 0.2 输给 A 的负例 0.8,全局 AUC 便是 。模型没有改变任何用户内的排序,差别来自加入了跨用户比较。
Group AUC (GAUC) 用来评价组内排序:先在每个用户(或 query)内部计算 AUC,再按事先定义的业务权重加权平均。只有同时含正、负样本的组才有 AUC;全正或全负组应跳过,并在统计中报告。常见做法是按组内样本数或曝光数加权,也可以按点击数、时间、位置等业务规则设置权重。权重决定哪些组对最终结果影响更大,比较两个 GAUC 时必须先确认加权规则相同。
令 为同时含正负例的有效组集合, 为预先确定的权重:
例如两个有效组的 AUC 为 1、0.5,样本数为 2、8;按样本数加权得 ,按用户等权则是 0.75。若按 加权,就相当于从所有组内正负样本对中均匀抽取一对,按正例分数更高计 1、同分计 0.5、更低计 0,计算平均得分。跳过单一类别组后,分母也必须排除它们;若没有任何有效组,GAUC 未定义,不能报告为 0。
参考资料
[1] https://www.jianshu.com/p/f9f8e29abbe0
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。