0. 知道分布后,怎样生成样本
知道一个概率分布是什么,还不等于知道怎样从中抽样。本文讨论的是:怎样利用容易生成的随机数,得到服从目标分布的样本。这些样本既可以模拟随机现象,也可以用于 Monte Carlo 估计,例如用样本平均值估计期望。
记 为随机变量 服从分布 , 是按该分布计算 的平均值。函数 指定了要统计的量,例如 就是在估计 的均值。独立抽取 后,用 估计 ,就是 Monte Carlo 估计;样本越多,通常越稳定,但不等于每次都更接近真值。
下文先用 Thompson Sampling 说明怎样靠参数采样选择动作,随后介绍逆变换采样(Inverse Transform Sampling)和拒绝采样(Rejection Sampling)的原理。若你关心的是语言模型如何使用 Temperature、Top-K、Top-P 选下一个 token,请阅读 LLM Decoding。那里讨论的是如何修改、截断或搜索 token 分布;这里讨论的是给定目标分布后,怎样正确地抽样。
1. 用 Thompson Sampling 选择老虎机
假设有 台机器,第 台每次返回奖励 ,成功概率 未知但固定。采用独立先验:
这里每台机器有自己的成功概率, 不需要加起来等于 1。因此,不能把它们默认当成一个 Dirichlet 分布的概率向量。Beta 是定义在 上的单变量分布;把它写成二分类概率向量 后,也可以用 Dirichlet 表示;其中只有一个概率需要单独确定。
最初取先验参数;之后每观察到一次成功,就给 加 1,每观察到一次失败,就给 加 1。更新后的两个参数确定这台机器当前的后验分布。更新原理可先看 Gamma、Beta 与 Dirichlet 分布,第 6 节。
在这个独立 Beta–Bernoulli 模型里,每轮操作如下:
- 从每台机器当前的后验中抽一个候选成功概率:
- 选择 ,即候选成功率最大的那台机器的编号,实际尝试这台机器
- 观察它返回的奖励 ,只更新被选择机器的参数:
例如有两台机器,当前后验分别是 和 。假设这一轮从两个后验抽到的数分别是 0.8 和 0.55,就选择第一台;如果它返回成功 1,第一台更新为 ,第二台仍是 。下一轮要重新从两个后验抽数,不是永远选择这次抽到 0.8 的机器。抽出的数是对未知成功率的一次假设,并不是机器这次返回的实际奖励。
抽到最大的 只是本轮选择机器的依据,不意味着这台机器本轮必定成功,也没有提供其他机器的实际结果。通常只有被选择机器的结果可见。如果另一个模型把机器之间的关联写进先验,或者一次能看到多台机器的反馈,才可能同时更新其他机器。Thompson Sampling 教程,第 3 章
例如,某台机器从 出发,被选择三次,依次得到 ,后验就是 ,其均值为 。下面是一次决策与更新的 Python 实现:
import random
def thompson_step(alpha, beta, pull, rng): # pull(a) 实际尝试第 a 台机器,并返回 0 或 1 if not alpha or len(alpha) != len(beta): raise ValueError("alpha and beta must have the same nonzero length") if any(a <= 0 or b <= 0 for a, b in zip(alpha, beta)): raise ValueError("Beta parameters must be positive") samples = [rng.betavariate(a, b) for a, b in zip(alpha, beta)] arm = max(range(len(samples)), key=samples.__getitem__) reward = pull(arm) if reward not in (0, 1): raise ValueError("Bernoulli reward must be 0 or 1") alpha[arm] += reward beta[arm] += 1 - reward return arm, reward这段代码直接调用了现成的 Beta 随机数生成器。若需要自己构造目标分布的采样过程,可以考虑下面的逆变换采样和拒绝采样。
2. 逆变换采样
2.1 用累积分布函数把样本变成均匀随机数
累积分布函数定义为 。它单调不减、右连续,取值位于 ,但不一定严格递增,也不一定能取到区间内每一个值。若分布有密度,用 表示; 是密度值, 才是恰好取到这个点的概率。
如果 连续,那么 。 这就是概率积分变换(Probability Integral Transform)。为便于理解证明,先看 在其取值介于 0 与 1 的区间上严格递增的情形。对 :
连续 CDF 即使有平坦区间,这个结论仍成立;那些区间没有概率质量,但这时有些累计概率对应一段区间,普通反函数就不再处处有唯一的值。对于离散分布,结论一般不成立:若 ,则 只能取 和 ,显然不是连续均匀分布。
2.2 用分位数函数生成样本
可以这样理解:CDF 把数值 转换成“取值不超过 的概率”;采样时则反过来,把随机选出的累计概率转换回数值。例如, 时,就寻找累计概率第一次达到 70% 的位置。
具体做法是先生成均匀随机数,再用 CDF 的广义逆把它变成目标分布的样本。对任意 CDF,广义逆也称为分位数函数(quantile function),定义为:
这里 表示下确界,可以直观地理解为满足 的最左边界。
先生成 ,再令 。由 CDF 的单调性和右连续性:
这样生成的 就服从我们想要的分布。这个方向不要求 连续,也不要求有概率密度。 普通反函数存在时,广义逆与普通反函数一致。Devroye,Non-Uniform Random Variate Generation,第 II 章
例如,离散变量取值为 ,对应概率为 :
长度分别为 的区间,恰好产生相应的采样概率。
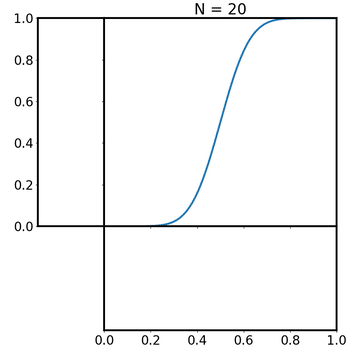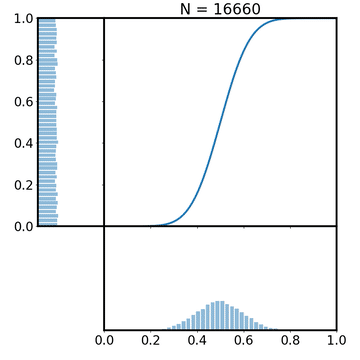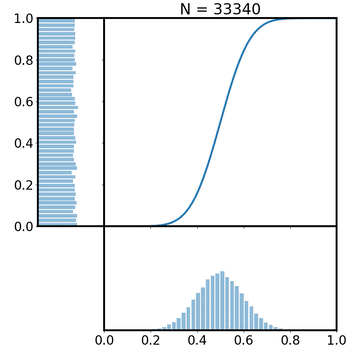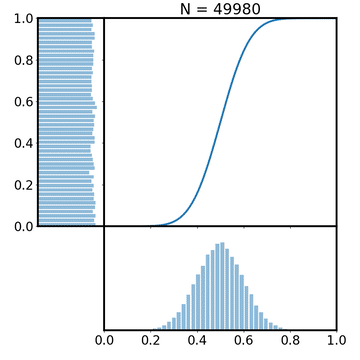
动画把两个方向放在同一张图:左边窄直方图记录 ,它在 0 到 1 之间近似均匀;上方蓝色曲线是目标分布的 CDF;下方直方图记录 。读一次变换时,从纵轴上的某个 水平找到蓝色曲线,再向下读出横轴的 。同样宽的 区间,在 CDF 陡峭的中间部分对应更窄的 区间,所以样本会集中在那里。 是已生成样本数;样本越来越多时,直方图形状才逐渐稳定。
图中的目标是正态分布,下面的代码示例则是指数分布;改变的是 CDF 和逆函数,采样步骤相同。原动画未改动:Davidjessop,Wikimedia Commons 文件页,CC BY-SA 4.0;原动画链接。


2.3 指数分布的采样实现
设 ,其中 是 rate。对 ,有 ,所以:
下面的实现使用 Python 标准库。random() 返回 中的浮点数,避免了 时的无穷值; 时得到合法的边界值 0。log1p(-u) 比直接计算 log(1-u) 更适合很小的 。
import mathimport random
def sample_exponential(rate, rng): if not math.isfinite(rate) or rate <= 0: raise ValueError("rate must be positive and finite") return -math.log1p(-rng.random()) / rate
rng = random.Random(2024)samples = [sample_exponential(2.0, rng) for _ in range(30000)]print(sum(samples) / len(samples)) # 应接近理论均值 1 / 2理论推导使用理想连续随机数;程序使用有限精度伪随机数。对于分位数函数没有简单表达式的分布,还需数值求逆,并控制数值误差。
3. 拒绝采样
3.1 按什么概率接受候选样本
目标密度为 ,选择一个容易采样的提议密度(proposal density),并找到有限常数 ,使:
在目标分布的整个支撑上都成立。“支撑”在这里指目标可能取到的范围; 是候选样本的密度, 把它向上放大成为覆盖目标的包络。特别地, 的地方不能被 漏掉。不能只在若干测试点检查这个上界,就认定条件成立。
每次独立生成 和 。独立的均匀数 用来执行一次“以指定概率接受”的试验:对 ,。若:
就接受 ;否则重新生成。设接受事件为 , 可以先理解成一个待统计的区间(证明也适用于更一般的可测集合):
令 得 ,所以:
被接受样本的分布正是目标分布。直觉上,先在包络曲线 下均匀取点,再保留落在 下的点:候选的密度 与接受概率中的 恰好抵消。
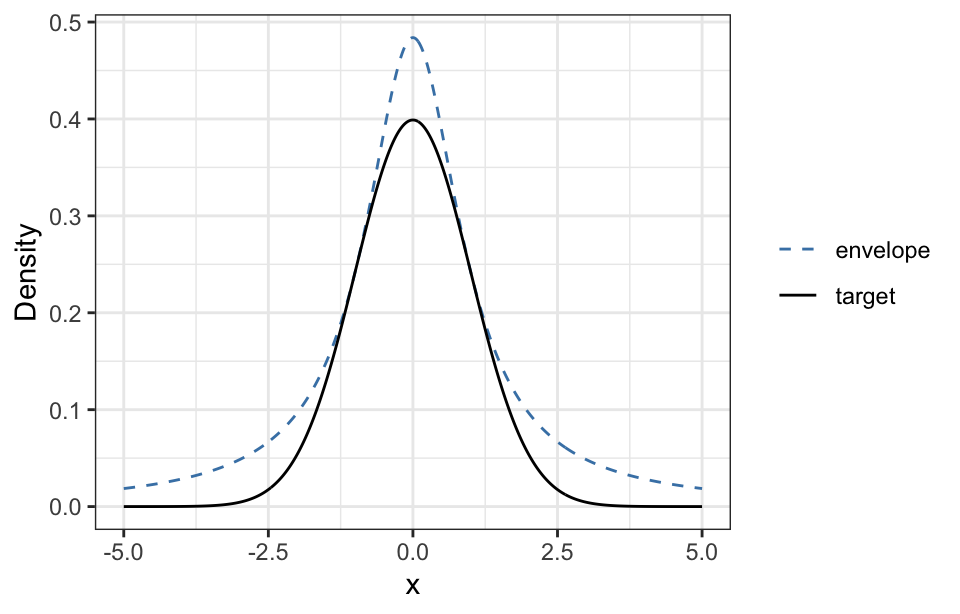
读这张图时,横轴是候选取值,纵轴是密度或放大后的密度。先在同一横坐标上比较黑线与蓝线的高度,再看两端:蓝线的尾部高于黑线,说明那些位置提出的候选更容易被拒绝。
黑色实线是标准正态目标密度 ,蓝色虚线是放大后的 Cauchy 提议密度 。同一个横坐标上,两条曲线的高度之比 就是接受候选 的概率:两线越接近,候选越容易保留;包络高出目标很多的地方,拒绝就更多。蓝线必须在整个范围盖住黑线,不能只看中心附近。原图:Niels Richard Hansen、Johan Larsson,《Computational Statistics with R》,图 6.1,未改动。
3.2 目标密度未归一化时的拒绝采样
假设只知道非负函数 ,目标密度为:
若能够找到已知的有限常数 ,满足 ,则接受概率可以直接写成:
无需在算法中计算 。同样积分可得:
因此,拒绝采样并不要求后验与先验共轭。难点通常是找到一条既能盖住目标函数、又不比它高太多的包络;如果 很小,大量候选会被丢弃。UC Berkeley Data 102:Rejection Sampling
例如,取 (指示函数 在区间内为 1、区间外为 0)、 为 的密度、。接受概率为 ,接受率为 ,结果密度为 ,均值为 。
import random
def sample_linear_density(n, rng): if not isinstance(n, int) or n <= 0: raise ValueError("n must be a positive integer") samples, proposals = [], 0 while len(samples) < n: y = rng.random() u = rng.random() proposals += 1 if u < y: samples.append(y) return samples, n / proposals
samples, acceptance = sample_linear_density(30000, random.Random(2024))print(sum(samples) / len(samples)) # 接近 2 / 3print(acceptance) # 接近 1 / 24. 后验分布不好采样时怎么办
前面的 Thompson Sampling 需要从成功概率的后验分布中抽样。后验长什么样,会决定这些方法是否好用。令 是未知参数, 是已经观察到的数据; 是先验, 是给定参数时的数据似然, 只是分母中遍历参数空间的积分变量。贝叶斯后验常写为:
如果先验与似然共轭,后验仍是熟悉的分布,更新参数和调用现成采样器都会方便一些。不共轭时,也可以用其他方法采样。逆变换需要能够计算分位数函数;拒绝采样只需可计算的未归一化目标及有效包络。即使概率密度写得出来,这些操作也未必高效。
如果包络难找,可以考虑 MCMC(Markov Chain Monte Carlo,马尔可夫链蒙特卡洛):根据当前样本提出下一个候选,构造一条长期分布为目标分布的随机序列。这与每次重新独立抽样不同。例如 Metropolis–Hastings 从满足 的当前位置 提议 ,其接受概率为:
这里 是从当前位置提出候选的概率密度, 是反方向的提议密度;接受则移动到候选,拒绝则保留当前位置作为本轮输出。后验的归一化常数在比值中抵消;对称提议分布的两个 项相同,可以约去;一般提议分布不能省略这个比值。使用 MCMC 时,还要检查链是否收敛、相邻样本有多强的相关性。链输出的样本通常相互依赖,尚未收敛时也不能当作准确的后验样本。Hastings, 1970
如果想看“链如何走”而不只看最后的直方图,可以打开 Chi Feng 的 MCMC Interactive Gallery,先选 Random Walk Metropolis Hastings。重点观察新提议的位置、接受或拒绝后的当前位置,以及连续位置之间的相关性;不要把一段看似覆盖充分的轨迹当成已经收敛的证明。该开源演示同时提供参数控制,便于比较步长过小导致移动缓慢、步长过大导致较多拒绝的现象。
参考资料
- Russo et al., A Tutorial on Thompson Sampling,第 3 章的 Beta–Bernoulli 模型
- Luc Devroye, Non-Uniform Random Variate Generation,第 II、III 章的逆变换与拒绝采样
- Jacob Steinhardt, Data 102 Lecture 8,未归一化目标与 MCMC 的衔接
- Hastings, Monte Carlo Sampling Methods Using Markov Chains and Their Applications,Metropolis–Hastings 的原始文献
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。