0. 这个生成器要做什么
本文用 Python 和 PyTorch 实现一个小型字符级文本生成器。我们会先准备输入和下一个字符的标签,再用掩码挡住不该看的位置,最后训练模型,让它逐个字符续写。
这里的模型是 decoder-only:每层包含 causal self-attention 和逐位置的前馈网络,不使用原始 encoder-decoder Transformer 中的 cross-attention。训练语料很小,适合理解计算过程,不能据此期待通用语言能力。
NOTE本文假设你能读 Python 函数、类和数组索引。张量可以先当作多维数组:
(B, T, d)表示一批有B条文本,每条有T个位置,每个位置存d个数。模型中的“可学习”参数就是会被训练更新的数组。PyTorch 的反向传播接口会在使用处解释;没有读过 RoPE 不影响本文。Tokenization 的进一步背景见文字如何变成 token,字符编码所需的内容也会在下面介绍。
1. 从训练数据到生成文本
- 数据:文字 → token ID → 输入序列和向右错开一位的标签
- 模型:token embedding + 位置信息 → 多层 Decoder → 词表中各个候选的 logits
- 训练:每个有效位置预测下一个 token,PAD 位置不计入 loss
- 生成:选出一个新 token,接到输入末尾,再预测下一步
模型内部的隐藏向量和输出的 logits 含义不同:隐藏向量保存一个位置的特征,logits 则为词表中的每个候选提供分数。例如隐藏向量有 64 个数,不表示只有 64 个候选;后面的输出层会把它变成本文 41 个候选的分数。训练要让正确候选获得更高概率,生成才从候选里选一个。
训练时,后面的真实 token 已经在数据里,因此可以并行计算多个位置的预测。causal mask 会把每个位置能看到的范围限制在当前位置及其之前,避免模型提前看到要预测的下一个 token。生成时,后面的 token 还不存在,只能逐个选出,再接回输入。
2. 准备训练数据
2.1 字符、token ID 和 embedding
计算机需要数值输入。最简单的办法,是把每个支持的字符对应到一个整数 ID。编号只负责查找词表中的条目,编号大小本身不表示字符之间有多相似。
本文使用字符级 tokenizer。词表包含 26 个小写英文字母、10 个数字、空格、逗号、句号,再加两个特殊 token:
<pad>:只负责补齐长度,不代表真实文字,也不作为正常的预测目标<bos>:表示序列开始,让空提示词也有一个有效位置来预测首字符
因此词表大小是 26 + 10 + 3 + 2 = 41。<bos> 是一个特殊 ID,不能把字符串 "<bos>" 当成 5 个普通字符逐字编码。这份词表把 BOS 放在末尾,各字符的编号为:PAD 为 0,a 为 11,c 为 13,空格为 39,BOS 为 40。
class Tokenizer: def __init__(self): tokens = ( ['<pad>'] + list('0123456789') + list('abcdefghijklmnopqrstuvwxyz') + [',', '.', ' ', '<bos>'] ) self.dictionary = {token: i for i, token in enumerate(tokens)} self.reverse_dictionary = {i: token for token, i in self.dictionary.items()} self.pad_id = self.dictionary['<pad>'] self.bos_id = self.dictionary['<bos>']
def tokenize(self, text): unsupported = sorted(set(text) - set('0123456789abcdefghijklmnopqrstuvwxyz,. ')) if unsupported: raise ValueError(f'Unsupported characters: {unsupported}') return [self.dictionary[c] for c in text]
def character_to_token(self, character): return self.dictionary[character]
def token_to_character(self, token): return self.reverse_dictionary[token]
def size(self): return len(self.dictionary)token ID 只是查表编号,数字大小不表示字符在含义上有多接近。模型还要用可学习的 embedding 表,把 ID 转成 维向量; 就是每个位置的隐藏宽度。例如暂取宽度为 3,ID 11 对应的 a 可能查到 [0.2, -0.1, 0.7],ID 13 对应的 c 可能查到另一行。这里的数值只是示意,真正的表从初始化值开始学习。一次查表保留一行的全部坐标,而不是把 ID 11 直接当成数值 11 输入线性层。真实语言模型通常采用子词或字节级分词;本例的普通 token 恰好对应单个字符,但真实模型的 token 未必如此。
2.2 输入和标签错开一位
语料由下面这些简单句子组成。它们用句号和空格连接成一个连续文本,因此模型也会学习句子之间的连接。这里不加入 EOS,生成长度稍后由程序限制。
假设输入长度 ,从 cats 中可以构造 cat → ats。这意味着:
- 看到
c,预测a - 看到
ca,预测t - 看到
cat,预测s
训练时可以并行计算这三个预测,但每个位置只能使用当前位置及其左侧的输入。只训练最后一个位置 cat → s 也是一种做法,但它与给三个位置都计算 loss 的训练目标并不完全相同。
为了从 BOS 开始学习,在语料前放 个 PAD + 1 个 BOS,然后取所有长度为 的窗口。每个窗口的前 个 token 是输入,后 个是原始标签。
def tokenize_and_pad_training_data(max_sequence_length, tokenizer, training_data): if max_sequence_length < 1: raise ValueError('max_sequence_length must be positive') return ( [tokenizer.pad_id] * (max_sequence_length - 1) + [tokenizer.bos_id] + tokenizer.tokenize(training_data) )
def create_training_sequences(max_sequence_length, tokenized_training_data): if max_sequence_length < 1: raise ValueError('max_sequence_length must be positive') # A window has L + 1 tokens. The last legal start index is N - L - 1. return [ tokenized_training_data[i:i + max_sequence_length + 1] for i in range(len(tokenized_training_data) - max_sequence_length) ]
def split_inputs_and_labels(sequences, pad_id): inputs = [window[:-1] for window in sequences] # A PAD query must not be trained to predict BOS or any real character. labels = [ [target if source != pad_id else pad_id for source, target in zip(window[:-1], window[1:])] for window in sequences ] return inputs, labels
tokenizer = Tokenizer()max_sequence_length = 20training_data = '. '.join([ 'cats rule the world', 'dogs are the best', 'elephants have long trunks', 'monkeys like bananas', 'pandas eat bamboo', 'tigers are dangerous', 'zebras have stripes', 'lions are the kings of the savannah', 'giraffes have long necks', 'hippos are big and scary', 'rhinos have horns', 'penguins are birds', 'polar bears are white',])stream = tokenize_and_pad_training_data(max_sequence_length, tokenizer, training_data)sequences = create_training_sequences(max_sequence_length, stream)input_rows, label_rows = split_inputs_and_labels(sequences, tokenizer.pad_id)长度为 的 token 序列共有 个合法窗口;range(N - L - 1) 会漏掉最后一个。当前语料有多少普通字符,就会构造多少个窗口,最后一个字符也会出现在最后一个窗口的标签里。
2.3 用 cats 检查每个位置的输入和标签
用更短的 cats 和 展示完整过程。符号 PAD、BOS 在表中各代表一个 token:
| 滑动窗口 | 输入 x | 原始标签 | 实际训练标签 y |
|---|---|---|---|
PAD PAD BOS c | PAD PAD BOS | PAD BOS c | PAD PAD c |
PAD BOS c a | PAD BOS c | BOS c a | PAD c a |
BOS c a t | BOS c a | c a t | c a t |
c a t s | c a t | a t s | a t s |
第一行只有 BOS 位置参与训练,预测目标是 c。原始标签中与 PAD 输入对齐的 BOS 需要忽略,否则训练会要求模型从补齐用的 PAD 预测 BOS。这里把需忽略的标签写成 PAD,稍后通过 ignore_index 跳过。
右侧 padding 也遵守同样原则。例如输入 BOS c a PAD PAD 可以配标签 c a t PAD PAD。padding 的方向可以不同,但输入、标签和有效位置必须始终对齐。
3. 带掩码的自注意力
3.1 怎样算出 Q、K、V,它们有多大
设一层接收的隐藏状态为 ,其中 是一次并行处理的文本条数(batch size), 是当前输入长度, 表示实数。对每个位置做三组可学习的线性变换:
本例中,三个权重矩阵 都有 个数,各位置共享同一组权重,公式暂略去偏置。所谓线性变换,就是将输入坐标乘上不同权重并求和,形成新的坐标;代码里的 nn.Linear 做的正是这件事。
可以把 Q 理解成“这个位置在寻找什么”,K 是“这个位置用什么特征供别人匹配”,V 是“匹配后实际汇总的信息”。这只是直觉;三者都是训练得到的向量,不是固定的词性或语义标签。
先不考虑批处理和多个头,只看一个 query 怎样读取两个位置的信息。设当前 query 是 ,两个可见位置的 key 分别为 、,value 分别为 、。所有数值都是教学用的已投影向量。
- 匹配:点积是对应坐标乘积的和,所以 ,。
- 缩放:向量宽度为 2,除以 后得到分数 。这个缩放用于控制高维向量点积的数值大小;此时还没有进行概率归一化。
- 转成权重:softmax 把分数取指数,再除以指数的总和,得到约 ,两项加起来为 1。
- 汇总:输出是 。
经过 attention 得到的是汇总后的特征向量。模型还需要进一步处理并通过输出层,才能得到词表上各个 token 的生成分数。一个位置可以同时吸收多个位置的信息;如果某个 key 被 mask 掉,它的权重就是 0。后面用矩阵乘法,只是把每个 query 的同一套过程并行执行。
采用 个 attention head,即让多组较小的 Q/K/V 各自计算一套匹配和汇总,并令 。本文令每个 head 的 Q、K、V 维度都为 。例如 ,每个 head 宽度就是 16。这里的 表示分数矩阵, 表示权重矩阵, 表示后面要构造的加性 mask。拆分后形状如下:
| 张量 | 形状 | 含义 |
|---|---|---|
| Q、K、V | 每个 head 的查询、匹配和内容向量 | |
| softmax 前的 attention scores | ||
| 沿最后一个维度归一化的权重 | ||
| 加权汇总的结果 |
矩阵的行是 query 位置,列是 key 位置。例如第 2 行第 1 列表示“位置 2 从位置 1 取多少信息”。这里的转置只交换 K 最后两个维度。多头结果合并后回到 ,再经过输出投影。Transformer 原论文给出了对应公式。
把上面的形状表和 Jay Alammar 的原图对照起来:紫色 Q 有两行,表示两个查询位置;橙色 Kᵀ 转置后有两列,表示两个被查询位置。两者相乘得到的是 2×2 的位置匹配矩阵。逐行 softmax 后,再乘蓝色 V,输出的粉色 Z 又变成每个位置一行的特征向量。
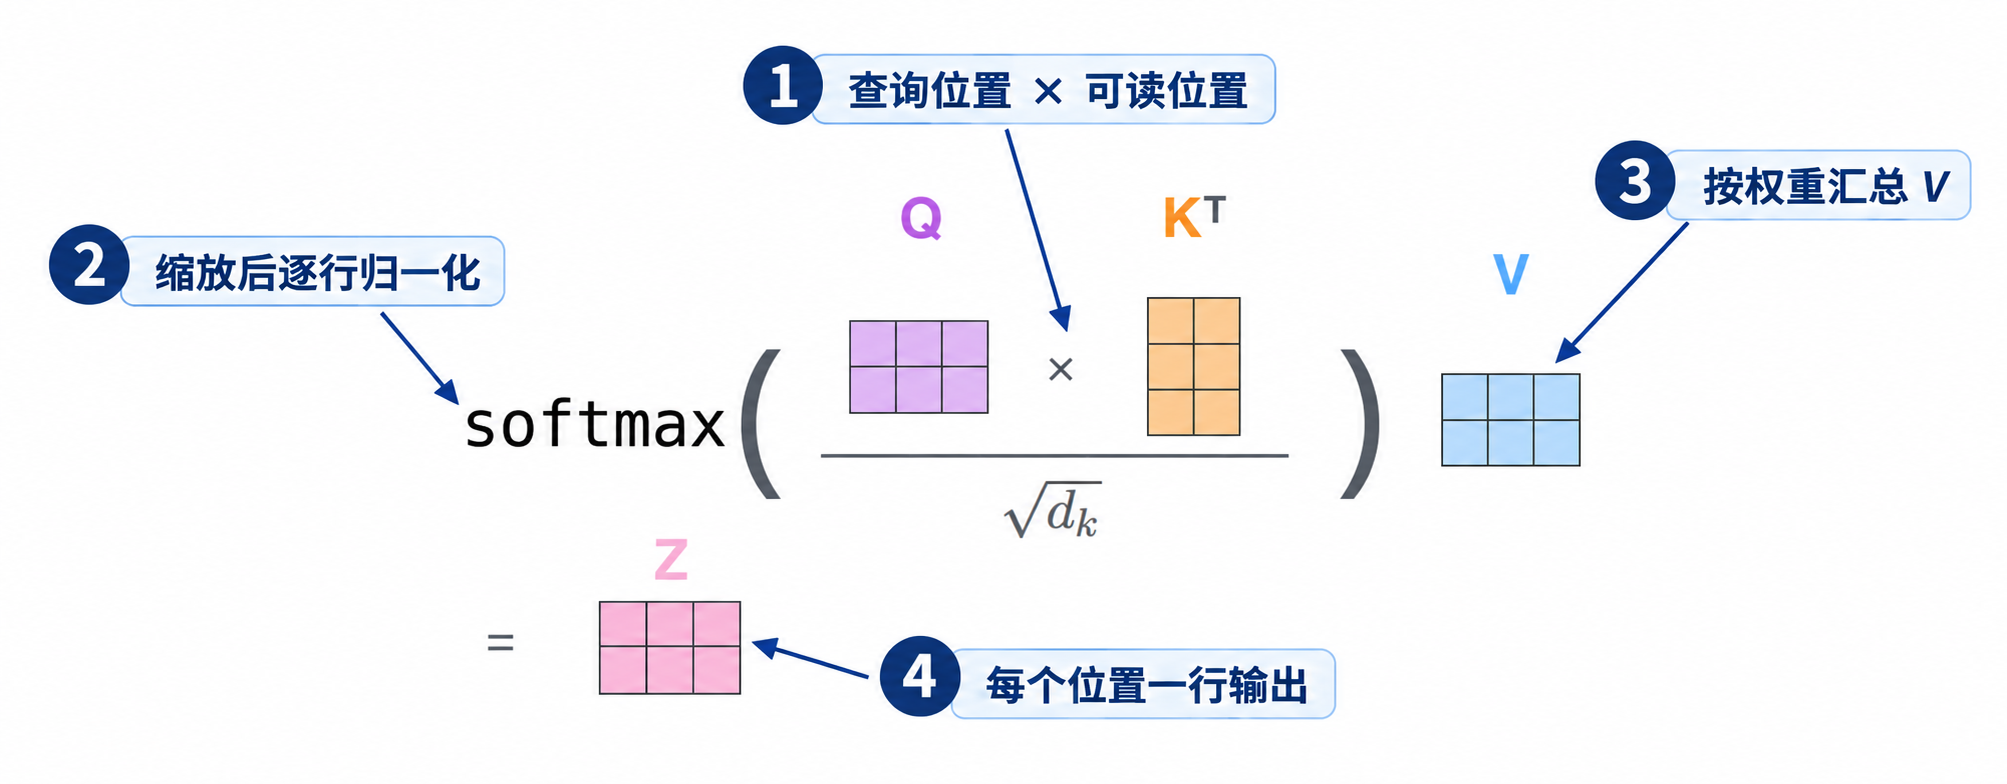
原图:Jay Alammar,The Illustrated Transformer — Matrix Calculation of Self-Attention,CC BY-NC-SA 4.0;中文编号与引线为辅助标注。查看未加中文标注的原图。
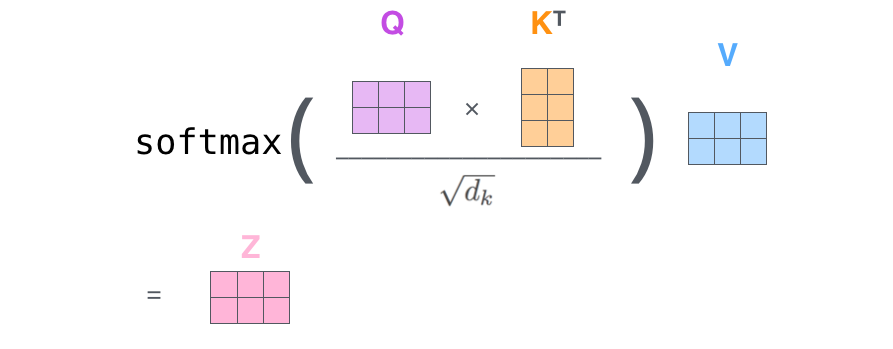
- ① 查询位置与可读位置配对: 紫色 Q 的两行分别对应两个 Query,橙色 Kᵀ 的两列分别对应两个 Key;相乘得到 2×2 分数矩阵。这里“位置 × 位置”说的是配对关系,并不是把位置编号相乘。
- ② 先缩放,再逐行归一化: 除以根号下的头维度后,softmax 在同一 Query 对应的整行上进行,使该行权重之和为 1。图没有画因果 mask,Decoder 要在 softmax 前先屏蔽不允许读取的位置。
- ③ 用权重汇总 Value: 每一行权重乘同一组蓝色 V,得到该 Query 的加权特征;权重矩阵的列必须与 V 的行一一对应。不是把 V 的各列各做一次 softmax。
- ④ 输出仍按位置排列: 粉色 Z 的两行分别属于两个 Query,列则是输出特征。方格只示意维度,不是前文那组二维向量的数值结果。
原图用小方格示意维度,不是本文前面那组二维向量的数值计算;图中的 对应这里每个头的 。它画的是未加掩码的注意力;本文的 Decoder 还要在 softmax 前加入 ,下一节就来看被遮住的位置发生了什么。
位置信息也要加入模型。本文后面的最小实现使用可学习的 position embedding,加到 token embedding 上;RoPE 则是在得到 Q/K 后旋转向量,再计算它们的内积。先理解这里 Q/K 的来源,再读 RoPE 位置编码会更容易。
3.2 因果掩码与 Padding 掩码
先只考虑有效 query:
- Causal mask:位置 只能看到 的 key,包括自己。当前输入 token 已知,而它要预测的是下一个 token,所以允许看自己不会泄漏答案
- Key padding mask:不能把 PAD 位置当作有效 key。在注意力矩阵中,它屏蔽 PAD 对应的列,而 PAD query 对应的行仍需单独处理
本文用 1 / True 表示允许 attention,0 / False 表示禁止。无 padding 时, 的 causal allow-mask 是:
| query \ key | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 1 | 1 | 0 | 0 |
| 2 | 1 | 1 | 1 | 0 |
| 3 | 1 | 1 | 1 | 1 |
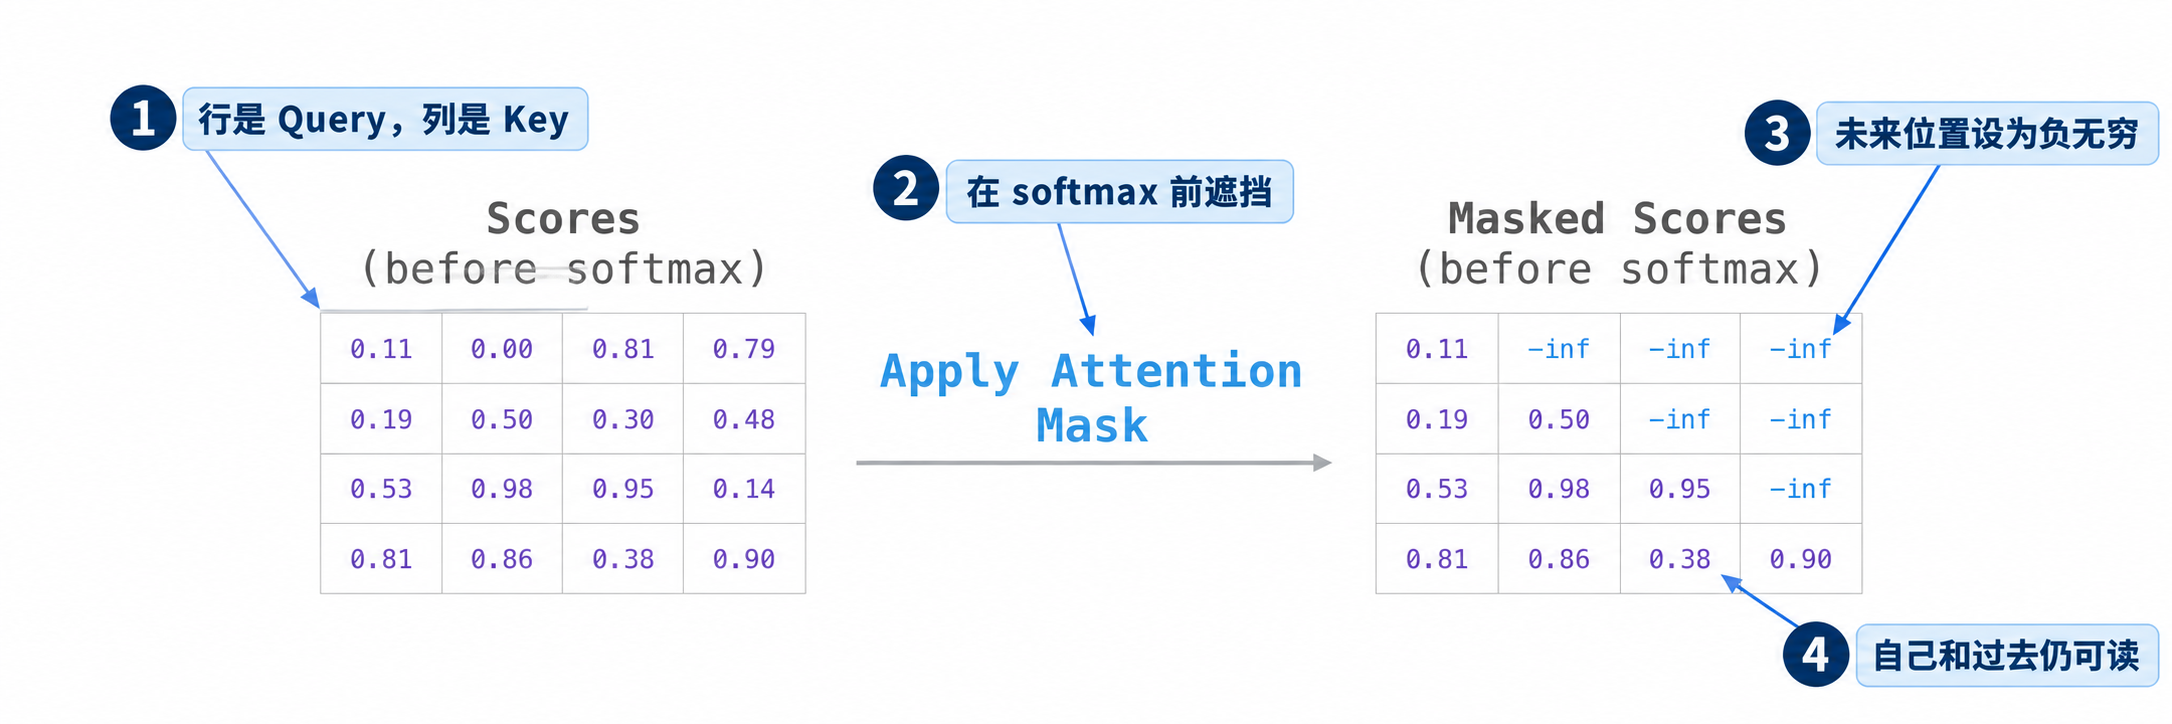
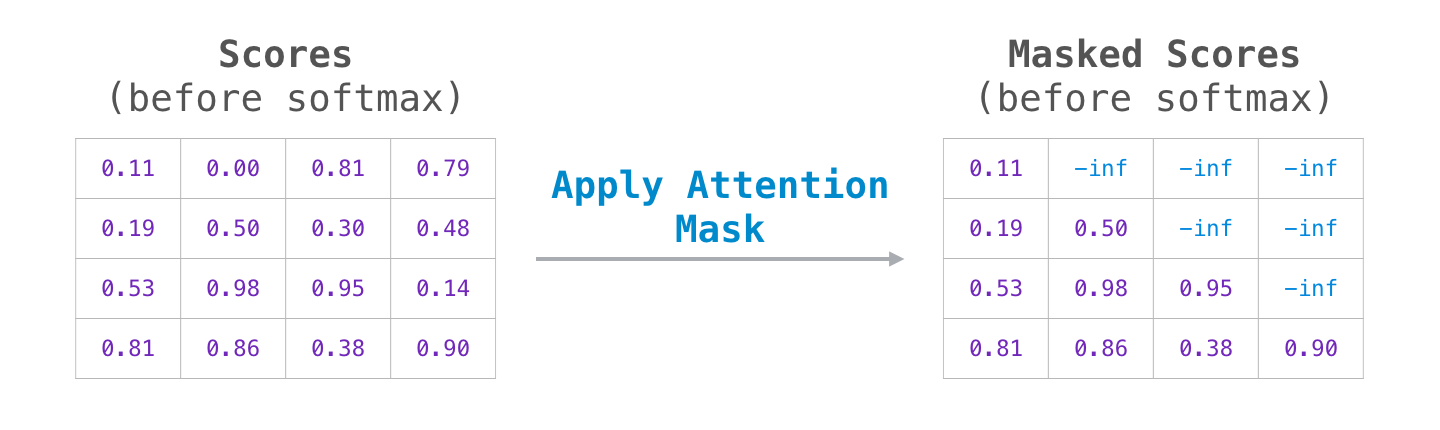
图:在 softmax 之前,把未来位置的 score 设为 −∞,保留当前及更早位置的分数。原图:Jay Alammar,The Illustrated GPT-2,CC BY-NC-SA 4.0;中文编号与引线为辅助标注。 查看未加中文标注的原图。
- ① 行列决定读取方向: 左表每一行是一个 Query,每一列是一个 Key,例如第 2 行第 1 列表示位置 2 读取位置 1 的分数。此时只是 softmax 前的 score,还不是概率。
- ② 遮挡发生在归一化之前: 中间箭头表示应用因果 mask,右表仍是 softmax 前的分数。它不是先得到概率再直接删掉某些数。
- ③ 未来位置不能读取: 右表主对角线上方设为负无穷,随后取指数会变成 0。若这里只写 0 分,取指数却会变成 1,仍可能分到权重。
- ④ 当前与过去保留原分数: 主对角线及下方没有被这张因果 mask 改掉;当前输入已知,而预测目标是下一个 token,所以看自己不泄漏答案。若还有 padding,仍需额外屏蔽 PAD 对应的 Key 列。
使用加性 mask 时,允许看到的位置加 0,禁止看到的位置加 ,再做 softmax。为什么禁止位置不能直接设成 0?因为 ,它仍可能得到正的 attention 权重。将 score 设为负无穷后,softmax 才会给它分配权重 0。
WARNING不同 API 对布尔 mask 的约定相反。PyTorch 的 scaled_dot_product_attention 使用
True = 允许;MultiheadAttention 的布尔attn_mask和key_padding_mask使用True = 屏蔽。移植代码时必须检查约定,不能直接照搬同一个布尔矩阵。
3.3 PAD 这一行全部被屏蔽时怎么办
输入 PAD PAD BOS c a 时,如果只把 causal mask 与非 PAD key 取交集,前两行找不到任何可见 key。一整行 score 都是 ,直接 softmax 可能产生 NaN;不能依赖所有 attention 后端都自动处理这种行。
处理方式如下:
- 有效 query:只允许因果范围内的非 PAD key
- PAD query:整行改为只允许自身位置,为数值计算保留一个有限 score
- attention 计算后:把 PAD query 的输出清零;它的标签也不计入 loss
于是左 padding 的最终 allow-mask 是:
| query \ key | PAD₀ | PAD₁ | BOS | c | a |
|---|---|---|---|---|---|
| PAD₀ | 1 | 0 | 0 | 0 | 0 |
| PAD₁ | 0 | 1 | 0 | 0 | 0 |
| BOS | 0 | 0 | 1 | 0 | 0 |
| c | 0 | 0 | 1 | 1 | 0 |
| a | 0 | 0 | 1 | 1 | 1 |
PAD 的自连接仅为避免全屏蔽行,不表示它有语言意义。有效 query 仍然看不到任何 PAD key。
右 padding 同样要替换整行,不能只在原来的 mask 上补一个对角线。否则右侧 PAD query 仍会看到之前的真实 token。输入 BOS c a PAD₃ PAD₄ 的最终 mask 应是:
| query \ key | BOS | c | a | PAD₃ | PAD₄ |
|---|---|---|---|---|---|
| BOS | 1 | 0 | 0 | 0 | 0 |
| c | 1 | 1 | 0 | 0 | 0 |
| a | 1 | 1 | 1 | 0 | 0 |
| PAD₃ | 0 | 0 | 0 | 1 | 0 |
| PAD₄ | 0 | 0 | 0 | 0 | 1 |
下面直接构造这一规则。输入为 (B, T),返回 (B, 1, T, T) 的 mask,沿 head 维广播:
import torchfrom torch import nnfrom torch.nn import functional as F
def make_safe_allow_mask(token_ids, pad_id): valid = token_ids.ne(pad_id) # (B, T) length = token_ids.shape[1] causal = torch.ones( length, length, dtype=torch.bool, device=token_ids.device ).tril() diagonal = torch.eye(length, dtype=torch.bool, device=token_ids.device) real_rows = valid[:, :, None] & valid[:, None, :] & causal[None, :, :] pad_rows = (~valid[:, :, None]) & diagonal[None, :, :] allowed = real_rows | pad_rows return allowed[:, None, :, :], valid可以用 B=1, T=3, valid=[False, True, True] 对照广播过程。索引中的 None 插入一个长度为 1 的轴:valid[:, :, None] 是 (1,3,1) 的一列,标记哪些 query 行有效;valid[:, None, :] 是 (1,1,3) 的一行,标记哪些 key 列有效。广播把长度为 1 的轴展开,逐元素 &(逻辑与)就得到 (1,3,3),只有第 2、3 行与第 2、3 列的交叉位置有效。再与下三角相交,保留 key 位置不晚于 query 的连接。
.tril() 取包含对角线的下三角;torch.eye() 构造对角线为 1 的单位矩阵。~ 表示逻辑非,| 表示逻辑或,所以无效 query 行只补上自己的对角位置。这个例子的最终三行是 [1,0,0]、[0,1,0]、[0,1,1]。最后插入 head 轴后得到 (1,1,3,3),各注意力头沿用同一组连接规则。
这段逻辑还保证:非空序列的每一行都至少有一个允许位置,全 PAD 序列也不例外。不过全 PAD 样本没有训练价值,仍应从数据中排除。这里避免的只是 mask 将整行屏蔽后产生的 NaN;Q/K/V 本身若已有 NaN 或溢出,需要另行排查。
3.4 把注意力、前馈网络和残差接成模型
一个 Decoder Block 除了 attention,还包含归一化、残差连接和前馈网络。下面列出单层的计算过程:
norm1(hidden):LayerNorm 在每个位置内部,把各特征按均值、方差规范化,再用可学习的缩放和平移调整。它不把不同 token 混在一起。qkv(...)→ attention →out(...):由当前特征产生 Q/K/V,汇总可见位置,再把多头结果投影回原宽度。hidden + attended:残差连接,保留旧特征,再加上这层新算出的更新;两边形状必须相同。ffn(norm2(hidden)):前馈网络(FFN)分别处理每个位置的特征。本文先由 64 维扩到 256 维,经过 GELU 非线性函数,再压回 64 维。它不直接读别的位置,跨位置的信息已经由 attention 传来。- 再做一次残差相加,输出交给下一个 block。
GELU 会非线性地改变每个坐标的数值;若两层线性变换之间没有非线性,它们仍可以合并成一层线性变换。理解这段模型代码时,知道 GELU 提供了非线性变换即可,不必先推导它的具体函数。
“pre-norm”指先做 LayerNorm,再进入 attention 或 FFN;原始 Transformer 论文采用另一种归一化顺序,不能把下面的实现逐项当成原论文复刻。最终的 lm_head 是额外的输出线性层,将每个位置的隐藏向量映射为词表分数。
下面将上述组件组合成一个小型 pre-norm Decoder。d_model 必须能被 num_heads 整除;代码不使用 KV Cache,每次对整个窗口重新计算。
class DecoderBlock(nn.Module): def __init__(self, d_model, num_heads): super().__init__() if d_model % num_heads != 0: raise ValueError('d_model must be divisible by num_heads') self.num_heads = num_heads self.head_dim = d_model // num_heads self.norm1 = nn.LayerNorm(d_model) self.qkv = nn.Linear(d_model, 3 * d_model) self.out = nn.Linear(d_model, d_model) self.norm2 = nn.LayerNorm(d_model) self.ffn = nn.Sequential( nn.Linear(d_model, 4 * d_model), nn.GELU(), nn.Linear(4 * d_model, d_model), )
def forward(self, hidden, allowed, valid): batch, length, width = hidden.shape qkv = self.qkv(self.norm1(hidden)) qkv = qkv.reshape(batch, length, 3, self.num_heads, self.head_dim) q, k, v = qkv.permute(2, 0, 3, 1, 4).unbind(0) attended = F.scaled_dot_product_attention( q, k, v, attn_mask=allowed, dropout_p=0.0, is_causal=False ) attended = attended.transpose(1, 2).reshape(batch, length, width) # Clear after the output projection too, since the projection has a bias. attended = self.out(attended).masked_fill(~valid[:, :, None], 0.0) hidden = hidden + attended hidden = hidden + self.ffn(self.norm2(hidden)) return hidden.masked_fill(~valid[:, :, None], 0.0)
class TinyDecoder(nn.Module): def __init__(self, vocab_size, pad_id, max_length, d_model=64, num_heads=4, num_layers=2): super().__init__() self.pad_id = pad_id self.max_length = max_length self.token_embedding = nn.Embedding(vocab_size, d_model, padding_idx=pad_id) self.position_embedding = nn.Embedding(max_length, d_model) self.blocks = nn.ModuleList([ DecoderBlock(d_model, num_heads) for _ in range(num_layers) ]) self.final_norm = nn.LayerNorm(d_model) self.lm_head = nn.Linear(d_model, vocab_size)
def forward(self, token_ids): if token_ids.ndim != 2 or not 1 <= token_ids.shape[1] <= self.max_length: raise ValueError('Expected (B, T), with 1 <= T <= max_length') allowed, valid = make_safe_allow_mask(token_ids, self.pad_id) # Count real tokens, so left/right padding does not shift their positions. positions = (valid.long().cumsum(dim=1) - 1).clamp_min(0) hidden = self.token_embedding(token_ids) + self.position_embedding(positions) hidden = hidden.masked_fill(~valid[:, :, None], 0.0) for block in self.blocks: hidden = block(hidden, allowed, valid) return self.lm_head(self.final_norm(hidden)) # (B, T, vocab_size), logitsDecoderBlock.forward 中,Q/K/V 的张量形状经过以下几步变化。取 d_model=64、num_heads=4,每个 head 有 16 个数:
hidden (B, T, 64)→ norm1,再经过 qkv 线性层 (B, T, 192)→ reshape(B, T, 3, 4, 16) (B, T, 3, 4, 16)→ permute(2, 0, 3, 1, 4) (3, B, 4, T, 16)→ unbind(0) Q、K、V 各为 (B, 4, T, 16)qkv 线性层一次算出三组投影,192 就是 3 × 64。reshape 把同一批数重新组织成指定维度:这里将最后一维拆成“Q/K/V 三组 × 四个 head × 每头 16 维”。permute 只调整轴顺序,参数按从 0 开始的旧轴编号排列,因此把原来的第 2 轴(Q/K/V)放到最前面。unbind(0) 沿这个长度为 3 的轴拆成三个张量,同时移除该轴,于是分别得到 q, k, v。这三个操作只重新组织数组的形状和维度顺序,不会新增需要训练的参数。
TinyDecoder.forward 的位置编号也可以逐项核对。对于输入 PAD PAD BOS c a,valid.long() 是 [0, 0, 1, 1, 1];cumsum(dim=1) 沿文本位置累计求和,得到 [0, 0, 1, 2, 3];减 1 后是 [-1, -1, 0, 1, 2];clamp_min(0) 把负数截到 0,最终 positions=[0, 0, 0, 1, 2]。前两个 0 只是 PAD 的占位编号,随后对应隐藏状态被清零,且 PAD 不作为有效 key 或训练目标;真正的 BOS、c、a 使用位置 0、1、2。因此增加左侧 PAD 不会挪动真实 token 的位置编号。
这里已经把 causal 条件包含在 allowed 里,所以调用 SDPA 时不再设置 is_causal=True。PAD 输出清零发生在 attention 后及每个完整 block 末尾;残差、LayerNorm 和线性层的偏置都不能代替 query mask。模型最后一层可以在 PAD 位置产生非零 logits,但这些位置不会参与 loss,也不会被选来生成。
为了集中说明 mask,本例没有加入 dropout。如果给 SDPA 添加 dropout,评估时要显式传入 dropout_p=0.0,不能仅依赖 model.eval() 自动关闭这个函数的 dropout。
4. 训练与文本生成
4.1 计算 loss,再更新模型参数
模型输出的是未归一化的 logits,形状为 。每个有效标签都是一个类别 ID。训练损失根据模型给真实下一个字符分配的概率计算。设该概率为 ,单个目标的损失为 。例如真实答案为 a,模型给它 0.5,损失约 0.693;若只给 0.1,损失约 2.303,惩罚更大。对有效目标取平均,就是这里的交叉熵损失。下面将 logits 的前两维展平,再直接传入 cross entropy;这个接口接收未经 softmax 的分数。
def next_token_loss(logits, labels, token_ids, pad_id): labels = labels.masked_fill(token_ids.eq(pad_id), pad_id) count = labels.ne(pad_id).sum() if count.item() == 0: raise ValueError('This batch has no supervised tokens') total = F.cross_entropy( logits.reshape(-1, logits.shape[-1]), labels.reshape(-1), ignore_index=pad_id, reduction='sum', ) return total / count
if not input_rows: raise ValueError('Training text must contain at least one supported character')inputs = torch.tensor(input_rows, dtype=torch.long)labels = torch.tensor(label_rows, dtype=torch.long)model = TinyDecoder(tokenizer.size(), tokenizer.pad_id, max_sequence_length)optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
# One training step; repeat with batches to actually train the model.model.train()optimizer.zero_grad(set_to_none=True)loss = next_token_loss(model(inputs), labels, inputs, tokenizer.pad_id)loss.backward()optimizer.step()代码中的一次训练更新分四步:zero_grad 清除上一步累计的梯度;前向计算得到 loss;loss.backward() 计算损失对各参数的导数,指出每个参数变化会怎样影响损失;optimizer.step() 按优化器规则更新参数。一次更新通常不够,要重复读取训练数据并更新,模型才可能学到续写规律。后面的生成函数可以在更新后调用,但单步训练的输出大多没有可读性。
loss 的分母是实际参与训练的目标 token 数,不是 B × T。ignore_index 忽略的是指定标签位置,不会从其他位置的 softmax 分母中移除 PAD 这个词表类别;有效位置仍在完整 41 类上训练。这一行为见 PyTorch CrossEntropyLoss。
训练和评估都可能计算目标 token 的负对数概率,但用途不同:这里用训练数据上的 loss 更新参数;评估时通常固定模型,用未参与训练的数据衡量表现。同一批有效目标的平均负对数损失取指数,可以得到对应的困惑度,具体计算和比较条件见困惑度。对指令数据,还要决定 prompt 和回答哪些位置参与 loss,见 SFT 的标签与掩码。
这里要做三件事:用 attention mask 挡住 PAD key,把 PAD query 的输出清零,计算 loss 时跳过无效标签。三者分别控制读哪些位置、保留哪些输出、训练哪些预测,不能互相代替。
4.2 从一次预测到自回归生成
给定提示词 cat,假设输入窗口最大长度为 5,过程如下。表中“选出的字符”只用于演示循环,不代表模型实际会生成这些字符:
| 步骤 | 送入模型的 token | 读取哪个位置的 logits | 假设选出的字符 |
|---|---|---|---|
| 1 | PAD BOS c a t | 最后一个有效位置 t | s |
| 2 | BOS c a t s | s | 空格 |
| 3 | c a t s 空格 | 空格 | r |
一次前向计算会得到每个位置的 logits,但续写时只用最后一个有效输入位置的输出。选出 token 后,把它加到末尾,再运行一次模型;窗口满了就丢弃最左边的旧 token。这个例子按窗口内的位置编号,所以窗口滑动后会重新编号,并不代表实现了无限上下文。
下面的原动画展示相同的自回归反馈过程:刚选出的输出,会成为下一轮输入的一部分。
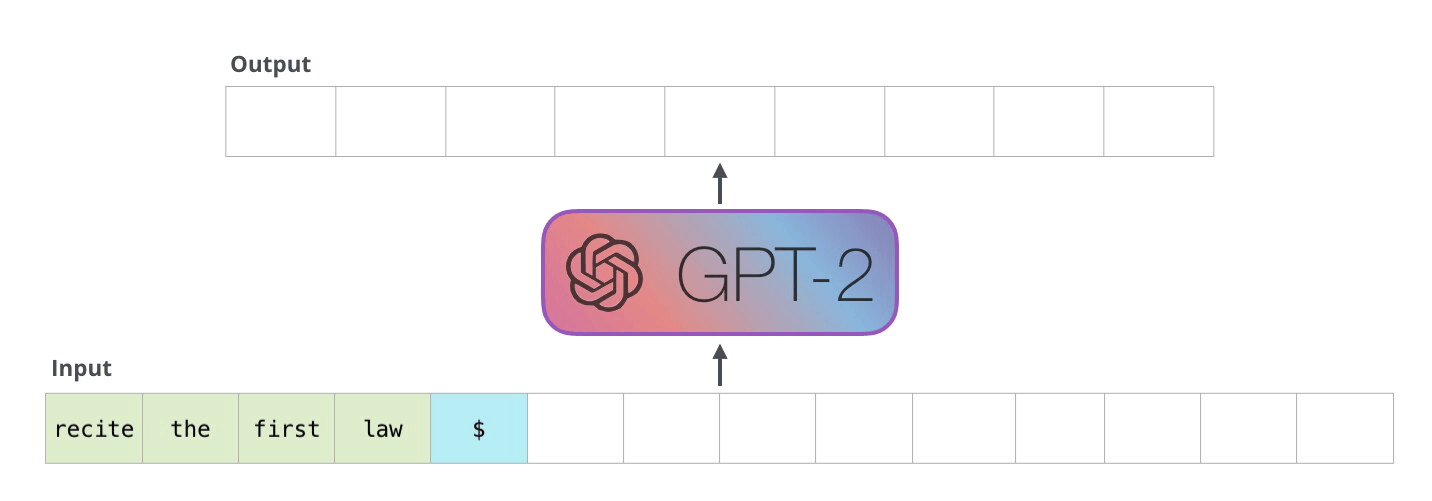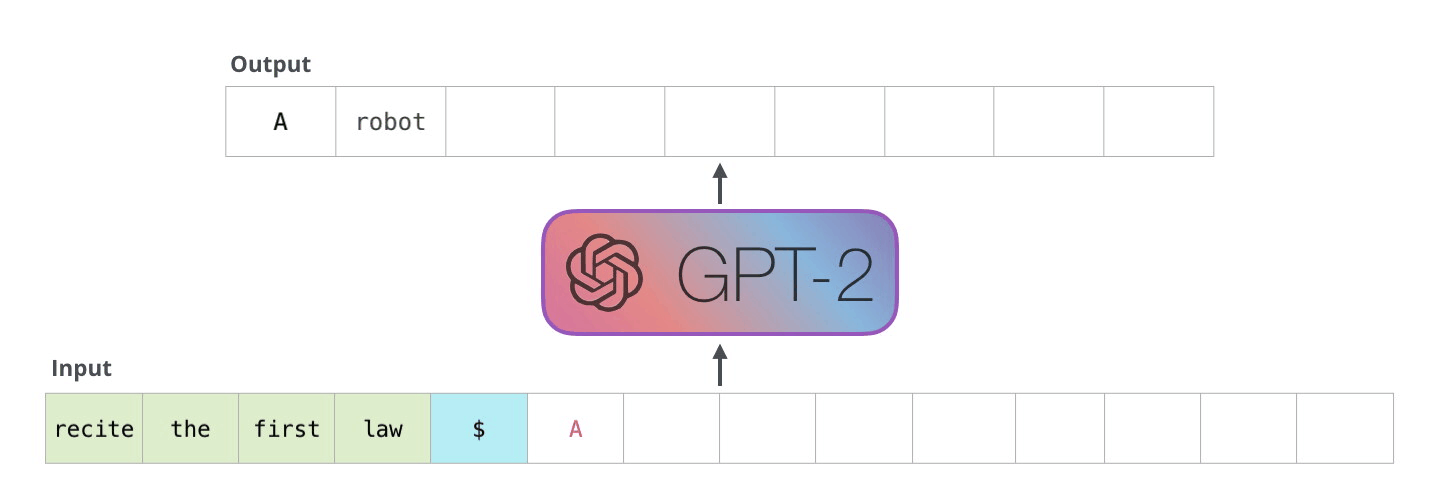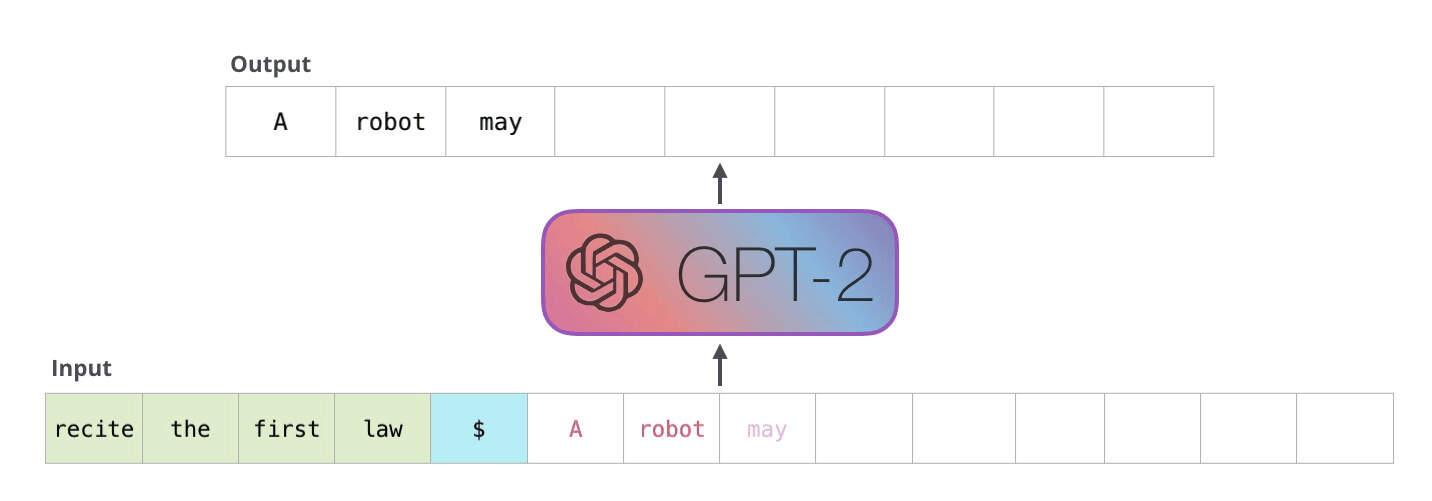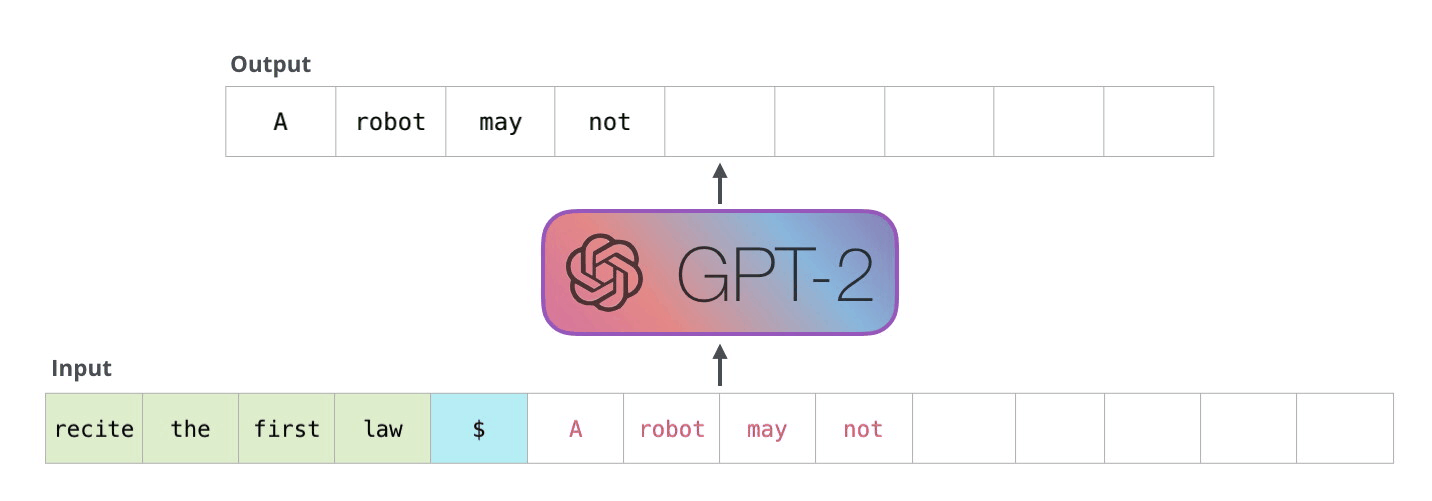
图源:Jay Alammar,The Illustrated GPT-2(原动画,CC BY-NC-SA 4.0,原样引用)。
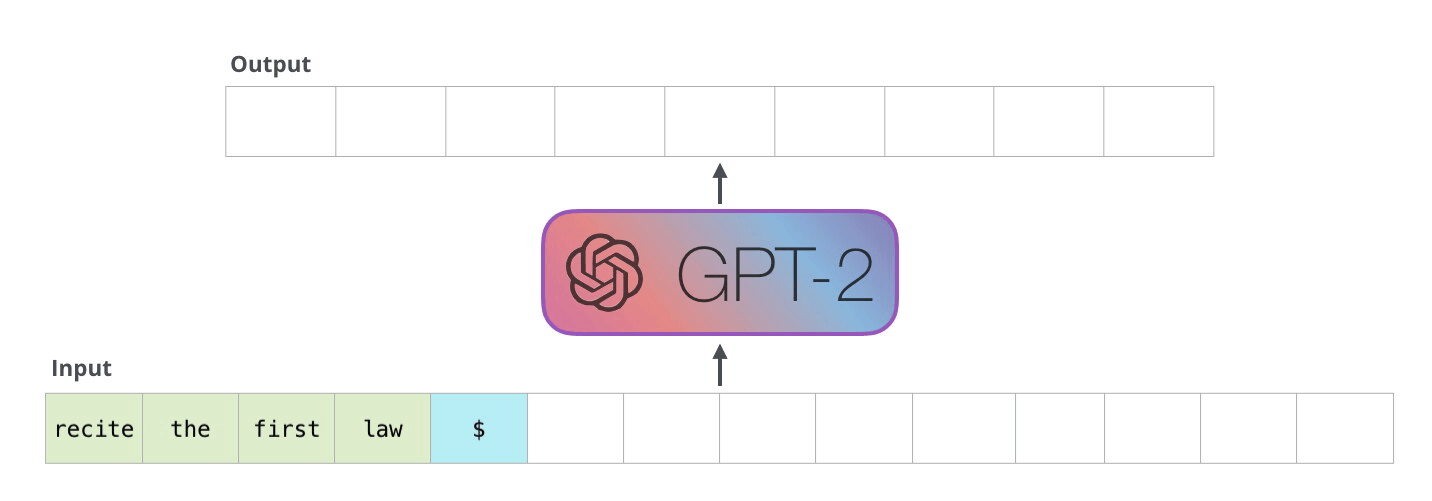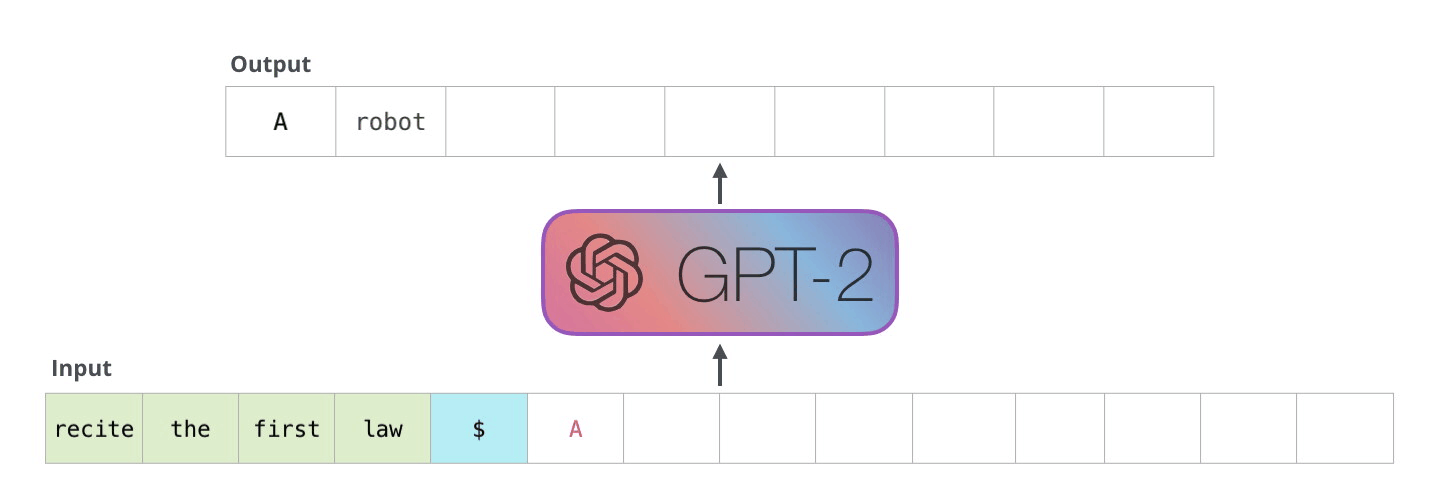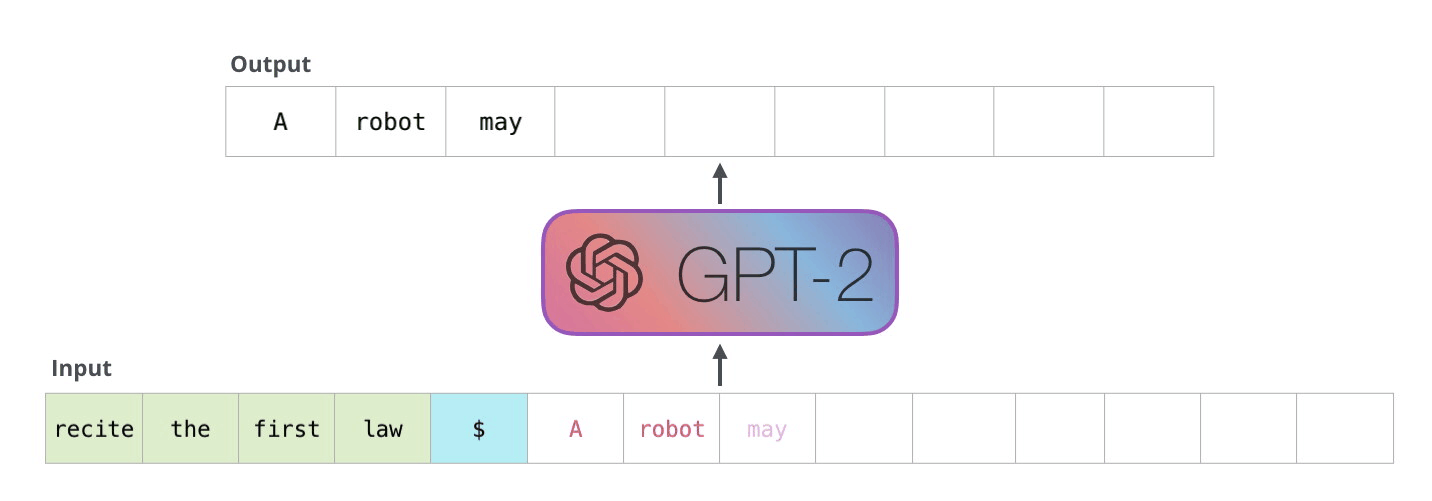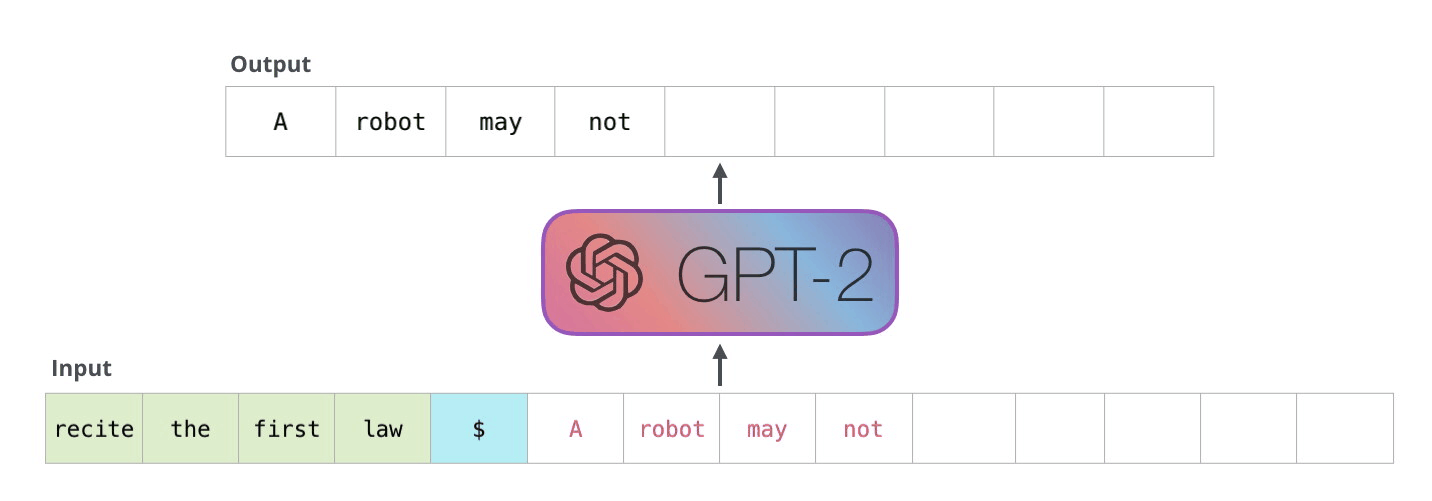
- 底部 Input 是当前已有的前缀。 绿色部分是提示,后面逐渐加入已生成的 token;这一轮预测不能提前读到尚未生成的内容。
- 顶部 Output 每次只增长一步。 图里是一段累积显示的续写,不表示一次前向已经决定整句话。对应本例代码,就是读取最后有效位置,再追加一个字符。
- 回填后才开始下一轮。 图中的
$是作者该示意的分隔标记,不是本文 tokenizer 的 BOS/EOS 定义;图中使用词块简化展示,而本文实现按字符切分。动画也没有表示本文已实现 KV Cache,下面的函数仍会重新计算整个当前窗口。
空提示词也不是全 PAD:窗口最后一位是 BOS,由它预测第一个字符。下面只处理单条提示词,并统一左 padding,因此最后一个有效位置就是 -1。如果改成右 padding 的 batch,不能继续无条件使用 logits[:, -1],要逐条找到最后一个有效位置。
@torch.no_grad()def generate_greedy(model, tokenizer, prompt, max_new_tokens=30): if max_new_tokens < 0: raise ValueError('max_new_tokens must be nonnegative') model.eval() device = next(model.parameters()).device token_ids = [tokenizer.bos_id] + tokenizer.tokenize(prompt) for _ in range(max_new_tokens): context = token_ids[-model.max_length:] context = [tokenizer.pad_id] * (model.max_length - len(context)) + context inputs = torch.tensor([context], dtype=torch.long, device=device) next_logits = model(inputs)[0, -1].clone() # PAD/BOS are not ordinary continuation characters. next_logits[[tokenizer.pad_id, tokenizer.bos_id]] = float('-inf') next_id = int(next_logits.argmax().item()) token_ids.append(next_id) return ''.join(tokenizer.token_to_character(i) for i in token_ids[1:])这里用的是 greedy decoding:选择最高分的 token。对同一组有限 logits,softmax 不改变大小顺序,所以求 argmax 不必先计算概率。这种确定性选择没有随机采样,也不保证整段输出的联合概率最大。
随机采样则需要先将允许生成的 token 的分数归一化为概率,再按该分布抽取;各 token 的抽中机会由概率决定,通常并不相等。两者的区别可参见 Hugging Face 生成策略文档。Temperature、Top-K、Top-P 等留到生成时如何选下一个 token中展开。
定义完函数后,可以调用 print(generate_greedy(model, tokenizer, "cat", max_new_tokens=30)) 查看续写结果。它会保留提示词 cat,再接上 30 个新字符。若此前只执行了一次训练更新,看到不成句的输出是预期现象。要观察学习过程,应重复第 4.1 节的训练更新,并记录 loss;上面的字符表只展示生成步骤,实际续写由训练后的模型决定。
由于这里没有 EOS,函数恰好生成 max_new_tokens 个字符后停止。如果希望模型自己判断何时结束,需要在词表和训练目标中加入 EOS,并在生成时检测它。只在循环中检查一个未经训练的结束标记,无法让模型学会结束生成。
5. 怎样运行示例,还有哪些测试未做
上面的 Python 代码块按顺序组成一个教学示例:纯 Python 的数据构造,加上 PyTorch 的最小模型、单步训练和 greedy 生成函数。一次 optimizer step 只演示怎样完成一次参数更新,不代表模型已经学会语料。
相关实验仓库:Text-Generator-With-Decoder。仓库与本文是两份不同的实现;运行本文示例时,应使用上面完整的数据构造、BOS 和 mask 逻辑,避免混用。
运行模型部分需要安装 PyTorch。本文示例尚未经 PyTorch 前向、反向传播或 GPU 运行测试,也没有生成质量的实测结果。首次运行时,可先用第 2.3 节的短序列检查标签,再对照第 3.3 节的矩阵检查 mask,最后执行训练与生成。
参考资料
- Attention Is All You Need:attention、causal mask 与训练并行性的原始说明
- PyTorch scaled_dot_product_attention:mask 约定、张量形状与 dropout 参数
- PyTorch MultiheadAttention:key padding mask 与布尔屏蔽语义
- PyTorch CrossEntropyLoss:logits、类别标签与 ignore_index
- Hugging Face generation strategies:greedy 与随机采样
- Building a language model:原始实现思路的参考文章
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。