1. 定义#
1.1 离散分布怎么算,概率为零怎么办#
设 P 和 Q 定义在同一个离散样本空间 X 上:
DKL(P∥Q)=x∈X∑P(x)lnQ(x)P(x)=EX∼P[lnQ(X)P(X)].EX∼P 表示按分布 P 加权平均;在离散情形下,就是前一行按各个 P(x) 加权的求和。
定义中的零概率项按以下规则处理:[1]
- 若 P(x)=0,这一项按约定取 0,包括 P(x)=Q(x)=0 的情况;可以直接只对 P(x)>0 的位置求和
- 若 P(x)>0 但 Q(x)=0,则 DKL(P∥Q)=+∞:真实可能发生的结果,被预测模型判定为绝不可能
因此,KL 要有有限值,Q 就必须覆盖 P 中所有概率为正的位置。对于有限样本空间,这个条件已经足够;对于无限样本空间,即使这些位置的 Q(x) 都大于 0,求和仍可能发散。
例如,P=(1,0)、Q=(1/2,1/2) 时,DKL(P∥Q)=ln2,但反过来的 KL 是 +∞。方向不仅影响大小,还可能影响是否有限。
1.2 连续分布怎么计算 KL#
若 P,Q 相对于同一坐标空间上的体积元素都有密度 p,q,定义为:
DKL(P∥Q)=∫p(x)lnq(x)p(x)dx.这里的 p(x),q(x) 是密度,不是单点概率。判断 Q 是否遗漏了在 P 下可能发生的结果,需要比较集合上的概率,单个点的密度为 0 并不足以说明问题。
严格地说,这个条件是:对于任意可测集合 A,只要 Q(A)=0,就有 P(A)=0。这称为 P 对 Q 绝对连续,记为 P≪Q。如果这个条件不成立,KL 为 +∞;条件成立也不保证积分一定有限。
2. KL 为什么非负,却不能当作距离#
2.1 为什么 KL 不小于零#
KL 满足:
DKL(P∥Q)≥0,DKL(P∥Q)=0⟺P=Q.离散情形的 P=Q 表示每个位置的概率都相同;密度形式中表示 p=q 几乎处处,即允许在零测集上不同,但它们仍定义同一个概率分布。[1]
可以先把 Jensen 不等式理解为:对凸函数,“先算函数再加权平均”不小于“先加权平均再算函数”。下面在有限离散空间上证明。令 S={x:P(x)>0};先假设 Q(x)>0 对所有 x∈S 成立。由于 −ln 是严格凸函数,使用 Jensen 不等式:
DKL(P∥Q)=x∈S∑P(x)[−lnP(x)Q(x)]≥−ln(x∈S∑P(x)P(x)Q(x))=−ln(x∈S∑Q(x))≥0.这里每一项都要乘上 P(x),因为我们求的是按 P 加权的平均。若某处 P(x)>0 而 Q(x)=0,KL 为 +∞,非负性仍成立。
若最后等于 0,上述两个不等式必须同时取等号:第一步要求 Q(x)/P(x) 在 S 上为常数,第二步要求 ∑x∈SQ(x)=1。两者合起来得到常数为 1,且 Q 在 S 外没有概率质量,所以 P=Q。反过来,把 P=Q 代入定义自然得到 0。
2.2 不对称#
取 P=(0.1,0.9)、Q=(0.2,0.8):
DKL(P∥Q)≈0.036690,DKL(Q∥P)≈0.044403.两个方向的结果不同,所以 KL 不满足对称性。当然,有些特殊的 P,Q 可能恰好算出相同的数。
2.3 不满足三角不等式#
仍取上面的 P,Q,再令 R=(0.3,0.7)。直接计算可得:
DKL(P∥R)DKL(P∥Q)+DKL(Q∥R)≈0.116322,≈0.036690+0.025732≈0.062422.左边大于右边,所以三角不等式在这个例子中不成立。因此 KL 可以衡量分布差异,但不是数学意义上的距离。
3. 与熵、交叉熵和互信息的关系#
3.1 固定真实分布时,交叉熵与 KL 的优化关系#
对离散分布,熵和交叉熵分别为:
H(P)=−x∑P(x)lnP(x),H(P,Q)=−x∑P(x)lnQ(x).在这些量有限时,展开定义得到:
DKL(P∥Q)=x∑P(x)lnP(x)−x∑P(x)lnQ(x)=H(P,Q)−H(P).如果真实分布 P 固定,只调整模型 Q,H(P) 就是不随模型参数变化的常数。因此最小化交叉熵,等价于最小化这个方向的 KL。实践中通常用数据样本的平均负对数似然估计交叉熵:若 x1,…,xn 来自固定的 P,就最小化 −n1∑ilnQ(xi)。分类时对每个输入有一个类别分布,真实标签 yi 对应的单样本损失便是 −lnQ(yi∣xi);其他类别的 one-hot 权重为 0。
这里有一个前提:真实分布 P 固定不变。如果 P 也随待优化参数变化,H(P) 就需要参与优化。在无限或连续空间中,还要检查各项是否有定义,避免出现“无穷减无穷”;连续情形使用微分熵,并要求相应积分和差值有意义。
NOTE如果想先理解熵为什么采用负对数,可以看我在 B站 的介绍视频。语言模型中的交叉熵与困惑度,可接着阅读 Perplexity。
3.2 用 KL 散度表示互信息#
互信息衡量知道 X 后,Y 的不确定性平均减少了多少。它可以写成实际联合分布 PXY 与边缘分布乘积 PXPY 之间的 KL。后一个分布保留 X、Y 各自的分布,但让两者相互独立。[1]
在有限离散情形下,p(x,y)=P(X=x,Y=y) 是两个变量同时取相应值的联合概率。对另一个变量的所有可能取值,将对应的联合概率相加,就得到边缘概率:p(x)=∑yp(x,y)、p(y)=∑xp(x,y)。当 p(x)>0 时,条件概率为 p(y∣x)=p(x,y)/p(x),因此下面第三行可以约去分子、分母中的 p(x):
I(X;Y)=DKL(PXY∥PXPY)=x,y∑p(x,y)lnp(x)p(y)p(x,y)=x,y∑p(x,y)lnp(y)p(y∣x)=H(Y)−H(Y∣X).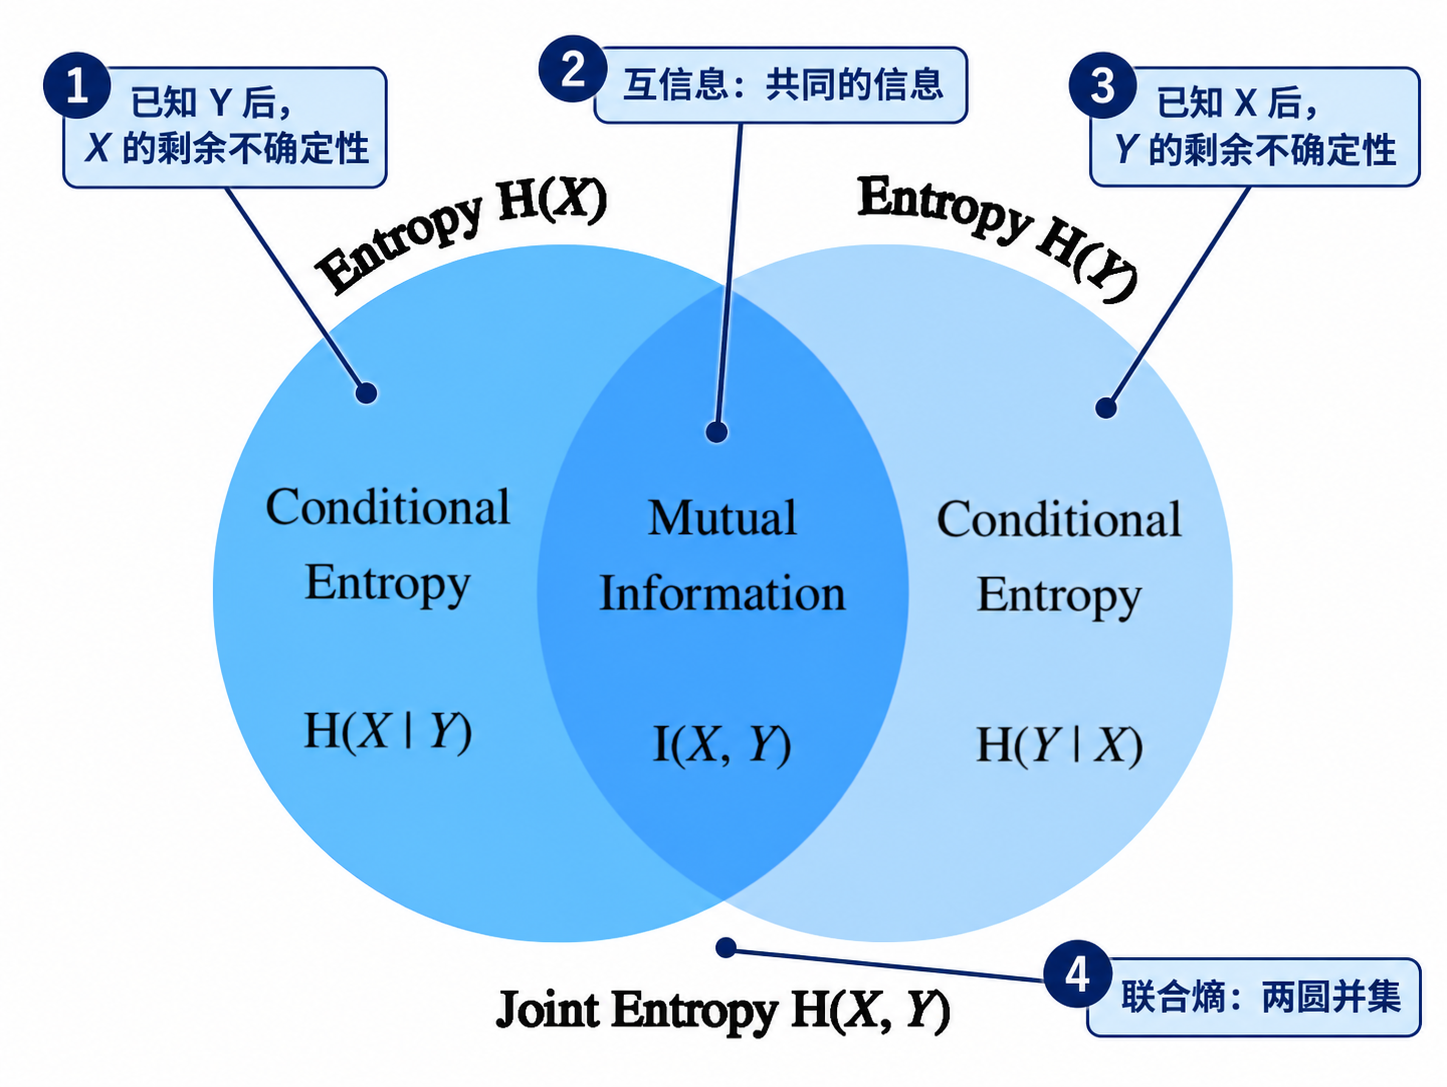
两个圆分别表示 H(X) 和 H(Y),按图中编号读:
- ①左圆不重叠的部分是 H(X∣Y):已经知道右侧变量后,左侧变量仍然保留的不确定性。
- ②重叠部分对应 I(X;Y)=H(Y)−H(Y∣X)。知道一个变量后,另一个变量减少了多少不确定性,就用互信息衡量;图中的逗号与正文分号是同一量的两种记法。
- ③右圆扣掉重叠部分,剩下的就是知道 X 后仍不知道的 H(Y∣X)。左右两侧条件熵不能互换,一般也不相等。
- ④两个圆覆盖的总量是联合熵 H(X,Y)。这里取两圆并集,重叠部分只算一次,而不是把两个圆直接相加。
这张图表示两个离散变量的信息量关系,不是概率事件的面积图,也不能直接套用到连续变量的微分熵。圆的面积没有按本文某组数据计算,任意两个分布之间的 KL 也不能都理解成这块重叠区域。原图:《Dive into Deep Learning》Information Theory,Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola,CC BY-SA 4.0。此版本添加中文辅助标注,标注版同样采用 CC BY-SA 4.0;查看原始图片。
条件熵 H(Y∣X) 是在不同 X 取值下的熵再求平均。根据 KL 取零的条件:
I(X;Y)=0⟺PXY=PXPY⟺X 与 Y 独立.只有比较联合分布与其边缘分布乘积时,这个 KL 才等于相应变量的互信息。对于任意两个分布,减小 DKL(P∥Q) 并不表示两个变量变得更独立,也不只是让两个熵的数值接近:熵相同的分布之间,KL 仍然可能很大。
用两个二元变量算一个例子:令 X 等概率取 0、1,并且每次都有 Y=X。真实联合分布只有 (0,0) 和 (1,1) 两种结果,各占 1/2;而保留相同边缘分布、让两者独立后,四种组合各占 1/4。因此互信息是 21ln[(1/2)/(1/4)]+21ln[(1/2)/(1/4)]=ln2 nat。知道 X 后就知道 Y,恰好减少了 ln2 nat 的不确定性。如果改成两者独立且各自仍等概率取 0、1,联合分布就等于边缘分布的乘积,互信息为 0。
4. 两个多元高斯分布之间的 KL#
下面的推导会用到矩阵乘法、协方差、期望的线性性质和积分。首次阅读可先看下面的一维公式和第 4.3 节的数值例子,暂时跳过矩阵推导。
高斯分布之间的差异来自均值和协方差。均值不同意味着分布中心偏移;协方差不同意味着各方向的伸展程度不同。下面分别计算这两部分对 KL 的影响。
设:
P=N(μp,Σp),Q=N(μq,Σq),这里 k 是变量维数,Rk 表示含 k 个实数的向量空间。μp,μq∈Rk 为均值列向量,Σp,Σq∈Rk×k 均为对称正定矩阵。正定条件保证逆矩阵与正的行列式存在;以下密度和公式不能直接套在奇异协方差上。
若矩阵记号不熟,可以先看一维版本,其中 σp2,σq2>0 是方差:
DKL(P∥Q)=21[lnσp2σq2−1+σq2σp2+σq2(μp−μq)2].最后一项衡量均值偏移,前几项衡量分布宽度的差异。下面的矩阵推导就是把这个式子推广到多个变量。
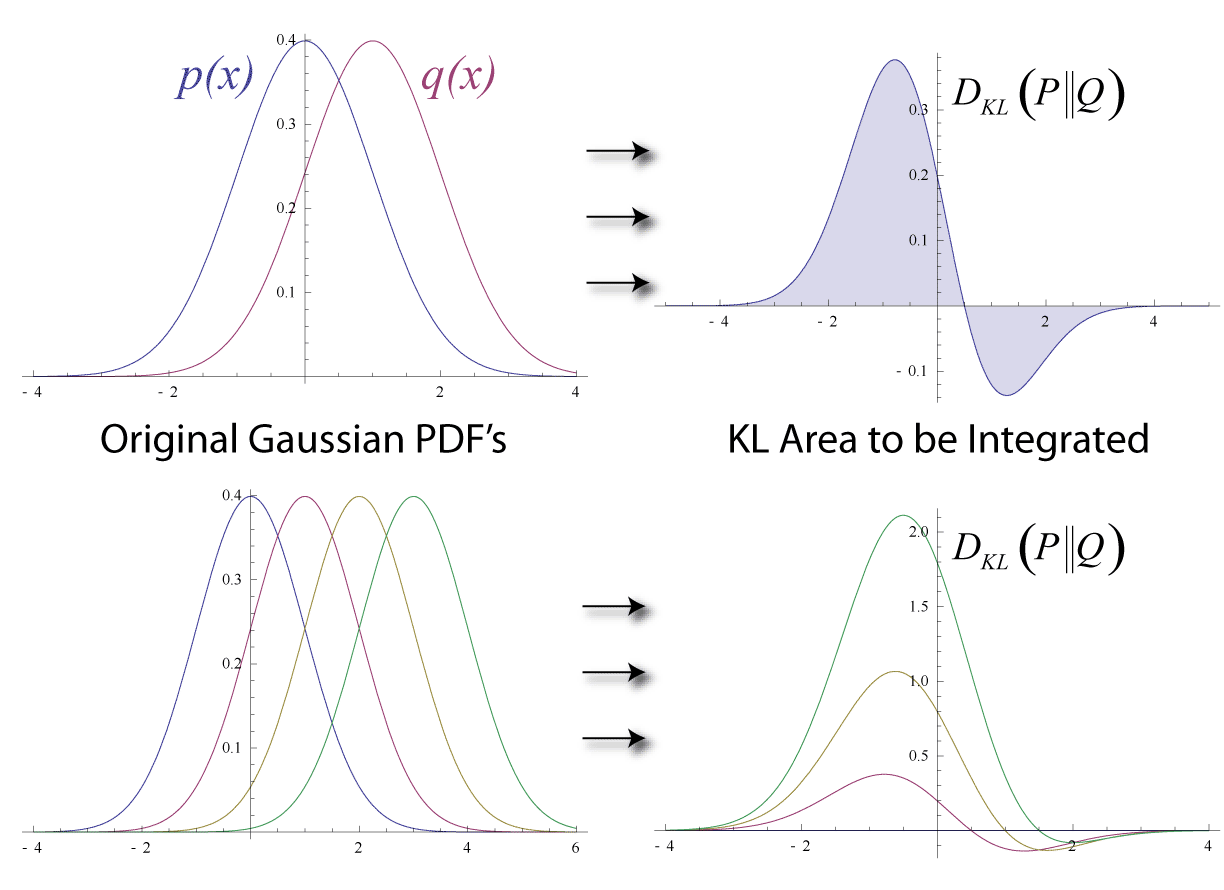
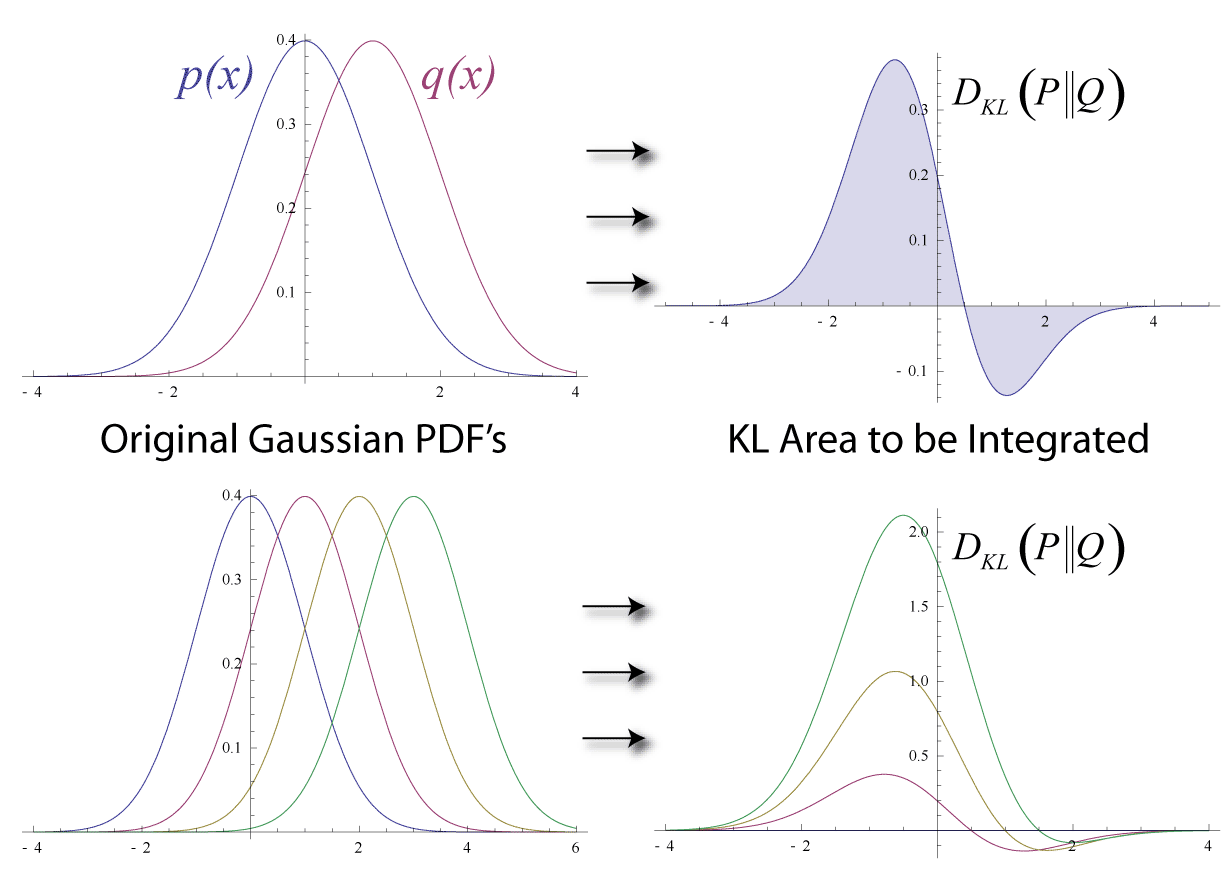
先按“左图 → 右图”的方向读。左上蓝线是 p(x),紫线是 q(x);右上画的是 p(x)ln[p(x)/q(x)],不是第三个概率密度,也不是 KL 随 x 变化的取值。p(x)>q(x) 的地方贡献为正,p(x)<q(x) 的地方贡献为负,最后把整个实数轴上的有符号贡献积分,才得到一个非负的 KL 数值。不要把两条密度曲线之间的几何面积当成 KL。
下面一行固定蓝色分布,逐步把另一条同方差高斯分布的均值移远,右边的总积分随之增大。同方差时,KL 恰好等于均值差的平方除以两倍方差,两个方向在这个特殊情形下相等;因此这张图用于理解高斯计算与积分,不能拿来证明一般的不对称性。
原图未改动:T. Nathan Mundhenk,博士论文附录 C,经作者上传 Wikimedia Commons,采用 CC BY-SA 3.0;原图链接。
4.1 展开高斯分布的对数密度#
记号 ∣Σ∣ 是行列式,不是逐元素绝对值;Σ−1 是逆矩阵;上标 T 是转置。(x−μ)TΣ−1(x−μ) 是一个标量,称为二次型,在一维时就是 (x−μ)2/σ2。
P 的密度为:
p(x)=(2π)k/2∣Σp∣1/21exp[−21(x−μp)TΣp−1(x−μp)].把两个对数密度相减,再对 X∼P 求期望:
DKL(P∥Q)=21ln∣Σp∣∣Σq∣−21EP[(X−μp)TΣp−1(X−μp)]+21EP[(X−μq)TΣq−1(X−μq)].这两个二次型都按 P 求期望,因为 KL 定义中的观测来自 P,最后一项也沿用这个分布。
4.2 怎样计算二次型的期望?#
先考虑一个更通用的式子。设 A 是固定的 k×k 矩阵,a 是固定向量。令 δ=μp−a,把 X−a 拆成 (X−μp)+δ。
因为 EP[X−μp]=0,展开后二次型的交叉项期望为 0,剩下:
EP[(X−a)TA(X−a)]=tr(AΣp)+(μp−a)TA(μp−a).其中 tr 表示矩阵对角线元素之和。协方差项的推导是:
EP[(X−μp)TA(X−μp)]=tr(AEP[(X−μp)(X−μp)T])=tr(AΣp).中间一步使用了 zTAz=tr(AzzT):两边展开后都是 ∑i,jAijzizj。再把期望移进各矩阵元素,E[zzT]=Σp,就得到最后一行。
这个恒等式只需要均值和协方差存在,不依赖高斯假设。分别代入 A=Σp−1,a=μp 和 A=Σq−1,a=μq,得到:
EP[(X−μp)TΣp−1(X−μp)]EP[(X−μq)TΣq−1(X−μq)]=k,=tr(Σq−1Σp)+(μp−μq)TΣq−1(μp−μq).第一项为什么是 k?因为 Σp−1Σp=Ik,Ik 是对角线上有 k 个 1 的单位矩阵,所以其迹为 k。
4.3 合并结果,代入一个例子#
合并上述各项:[2]
DKL(P∥Q)=21[ln∣Σp∣∣Σq∣−k+tr(Σq−1Σp)+(μp−μq)TΣq−1(μp−μq)].先代入几种简单情况,检查这个公式:
- 当 P=Q,行列式比为 1,迹为 k,均值差为 0,所以 KL 为 0
- 当 Σp=Σq=Σ,只剩 21(μp−μq)TΣ−1(μp−μq)
- 当 Q=N(0,Ik),公式简化为
DKL(P∥Q)=21[μpTμp+tr(Σp)−k−ln∣Σp∣].例如 P=N(1,4)、Q=N(0,1),第二个参数表示方差:
DKL(P∥Q)=21(1+4−1−ln4)≈1.306853.
4.4 顺便算出高斯分布的微分熵#
上面的 k 是平方偏差经过协方差逆矩阵加权后的期望。它只是计算熵的一部分,不等于高斯分布的熵;还要保留密度中的归一化常数,才能得到微分熵:[1]
h(P)=−EP[lnp(X)]=2kln(2π)+21ln∣Σp∣+2k=21ln((2πe)k∣Σp∣).微分熵可能为负,也会随坐标单位改变,因此它与离散熵的性质并不完全相同。KL 散度则仍满足非负性。