0. 有了 L2 正则化,为什么还需要 AdamW#
在 L1 与 L2 正则化 中,我们把普通梯度下降中的 L2 梯度拆成了一个权重缩小项。既然如此,为什么还需要 AdamW?
关键在于优化器怎样处理这部分更新。L2 正则化把额外的梯度加到数据梯度上;解耦权重衰减(decoupled Weight Decay)则直接缩小参数,不让衰减量参与动量和自适应二阶矩的计算。对于普通 SGD,两种做法可以等价;使用 momentum 或 Adam 时,一般会得到不同结果。AdamW 原论文
1. 先说清梯度、学习率和衰减系数#
令 θt−1∈Rd 是第 t 次更新前的参数向量:d 是参数个数,θ 是这些参数排成的向量,θj 表示第 j 个参数。ft 是当前 batch 的数据损失:
gt=∇ft(θt−1),t=1,2,…这里 ∇ft 是对每个参数求偏导后组成的梯度向量,指出数据损失局部增加最快的方向;优化器沿负方向更新。batch 是本次计算梯度使用的一小批训练数据,t 表示更新次数。学习率为 ηt>0。
平方范数 ∥θ∥22=∑j=1dθj2,就是把所有参数的平方相加。本文区分两个系数:
- L2 系数 λ2≥0:损失增加 (λ2/2)∥θ∥22,梯度增加 λ2θ
- 解耦衰减系数 λd≥0:每步对旧参数乘 1−ηtλd
上一篇的 L2 项写作 λ∥w∥22,所以对应这里的 λ2=2λ。另一些论文把每步衰减因子直接写成 1−dt,那就令 dt=ηtλd。比较实现时,需要按这些定义换算系数,不能只比较同名超参数的数值。
本文与 PyTorch AdamW 文档采用相同约定:每步的衰减量为 ηtλdθt−1,其中包含学习率 ηt。通常令 0≤ηtλd<1,以免衰减步骤将参数翻转符号。PyTorch AdamW 算法定义
2. 普通 SGD 中,两种做法什么时候相同#
2.1 损失函数加入 L2 正则项#
θt=θt−1−ηt(gt+λ2θt−1)=(1−ηtλ2)θt−1−ηtgt.
2.2 直接衰减参数#
θt=(1−ηtλd)θt−1−ηtgt.在相同初始参数、batch 顺序和学习率下,取 λd=λ2,两种算法每一步都会得到相同的参数。这个结论针对不带 momentum、不做自适应缩放的 SGD;两边也不能额外采用不同的梯度处理,例如只在一边对加入 L2 后的总梯度做 clipping。
若改用“每步都乘以固定因子 1−d”的定义,匹配条件是 d=ηtλ2。学习率变化时,固定 d 通常不能再对应固定的 λ2。等价条件允许学习率变化,但不同定义下的衰减系数需要随学习率调度一同换算。
3. 动量会累积 L2 正则项的梯度#
momentum(动量)在缓存中保留历史梯度,并将它们与当前梯度合并,因此每次更新都受到之前 batch 的影响。mt 是这个缓存,β 控制保留多少历史;β=0 时就不保留。使用不带 dampening(对新梯度的额外衰减)、不开 Nesterov 的一个常见 momentum 约定,0≤β<1,初始缓存为 0。
L2 进入梯度及缓存:
mtL2θtL2=βmt−1L2+gtL2+λ2θt−1L2,=θt−1L2−ηtmtL2.解耦衰减只修改参数:
mtWDθtWD=βmt−1WD+gtWD,=(1−ηtλd)θt−1WD−ηtmtWD.这里 gtL2=∇ft(θt−1L2),gtWD=∇ft(θt−1WD)。两种算法一旦得到不同参数,随后在这些参数上算出的数据梯度也可能不同。
3.1 算两步,看看差别出在哪里#
设只有一个参数,初值 θ0=1,数据损失恒定,因此每步数据梯度为 0。取 η=0.1、β=0.9、λ2=λd=0.1:
| 更新 | L2 + momentum | 解耦 Weight Decay + momentum |
|---|
| 第 1 步缓存 | m1=0.1 | m1=0 |
| 第 1 步参数 | θ1=0.99 | θ1=0.99 |
| 第 2 步缓存 | m2=0.9(0.1)+0.1(0.99)=0.189 | m2=0 |
| 第 2 步参数 | θ2=0.99−0.1(0.189)=0.9711 | θ2=0.992=0.9801 |
两个系数已经按第一步的结果匹配,第二步却仍然不同,因为 L2 的旧梯度还留在缓存中。换一种含 1−β 的 momentum 定义会改变系数换算,但不会消除缓存历史的区别。
4. 自适应优化器如何缩放 L2 梯度#
自适应优化器可以对不同参数使用不同的更新尺度。例如某个参数过去的梯度很大,优化器就可能把它当前的梯度缩小一些。先暂时不考虑 momentum,用一个给定的矩阵 Mt∈Rd×d 表示梯度缩放。比较:
θtL2θtWD=θt−1−ηtMtgt−ηtλ2Mtθt−1,=θt−1−ηtMtgt−ηtλdθt−1.如果要求对所有参数向量都相等,必须有:
λdId=λ2Mt.这里 Id 是 d×d 单位矩阵:对角线全为 1,其他位置全为 0,乘一个向量后向量保持不变。左边的系数要乘单位矩阵,才能与右边的缩放矩阵比较。对于非零正则强度,如果 Mt 各坐标缩放不同,就不存在一个标量 λ2 同时满足所有坐标;即使每步 Mt=ctId,当 ct 随时间变化时,也通常无法用两个固定系数匹配整条轨迹。
diag(1,10) 表示对角线为 1、10,其他位置为 0 的对角矩阵;它把向量的第一个坐标乘 1、第二个坐标乘 10。
例如 Mt=diag(1,10)、θ=(1,1)、ηt=0.1、λ2=λd=0.1,仅看正则部分,L2 产生的减量是 (0.01,0.1),解耦衰减产生的减量是 (0.01,0.01)。
对某个特殊向量、某个时间点,两者仍可能偶然相同;零衰减时也没有这一区别。因此准确结论是“通常不存在统一的标量系数使两种算法等价”,而不是任何情况下都必然不等。AdamW 原论文,Appendix A
这个矩阵例子说明了坐标缩放会带来什么影响,但它不是完整的 Adam 更新式。在 Adam 中,加入 L2 还会改变用于计算缩放的历史状态,因此不能假设两种算法使用同一个 Mt。
5. Adam 与 AdamW 的完整更新公式#
Adam 同时维护两个历史量:mt 是梯度的指数移动平均,用来平滑方向;vt 是梯度平方的指数移动平均,用来估计各坐标的尺度。β1,β2 分别控制保留多少旧值。以下考虑最小化目标、不使用 AMSGrad 变体的版本。初始化 m0=v0=0,β1,β2∈[0,1)、ϵ>0。平方、平方根和除法都按坐标进行;例如 (a,b)⊙2=(a2,b2),ϵ 是避免分母为零的小正数。
因为缓存从 0 开始,初期的移动平均偏小,所以要做“偏差修正”:除以 1−β1t 或 1−β2t。例如第一步 m1=(1−β1)g1,修正后 m^1=g1;帽子表示修正后的量。
5.1 Adam + L2:把正则梯度一起存进历史状态#
g~tmtvtm^tθt=∇ft(θt−1)+λ2θt−1,=β1mt−1+(1−β1)g~t,=β2vt−1+(1−β2)g~t⊙2,=1−β1tmt,v^t=1−β2tvt,=θt−1−ηtv^t+ϵm^t.
5.2 AdamW:历史状态只记录数据梯度,参数单独衰减#
gtmtvtm^tθt=∇ft(θt−1),=β1mt−1+(1−β1)gt,=β2vt−1+(1−β2)gt⊙2,=1−β1tmt,v^t=1−β2tvt,=(1−ηtλd)θt−1−ηtv^t+ϵm^t.上面两组公式中的状态分别由各自算法维护,不是同一组 mt,vt。Adam 的矩估计和偏差修正见 Kingma and Ba, Adam;解耦衰减的实现约定见 PyTorch AdamW。
同一步中的梯度在旧参数 θt−1 上计算,衰减项也乘旧参数。如果先完成整个 Adam 更新,再将整个结果乘衰减因子,梯度更新项也会被缩放,不是上面这条更新式。
下面直接对照原论文的双色算法框。它把两种算法写在一起,紫色项与绿色项二选一,不是把两处正则项都执行。
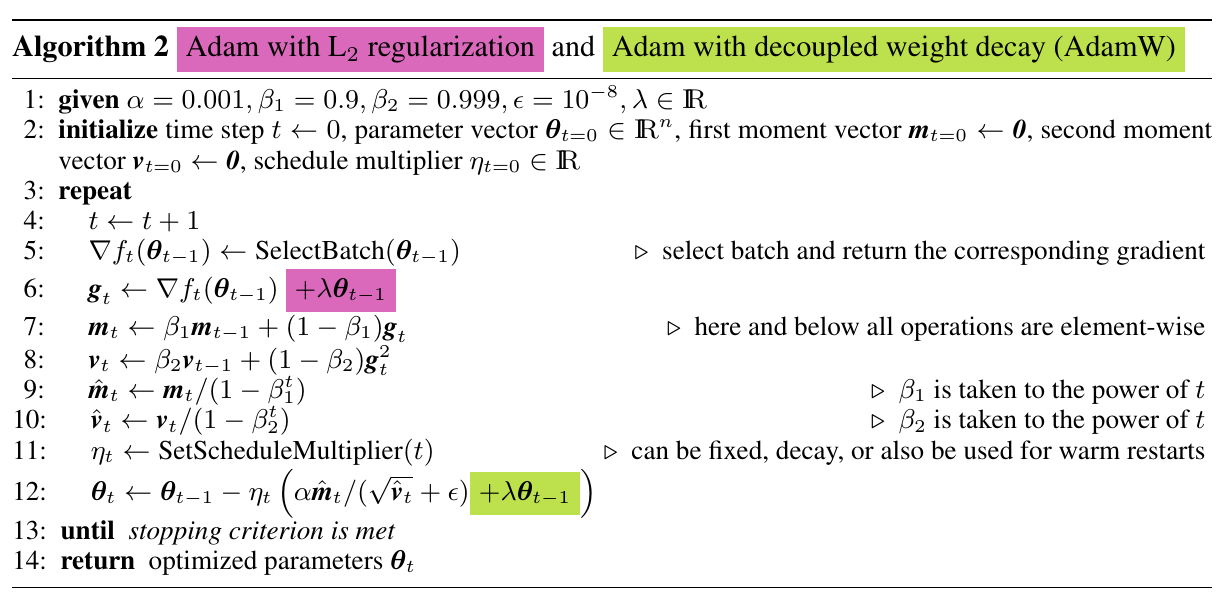
- 第 6 行紫色项:Adam + L2 先把正则梯度加进 gt,所以第 7、8 行的一阶矩和二阶矩都会受到它影响。
- 第 12 行绿色项:AdamW 不执行第 6 行的紫色加项;它完成矩估计后,直接对旧参数施加衰减,绕开自适应分母。
- 原图中,α 是基础学习率,ηt 只是调度乘子;二者的乘积,才对应本文的学习率 ηt。
- 原图紫色 L2 项的 λ 对应本文的 λ2;绿色衰减项的 λ 则对应“原图的 α 乘本文的 λd”。两种系数要分别换算,不能把同名字母的数值直接套用。
图源:Loshchilov、Hutter,Decoupled Weight Decay Regularization,Algorithm 2。从论文第 3 页提取完整算法框,未改动公式、行号和双色高亮;版权归原作者,arXiv 页面未声明开放改编许可。
5.3 Adam 与 AdamW 的数值比较#
令初值为 θ0=(1,2),数据梯度为 (0,0),η1=0.01、λ2=λd=0.1,ϵ=10−8。采用任意合法的 β1,β2,第一步偏差修正后,Adam + L2 有:
m^1=(0.1,0.2),v^1=(0.01,0.04).所以两个坐标都约减少 0.01,得到约 (0.99,1.99)。AdamW 的矩估计为 0,只做相对比例相同的衰减,得到 (0.999,1.998)。前者在这个例子中近似按相同绝对量减少,后者按相同比例减少。
6. 配置 weight decay 时要检查什么#
- 系数定义:正则项有没有 1/2?Weight Decay 是否乘学习率?损失按总和还是平均值计算?
- 梯度处理:正则项是否进入 momentum、二阶矩或 gradient clipping?一个参数叫
weight_decay,不等于它一定实现解耦衰减
- 参数分组:哪些参数参与衰减要明确。是否排除 bias、归一化参数等取决于模型与训练配置,不能只从优化器名称推断
AdamW 中的“解耦”指衰减不进入数据梯度的自适应矩估计,不代表衰减效果与学习率完全无关。若数据梯度和初始矩状态都为 0,在本文约定下:
θT=[t=1∏T(1−ηtλd)]θ0.因此,训练步数与学习率调度仍会影响累计衰减。AdamW 把参数衰减与梯度的自适应缩放分开处理;是否能改善训练效果,还要看具体任务。