0. 为什么要给参数加惩罚#
模型可能把训练集拟合得很好,却把噪声也当成了规律。L1 和 L2 正则化会在训练目标中加入参数惩罚,减少模型为了拟合训练数据而使用过大参数的倾向。下面先看它们怎样改变参数更新,再解释正则化为什么可以写成约束或贝叶斯先验,以及 L1 为什么更容易得到零系数。
NOTE阅读需要导数、向量和基本概率知识;第 3.1 节的严格条件还需要凸优化,第 3.3 节需要似然与贝叶斯公式。第一次读可按“第 1 节 → 第 3.2 节 → 第 4.2–4.3 节”的顺序,先看惩罚怎样改变一个参数,再回看约束与先验。正则化强度仍要通过验证集等方式选择;加入正则项并不保证所有模型的泛化性能都会提高。
1. L1 和 L2 的惩罚项怎么写#
设模型参数 w∈Rd,数据损失为 L(w)。例如:
L(w)=n1i=1∑nℓ(f(w,xi),yi).n 是训练样本数,(xi,yi) 是第 i 个输入及标签,f(w,xi) 是预测,ℓ 计算这条预测的损失,L 是所有样本的平均损失。d 是参数个数,下标 i 表示样本编号,下标 j 表示参数编号。例如线性回归可取 f(w,xi)=w⊤xi、ℓ=21(f−yi)2。
本文使用如下约定,且始终令 λ≥0:
JL1(w)=L(w)+λ∥w∥1,JL2(w)=L(w)+λ∥w∥22.其中 ∥w∥1=∑j∣wj∣,∥w∥22=∑jwj2。L2 正则项使用的是范数的平方。也有资料把它写成 (λ2/2)∥w∥22,这样梯度是 λ2w;与本文等价时需要 λ2=2λ。
损失取总和还是平均值也会改变正则项的相对强度,不能脱离损失定义直接比较两个实现中的 lambda。
例如两个候选模型的数据损失分别为 0.10 和 0.15,平方范数分别为 10 和 1。当 λ=0.01 时,它们的 L2 总目标为 0.20 和 0.16,于是训练更偏好第二个:它在训练集上的损失稍大,但参数小了很多。这个选择能否让模型在新数据上表现更好,还要用验证集检查。
参数大小依赖输入单位。例如把“米”改成“厘米”,保持同一预测所需的线性系数会缩小到原来的 1/100,受到的惩罚也变了。因此常先统一特征尺度;标准化所需的均值和方差只能从训练集估计。截距是否惩罚也应单独约定,以下 w 只包括选定要惩罚的参数。
2. 参数大小与模型对输入的敏感度#
训练数据含有噪声时,过于曲折的分类边界可能同时记住规律和偶然误差。正则化可以让优化更偏向某些简单解,但“参数小”与“函数平滑”不是普遍等价的。
2.1 参数小,函数就一定更平滑吗#
先固定参数 w,只考虑单变量输入 x。若 f(w,⋅) 在 a 附近三次连续可微,则有有限阶展开:
f(w,x)=f(w,a)+∂xf(w,a)(x−a)+2∂x2f(w,a)(x−a)2+R3(x).如果连接 a 与 x 的区间上满足 ∣∂x3f(w,ξ)∣≤M,则:
∣R3(x)∣≤6M∣x−a∣3.这个展开式用一阶、二阶导数描述函数在附近的变化;如果还能限制三阶导数的大小,就能给出近似误差的上界。但要用它解释正则化,还需要知道这些导数怎样受权重影响。另外,任意函数未必等于自己的无穷 Taylor 级数。ReLU 在折点处不满足这里的可微条件,不能直接套用。
在线性模型 f(w,x)=w⊤x 中,Cauchy–Schwarz 不等式给出:
∣f(w,x)−f(w,x′)∣≤∥w∥2∥x−x′∥2.在这个例子中,限制 ∥w∥2 确实限制了模型对输入扰动的敏感度。但多层网络、带归一化的模型或不同的参数化方式,需要另外分析;不能仅靠一幅曲线或 Taylor 展开就得出泛化结论。
3. 正则化的三种理解#
3.1 限制参数大小,和给参数加惩罚一样吗#
记 R(w)=∥w∥1 或 R(w)=∥w∥22。约束问题是:
wminL(w)subject toR(w)≤C,C≥0.约束形式用 C 限定 R(w) 的上界,要求在满足限制的参数中寻找数据损失最小的解。惩罚形式则用 λ 调节参数惩罚与数据损失的相对权重。前者直接划定允许范围,后者在损失中加入惩罚。什么条件下,它们会选出同一个解?
对应的拉格朗日函数(Lagrangian)为:
L(w,λ)=L(w)+λ(R(w)−C),λ≥0.对固定 λ,−λC 与 w 无关,所以最小化 Lagrangian 与最小化 L(w)+λR(w) 得到相同的 w。但这不意味着任意给定的 C 与 λ 都匹配,更不意味着可以忽略约束,直接令所有变量的导数等于零。
以可微的凸函数 L:Rd→R 和上述凸函数 R 为例,若约束问题存在最优解并满足 Slater 条件,即存在 wˉ 使 R(wˉ)<C,则最优解可以与非负乘子 λ∗ 配对,满足 KKT 条件:
R(w∗)λ∗λ∗(R(w∗)−C)0≤C≥0=0∈∇L(w∗)+λ∗∂R(w∗)(可行性),(乘子符号),(互补松弛),(驻点条件).互补松弛可以这样理解:如果 R(w∗)<C,约束还没达到上界,那么只能有 λ∗=0;如果 λ∗>0,就必须有 R(w∗)=C。驻点条件则表示数据损失的下降方向与惩罚的作用相互抵消。
这里 ∂R 是次梯度集合,允许处理 L1 在零点不可导的情况。满足上面的凸性和约束条件时,可以用 KKT 条件判断全局最优解。换成一般的非凸问题,即使满足 KKT 条件,也未必是全局最优。Boyd and Vandenberghe,Convex Optimization,第 5 章
对应关系有两个容易忽略的细节:
- 若已经求出惩罚问题的一个全局最优解 wλ,取 C=R(wλ),则它也是这个约束问题的全局最优解;这个方向不需要凸性
- 反方向需要条件,且通常不能声称 C 与 λ 一一对应,或两个问题的整个解集完全相同。约束不活跃时,乘子可能为 0
一个边界反例是:最小化 (w−1)2,约束 w2≤0。唯一可行解是 0;而惩罚目标 (w−1)2+λw2 对任何有限 λ≥0 的最优解都是 1/(1+λ),不等于 0。这里严格可行点不存在。
3.2 普通 SGD 中的 L2 与权重衰减#
这里 t 表示第几次参数更新,wt 是本次更新前的参数,ηt>0 是本次学习率;∇L(wt) 是各参数偏导数组成的梯度。普通梯度下降从旧参数中减去“学习率 × 梯度”,下面只是把正则项的梯度也加进去。
对本文的 L2 目标做普通梯度下降:
wt+1=wt−ηt(∇L(wt)+2λwt)=(1−2ηtλ)wt−ηt∇L(wt).当 0<2ηtλ<1 时,第一项确实把旧权重按比例缩小。注意总更新还包含数据梯度,因此不保证每一步的参数范数都下降。
这个代数等价适用于不带 momentum、没有自适应缩放的普通 SGD。将 L2 梯度加入 momentum 或 Adam 的状态,与独立衰减权重一般不同,详见 Weight Decay 与 L2 Regularization。
3.3 从贝叶斯先验看 L1 和 L2#
对于固定数据 D,贝叶斯公式为:
p(w∣D)=p(D)p(D∣w)p(w).MLE 只最大化似然 p(D∣w);MAP 则最大化后验密度,等价于:
w^MAP=wargmin[−logp(D∣w)−logp(w)].似然是“假如参数取 w,观察到这批数据有多可能”;先验是看到数据之前对参数的偏好;后验把两者结合。argmin 返回使目标最小的参数,而不是最小的目标数值。取负对数后,乘积变成加法、最大化变成最小化。分母 p(D) 也叫证据,它不随 w 变化,所以优化时可以去掉。
若样本在给定 w 后独立,p(D∣w)=∏ip(yi∣xi,w),因此负对数似然就是逐样本负对数概率之和。所以,以负对数似然作为数据损失时,MAP 目标就可以写成前面的“数据损失加正则项”。
若各坐标独立服从零均值 Gaussian 先验 wj∼N(0,σ2),则:
p(wj)=2πσ1exp(−2σ2wj2),−logp(w)=2σ2∥w∥22+constant.若各坐标独立服从 Laplace 先验 wj∼Laplace(0,b),则:
p(wj)=2b1exp(−b∣wj∣),−logp(w)=b∥w∥1+constant.当 L 是总负对数似然时,本文 L2 的 λ=1/(2σ2),L1 的 λ=1/b;若 L 是 n 个样本的平均负对数似然,则对应系数分别要除以 n。这是从 MAP 角度解释正则项,并不意味着训练得到的权重必须服从这个先验,也不涉及对整个后验做积分。
4. 为什么 L1 更容易产生零系数#
4.1 先比较 Laplace 和 Gaussian 的形状#
Laplace 在零点有尖角,Gaussian 在零点平滑;但“哪个峰更高”还取决于尺度。下面固定两种分布的尺度,比较它们在几个位置的密度。
| 分布 | 密度 p(w) | p(0) | p(1.5) | p(3) |
|---|
| Laplace(0,b=1.5) | 31e−∣w∣/1.5 | 1/3≈0.333333 | e−1/3≈0.122626 | e−2/3≈0.045112 |
| N(0,σ2=2.25) | 1.52π1e−w2/4.5 | 0.265962 | 0.161314 | 0.035994 |
Gaussian 这一行的标准差是 1.5;作为对照,标准正态(Standard Normal)是 N(0,1),标准差为 1。Laplace 的 b=1.5 则给出峰值 1/(2b)=1/3。两行尺度参数数值相同,不代表方差相同。密度定义可对照 SciPy Laplace 文档 与 SciPy Normal 文档。
密度曲线只提供直觉。零系数的直接原因,要看惩罚项的次梯度。
4.2 L1 在零点的次梯度#
绝对值函数在零点左右的斜率分别为 −1 和 1,没有唯一普通导数。对于凸函数,次梯度允许用一组“从下方支撑函数图像的直线斜率”代替单一导数;在这个尖角处,这组斜率恰好是区间 [−1,1]。因此:
∂∣wj∣=⎩⎨⎧{1},[−1,1],{−1},wj>0,wj=0,wj<0.因此,对可微凸损失,L1 目标的最优性条件是:
0∈∇L(w∗)+λ∂∥w∗∥1.在零坐标上,只要 ∣∂jL(w∗)∣≤λ,就能选到一个次梯度抵消数据梯度。这允许一段范围内的数据梯度对应恰好为零的系数。相较之下,L2 的梯度 2λwj 在 wj=0 时也是 0,通常只是连续缩小系数。L1 也不保证任何数据、任何 λ 下都产生零;普通次梯度迭代更不保证每一步得到精确零。
4.3 平方损失下的软阈值解#
考虑最简单的平方损失:
wmin21∥w−z∥22+λ∥w∥1.这里 z 是一个固定的目标向量,不是新的模型参数;若没有惩罚,最优解就是 w=z。损失与惩罚都按坐标求和,因而每个坐标可分别最小化 21(wj−zj)2+λ∣wj∣:
- 若 wj>0,导数为 wj−zj+λ,置零得 wj=zj−λ,它只有在 zj>λ 时才符合正号假设。
- 若 wj<0,导数为 wj−zj−λ,置零得 wj=zj+λ,要求 zj<−λ。
- 剩下 ∣zj∣≤λ 时,零点左右的斜率允许在这里达到最小值,取 wj=0。
合并这三种情况,得到软阈值(Soft Thresholding)解:
wj∗=sign(zj)max(∣zj∣−λ,0).取 z=(3,−0.4,0.2)、λ=0.5,得到 w∗=(2.5,0,0)。而在同一个平方损失上加入本文定义的 L2 项,解为:
w∗=1+2λz=(1.5,−0.2,0.1).L2 的结果也可直接验算:每个坐标的导数为 wj−zj+2λwj,置零后得到 (1+2λ)wj=zj。L1 的“减去固定门槛”与 L2 的“按比例缩小”,在这个简单问题里便能看得很清楚。
LASSO 是在线性回归的平方损失上加入 L1 惩罚的模型。这不是说一般 LASSO 都能对原始观测值直接做一次阈值操作;这里的闭式解依赖于平方损失可按坐标分离。一般设计矩阵下需要另外求解。Ryan Tibshirani:Subgradients and Soft Thresholding
4.4 从几何图看 L1 为什么容易得到零系数#
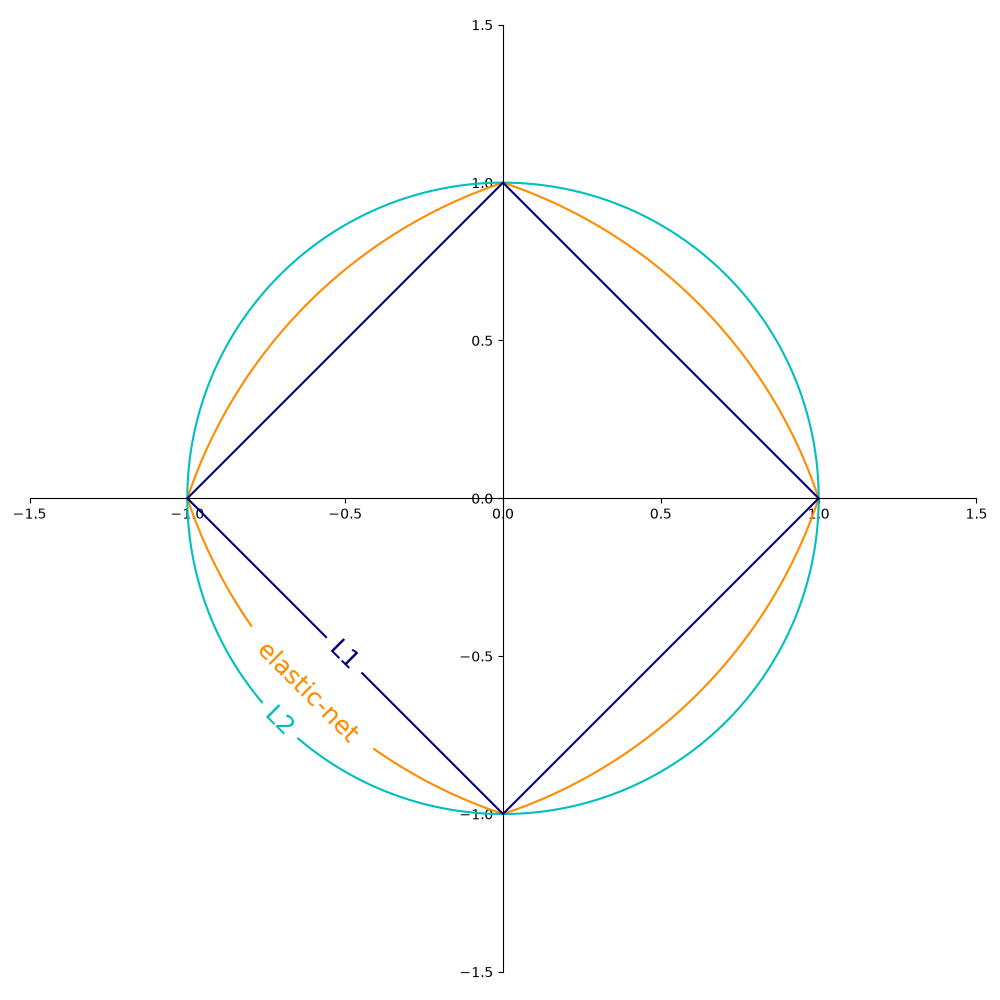
先看深蓝菱形落在坐标轴上的四个尖角:每个尖角都有一个参数为零。青色圆在这些位置仍然平滑;这个形状差异帮助理解 L1 的稀疏性,但是否真的取到零仍要结合数据损失判断。
图源:scikit-learn 官方 SGD: Penalties 示例,The scikit-learn developers,BSD-3-Clause 许可,原图未修改。横、纵坐标分别表示两个参数。深蓝色 L1 轮廓是菱形,青色 L2 轮廓是圆;橙色 elastic-net 轮廓展示两种惩罚混合后的形状。三条线表示各自惩罚值为 1 的边界,内部是惩罚不超过 1 的区域。图中没有画数据损失的等高线,也没有标出某个训练问题的最优解。
二维 L1 球 {w:∥w∥1≤C} 是菱形;三维是八面体;更高维称为 cross-polytope。它不是高维立方体,立方体对应的是 ∥w∥∞≤C。L2 球 {w:∥w∥2≤r} 则是通常的欧氏球;若写成 ∥w∥22≤C,半径为 C。
L1 边界有许多坐标为零的角和面,损失等高线与这些位置接触时会得到稀疏解。L2 边界平滑,没有同样的坐标轴偏好。几何图能帮助理解次梯度条件,但不能据此断言“L1 的最优解永远位于顶点”。
由于 LASSO 可以把部分系数压到 0,我们也可以用它筛选特征。不过系数被压到 0 只说明该特征在当前模型、数据缩放和正则强度下没有被选中,不等于证明它在所有场景中都没有用。特别是特征高度相关时,选择结果可能不稳定。
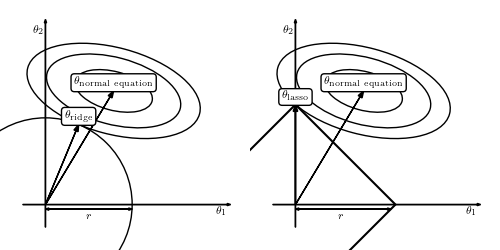
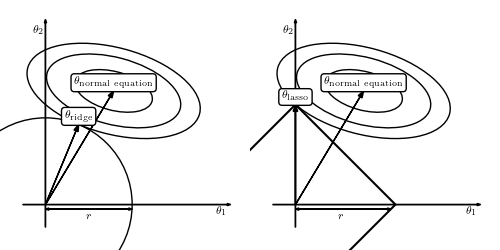
再把损失函数的等高线加进来,才能看到“为什么会等于零”。图中左边是 ridge(L2),右边是 lasso(L1);横纵轴分别是两个系数。椭圆围绕未加约束的最小二乘解,向中心收缩代表损失更小。寻找仍与约束区域接触的最小椭圆:左图接触圆弧,两个系数通常都非零;右图接触竖轴上的菱形尖角,所以横轴对应的系数恰好为零。这是一个二维示意,不能推出每个 L1 问题都一定得到零系数,也不能仅靠尖角判断有多少个零。
原图未改动:astroML,Ridge and Lasso: Geometric Interpretation,Jake VanderPlas,教材图 8.3;作者示例标注 BSD 许可。原图链接。