0. 做一个文档问答助手,需要哪些部分
假设我们要做一个助手,回答「这个项目怎么部署」,必要时还能读取文档、检查服务状态。模型写出回答只是其中一步。应用还得决定给模型看什么资料、怎样保留出处、允许调用哪些工具,以及失败后怎么办。
下面按提示词、检索、工具和 Agent 四部分,看看资料怎样进入模型、工具怎样执行,以及回答出错时该查哪里。
NOTE本文涉及的接口以 2026-10-07 的官方资料为准。LangChain v1 已调整包结构,一些旧 chains、retrievers 和缓存组件移入
langchain-classic。下文短代码用于解释接口,完整应用还需固定依赖并连接模型与数据源;使用前应核对自己的版本与官方迁移指南。
应用中常用的四种方法各有用途:
| 做法 | 改变了什么 | 适合解决什么问题 |
|---|---|---|
| Prompt / few-shot | 本次输入中的规则和例子 | 任务说明、回答格式、示范做法 |
| RAG | 回答时提供的外部证据 | 文档更新、保留可核对的出处、私有知识问答 |
| 工具调用 / Agent | 应用可以执行的步骤及其选择方式 | 查实时数据、调用服务、完成多步任务 |
| 微调 | 模型参数 | 从训练样本学习任务或行为模式 |
这些方法可以组合。检索不自动等于 Agent,提示模板也不会更新权重。模型如何生成 token,见解码策略;训练如何改变参数,见大模型训练篇。本篇不重复模型内部原理。
1. 怎样组织发给模型的提示词
Prompt 是应用交给模型的任务说明和相关材料。其中既有应用规定的任务,也有用户问题、示例、检索材料和对话历史。模板的价值在于把这些部分组织清楚,避免到处拼字符串;它本身不保证模型遵守要求。
1.1 PromptTemplate 文本模板
PromptTemplate 适合生成一段文本。固定内容留在模板里,变化的内容通过变量传入。下面是一种构造方法:
from langchain_core.prompts import PromptTemplate
prompt = PromptTemplate.from_template( "请用{language}解释以下术语,并给一个例子:{term}")text = prompt.format(language="中文", term="检索增强生成")这一步只生成字符串,没有调用模型。
变量替换后的 text 是「请用中文解释以下术语,并给一个例子:检索增强生成」。只有把它传给已配置模型的调用接口,才会产生回答;因此,需要分别检查模板是否正确组装、模型请求是否成功,以及答案是否正确。
把输入写入模板也不意味着它变成可信指令;尤其不要接受外部用户上传的任意可执行模板。具体模板能力应以对应版本的实现为准。
1.2 ChatPromptTemplate 消息模板
聊天模型的输入通常是消息列表,每条消息有角色和内容。可以把系统规则、用户问题、历史回答分开,而不是把角色名写进一大段普通文本。消息还可以包含工具结果,消息结构应按模型和接口支持的角色组织。
下面只检查消息如何组装,不发起远程请求:
from langchain_core.prompts import ChatPromptTemplate
prompt = ChatPromptTemplate.from_messages([ ("system", "你是项目文档助手。证据不足时说明缺少什么,不编造出处。"), ("human", "问题:{question}\n\n供参考的资料:\n{context}"),])messages = prompt.invoke({ "question": "这个服务的配置文件在哪里?", "context": "[部署手册 §2] 配置文件位于 ~/.example/config.yaml。",}).to_messages()from_messages、变量替换和消息转换可对照官方 ChatPromptTemplate 源码与示例。检索到的文档只是资料,即使其中写着「忽略上面的规则」,也不应获得修改应用权限的能力。权限检查应由执行工具的程序完成。
1.3 Few-shot:给模型看哪些示例
Few-shot 的意思是:在当前输入里放几个「输入 → 理想输出」示例,让模型参考。示例较多时,除了相关性,还要考虑还能放下多少 token,以及例子是否重复。
按长度预算选择示例
先扣掉任务说明、当前问题、历史消息和预留输出占用的预算,再决定能放几个示例。某些长度选择器使用字数或简单计数函数;它们不等于目标模型的真实 token 计数。输入更长时通常要减少示例,但不能仅凭字符数断定请求不会超限。可对照长度选择器实现。
按语义相似度选择示例
把输入和示例表示成向量,再找较相近的例子。例如待分类文本是产品退款问题,就优先选择退款类示例。相似度只是选择信号,不代表例子的标签正确,也不意味着所有向量数据库都使用同一种距离。
用 MMR 兼顾相关性与多样性
只选最相似的例子,可能得到五个几乎相同的退款案例。MMR(最大边际相关性)同时考虑相关性与多样性。设问题为 ,已选集合为 ,待选例子为 ,一种常见评分写法是:
其中 。第一项奖励「像当前问题」,第二项惩罚「和已选例子太重复」。 越大,越看重相关性。首个例子可先按相关性选择;之后逐个更新 。这里惩罚的是与已选示例的重复,而不是与整个示例池的相似。LangChain 的 MMR 实现使用了这种逐步选择方式。
用数字看一次选择:已选一条退款示例,候选 A 与问题相似度为 0.9、与已选示例相似度为 0.95;候选 B 对应为 0.8、0.2。取 ,A 得 ,B 得 ,所以这轮选择 B。B 仍然相关,却提供更多不同信息。这里假设两类相似度使用同一可比较的尺度。
LangChain 的语义相似度与 MMR 选择器会调用底层 vector store 的搜索接口;具体参数和距离约定见官方实现。同样的 MMR 思路也能用于检索结果去重。
按 n-gram 重合程度选择示例
也可以比较短词串的重合程度来选择示例。它容易解释,适合表述接近的例子;同义改写可能得分低,字面很像但意思相反的文本也可能得分高。阈值约定属于具体实现,不能当成所有相似度筛选器通用的规则。
1.4 把选好的示例放进模板
把上述选择器接到 few-shot 模板里,流程就是:准备示例池 → 根据当前问题选例子 → 与任务说明、问题一起组装输入。不用框架,先把步骤写成伪代码:
候选 = 从示例池检索与当前输入相关的例子已选 = 在剩余 token 预算内选择候选,并减少重复消息 = 系统规则 + 已选输入输出对 + 当前问题回答 = 调用模型(消息)检索示例与检索知识不是同一个目的。 前者通常示范「怎么回答」,后者提供「根据什么回答」。两者都可以用向量搜索,但用于问答的事实证据仍应保留来源和版本,不能因为示例看起来相似就把它当成当前事实。
1.5 用 partial 预填模板变量
Partial 的作用是提前填好一部分变量。例如每个请求都用中文,可以先绑定语言,再只传问题。它适合减少重复参数;若绑定的是取时间的函数,还要确认该函数何时求值,以及是否需要为一次请求固定相同时间。具体行为见模板基类实现。
from langchain_core.prompts import PromptTemplate
base = PromptTemplate.from_template("用{language}解释:{topic}")chinese = base.partial(language="中文")text = chinese.format(topic="向量检索")1.6 组合多段模板,替换旧版 PipelinePrompt
PipelinePrompt 是旧版 LangChain 中连接多段模板的一种方式,例如组合介绍、示例和用户问题。迁移到新版时,可以保留「分块组装输入」的思路。用明确的中间变量、消息列表或当前版本支持的组合接口,也能完成同样的工作。
组装后至少检查三件事:变量是否遗漏、资料是否被截断、是否给输出留了足够空间。如果要求 JSON,除了提示词,还应使用支持的结构化输出能力并校验字段;合法 JSON 也不代表事实正确。可对照LangChain 结构化输出文档。
2. 检索增强生成(RAG)
RAG(Retrieval-Augmented Generation,检索增强生成)是在回答时先取得相关资料,再让模型结合资料生成答案。它不要求把知识「写进模型参数」,也不要求检索过程本身必须由 LLM 执行。
以项目文档助手为例,把流程分成两条会更清楚:
- 建库阶段:读取文档 → 保留来源与权限 → 切块 → 计算表示 → 建索引
- 问答阶段:接收问题 → 检索允许访问的片段 → 筛选并组装上下文 → 生成回答与出处
这是一种常见的向量检索方式。如果已经有 SQL、全文搜索或业务 API,也可以直接利用它们实现 RAG,不一定要另建向量库。固定地「先检索、再回答」,与由 Agent 动态决定何时检索,是两种不同的控制方式。官方检索说明介绍了这些区别。
先把建索引与回答问题分开看。下面两张在 LangChain 官方教程图上增加了中文阅读标注;按图中编号定位,再结合图下说明理解数据如何流动。
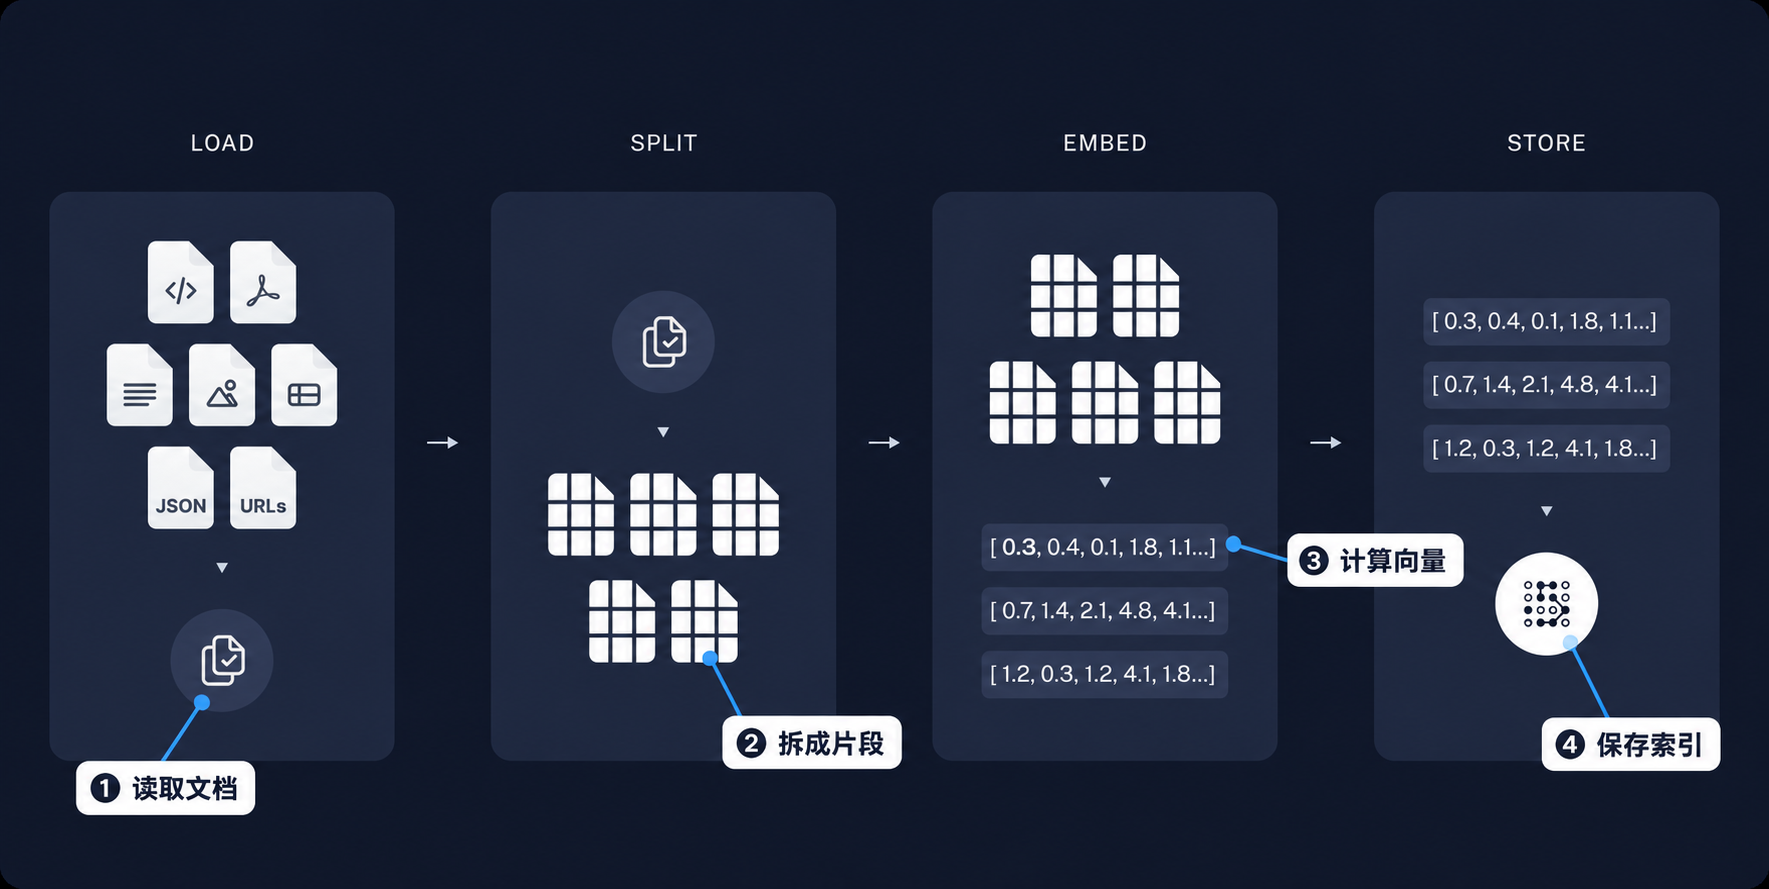
来源:LangChain RAG 教程;原图,MIT 许可及版权声明。本图增加中文阅读标注。
- ① 读取文档:LOAD 将不同文件和网页读成统一文档对象;正文之外还要保存来源与权限信息。
- ② 拆成片段:SPLIT 把文档分为适合检索的块;切得太碎可能丢上下文,太大则容易混入无关内容。
- ③ 计算向量:EMBED 把每个片段转成数值表示,用来比较相关性;图中的数列只是示例。
- ④ 保存索引:STORE 保存可供搜索的表示,并保留它与原正文、来源的对应关系。检索命中后还需要取回正文。
第一张沿白色箭头从左往右读:LOAD 把 PDF、网页等来源读成文档;SPLIT 把文档拆成小块;EMBED 为每块计算一串数值;STORE 将向量与对应正文、来源标记一起存下。图里的数字只是向量示例,没有固定维度;索引通常提前建立,文档变化时再更新,不必每次提问都重建。
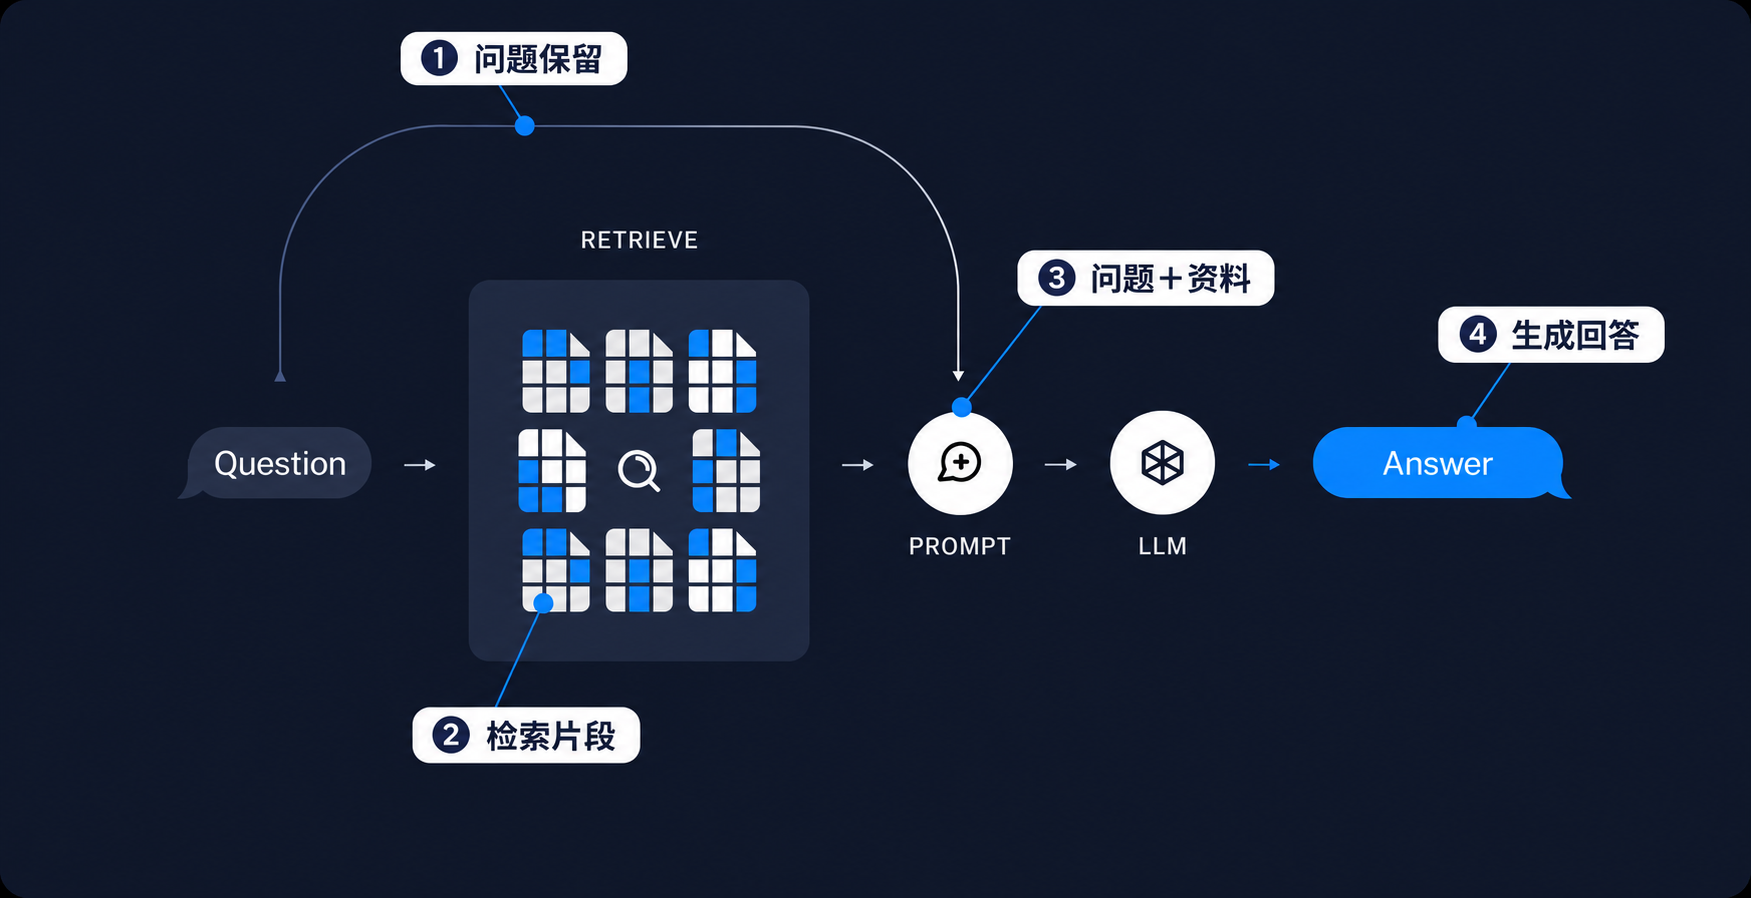
来源:LangChain RAG 教程;原图,MIT 许可及版权声明。本图增加中文阅读标注。
- ① 问题保留:上方弧线把原问题送到提示词;找到资料之后,模型仍需要知道用户问了什么。
- ② 检索片段:检索器根据问题寻找相关片段,蓝色块突出相关内容;实际应用还应先满足访问权限。
- ③ 问题+资料:两路信息在 PROMPT 汇合,将问题与取回的正文一起组织进模型输入,而不是直接塞入检索向量。
- ④ 生成回答:LLM 根据当前输入生成答案;答案仍需核对依据,检索过程本身不保证回答正确。
第二张左侧 Question 分成两条路线:水平箭头进入 RETRIEVE,从文档块中找与问题相关的内容;上方弧线把原问题直接送到 PROMPT。两条路线在提示词处汇合,LLM 看到的是问题和检索回来的正文,再生成右侧 Answer。蓝色小格突出检索相关内容,不表示向量本身成为模型的文字输入;检索错误时,模型仍可能给出看似流畅但无依据的答案。
2.1 文档加载
Document Loader:读取正文,记下来源
Loader 负责把文件、网页等来源转成应用能处理的文档对象,而不是判断文档中的指令该不该执行。Document 的正文用于检索,metadata 则适合保存 URL、文件名、章节、更新时间和业务权限标识。
至少保留能回答两个问题的信息:「这段话来自哪里」「这个用户能否看到它」。如果只保存纯文本,即使回答碰巧正确,也很难给出可核对的出处。
自定义 BaseLoader 时,可以按需求实现同步、异步和 lazy 读取:一次读取全部适合小数据;惰性迭代便于逐批处理大数据;异步可以在等待一次读写时处理其他任务。它们都不自动保证低内存,后续若立刻收集为大列表,仍会把数据全部装入内存。各 loader 的能力应按对应集成文档检查。
2.2 文本分块
分块有两个目标:提高相关片段的检索命中率,并使组装后的上下文符合模型的输入限制。块太大,相关的一句话可能埋在无关内容里;块太小,定义、条件和结论又可能被分到不同块中。不存在对所有文档都最优的固定大小。
按字符分隔符切块
CharacterTextSplitter 先按指定分隔符切开,再按长度与 overlap 规则合并。chunk_size 用于控制合并后的块大小;但如果一个原始片段本身超过上限,这种 splitter 不一定继续拆开它,因此该值并非严格的最终长度保证。可对照字符分割文档及实现中的合并流程。
递归使用更细的分隔符
递归分割器会依次尝试更细的分隔符,例如段落、换行、空格和字符。处理中文时,还应考虑句号、逗号等边界,不能只依赖英文空格。下面的配置可以作为起点,但不一定适合所有场景:
from langchain_text_splitters import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter( chunk_size=500, chunk_overlap=80, length_function=len, separators=["\n\n", "\n", "。", ";", ",", " ", ""],)chunks = splitter.split_text("这里替换为需要检索的项目文档。")此处 len 计的是 Python 字符数,不是 token 数。Overlap 用于尽量保留边界附近上下文,也会带来重复存储和重复检索;不应指望每块都有刚好相同的重叠长度。递归分割文档说明了长度函数、分隔符与 overlap 的关系。
用 tokenizer 检查每块有多长
模型按 token 限制输入时,应使用匹配的 tokenizer 检查。分块满足 embedding 模型上限还不够:问题、提示词、多个片段、消息格式以及预留回答,加起来也要满足生成模型的预算。两种模型的 tokenizer 不一定相同。
分词本身的算法和计数差异,见Tokenization。这里用 tokenizer 的计数结果检查输入是否超长。
按语义变化分块
语义分块则比较相邻句组的表示,在语义变化较大处切开。它可能改善语义完整性,也会增加 embedding 成本;仍需处理过长片段,不能取代长度校验。
实验性语义分块组件中的百分位数、标准差、四分位距等方法,是决定「变化多大才切开」的不同阈值策略。旧版本采用的默认分位数只是实现选择,并不适用于所有文本。实际比较时固定文档和测试问题,观察正确片段是否更容易命中,也要看回答需要的条件有没有被切丢;片段读起来完整,不代表就容易检索。
2.3 文本向量与相似度
向量就是一串数,例如 。Embedding 模型学习把文本映射为这样的数列,希望适合任务的相关文本更接近。以余弦相似度为例,它计算两个向量夹角的余弦:。点积 是对应元素相乘后相加,长度 是元素平方和的平方根。对非零向量,数值越接近 1 表示方向越接近。
一个仅用于算术说明的例子:问题向量取 ,两个片段向量为 、,三者长度都为 1,因此相似度分别为 0.8 与 0。按这个指标会先取 a。这些是人为选择的二维数值,真实文本 embedding 通常有更多维,单独一维通常也不直接对应「退款」这样的明确含义。
检索 embedding 把一段文本变成向量,用于比较或搜索。它通常包含对整段输入的编码处理,不能简单理解成一次 token embedding 矩阵查表。同维度的向量也不自动可比,查询和文档表示应使用兼容的模型与约定。
LangChain 区分文档批量编码与查询编码,例如 embed_documents 和 embed_query;某些模型对两类输入的处理不同。换模型或表示方式后,需要重新检查索引兼容性与检索效果。官方 embedding 集成说明说明了各类接口的用法。
Embedding 结果缓存
CacheBackedEmbeddings 缓存的是文本到向量的结果,不是 Transformer 每一层的 KV Cache,也不是逐 token 查表结果。相同文本再次编码时可以复用已存向量;缓存 namespace 应能区分模型及会改变结果的配置。
文档 embedding 缓存和查询 embedding 缓存还需要分别考虑。查询是否缓存取决于配置,不能因为包装了一层缓存就假定所有请求都会命中。官方缓存实现展示了这一区别。模型推理时的 KV Cache 则见推理中的缓存与执行。
2.4 存储向量,并维护文档索引
Vector store 把向量与原始内容、metadata 关联起来,并提供搜索等操作。选择它时,不只看「能存多少向量」,还要看过滤、更新删除、索引持久化和故障恢复是否满足应用要求。
几个容易遗漏的细节:
- 距离分数可能是越大越近,也可能越小越近;跨库阈值不能直接搬用
- 文档更新后要同步索引,否则回答会继续引用旧内容
- 在多用户应用中,必须在资料进入模型上下文前完成访问控制
- 删除原文件不一定自动删除索引、缓存和日志中的副本
FAISS 与 Qdrant 的向量检索应用通常都遵循「加载 → 切块 → embedding → 搜索」流程。理解其中一种实现后,再按需求查具体集成即可。
用异步查询时,限制好并发
异步接口有助于同时处理多个等待网络或磁盘的操作,但不意味着可以无限并发。使用时仍要设置批量大小、超时和并发上限,并处理供应商限流。实际能快多少,取决于等待时间、批量大小和服务限流。
2.5 检索器
Retriever 接收一个查询,返回相关文档。Vector store 可以包装成 retriever,但 retriever 也可以用全文搜索、数据库或其他来源;不同检索器也未必都通过向量存储的包装接口实现。官方 retriever 列表能看到这种多样性。
基于向量存储的检索器
从最简单的 top-k 开始:先看召回结果,再调整 k、metadata 过滤或分数阈值。k 大了可能找到更多证据,也可能挤掉真正重要的片段。结果重复时可尝试 MMR,其相关性与多样性的取舍见前文。
MultiQueryRetriever 多查询检索
当用户表述与文档差距大时,可以生成不同表述的查询,分别搜索再去重合并。例如「重启后怎么没反应」可以补充「服务启动」「网关日志」等查询。但改写可能偏离原问题,也会增加调用次数;保留原问题并检查新查询是否引入了用户没有提供的条件。
它适合解决「问法不同导致漏检」,不能替代权限过滤,更不能保证生成的每个查询都正确。旧 MultiQueryRetriever 类属于版本敏感实现,迁移时应检查相关类是否已移入 langchain-classic。
检索结果压缩
检索后还可以压缩上下文。要区分两种操作:
- 过滤、去重、重排:保留或调整原文片段,不一定改写其文字
- 抽取、摘要:产生更短的文本,可能遗漏限制条件,需要继续关联原始出处
这两类操作都可以组成 compression pipeline,但作用不同。常见处理顺序是:先召回 → 检查权限 → 去重与筛选 → 必要时抽取 → 组装上下文。比如检索到整章部署手册,问题只问配置位置,优先保留对应段落及章节标识,以免无关内容挤占模型的上下文。
2.6 跑通一次问答,看看错误出在哪一步
把前面的组件连起来,逐步看一次问答会发生什么。假设知识库只有以下两段演示材料:
- D1,来源「部署手册 §2」:配置文件在
~/.example/config.yaml - D2,来源「日志手册 §1」:日志写入
~/.example/logs/
用户问「配置文件在哪」。建库时,loader 保留两段正文与来源;splitter 判断两段已经足够短,无须再切;embedding 模型分别生成向量,vector store 保存「向量 → 正文与来源」的对应关系。问答时,同一套兼容的编码方式生成问题向量,retriever 按相似度取得 top-k,其中 k 就是最多取几条。
假设这次取回 D1,应用把它的正文和来源填入第 1.2 节模板的 context,问题填入 question,再调用生成模型。模型读到的是「配置文件在……」这段原文;向量只用于前面的检索。预期答案为「配置文件在 ~/.example/config.yaml,依据部署手册 §2」。来源标签来自建库记录,再由应用核对引用是否对应实际给出的片段。
若用户改问「生产环境 API key 是什么」,这两段没有答案;相似度搜索即使仍返回 D1,也不能把“最接近”解释为“足以回答”。这正是要同时检查召回结果、资料是否支持答案与模型是否越过证据范围的原因。
用一小组能人工核对的问题检查中间结果。每题记录应该引用的文档、实际召回片段、最终使用的上下文和答案:
| 观察到的问题 | 优先检查 |
|---|---|
| 正确文档根本没进库 | loader、更新流程、访问权限 |
| 文档在库里,但正确片段没召回 | 分块、查询表达、检索方法与 k |
| 召回正确,组装后却消失 | 去重、压缩、排序与 token 预算 |
| 证据已经给到,回答仍编造 | 指令、模型行为、证据引用与输出校验 |
至少加入「库里没有答案」与「旧版和新版文档冲突」两类题。一次成功问答还不足以判断 RAG 应用是否可靠。
3. 定义工具,让应用执行模型的请求
Tool 是应用提供的一个可调用操作,例如搜索文档、计算数值或查询服务状态。模型通常生成工具名称和参数,应用执行函数,再把结果交回模型。模型声称「我执行了」不是执行成功的证据。
工具的名称、参数与返回值
一个工具至少要讲清楚名称、用途、输入结构和实际实现。名称与说明影响模型选择,参数 schema 说明输入应包含哪些字段和类型;应用仍要自己检查用户有没有权限执行操作。工具返回结果也应明确区分成功、无结果和失败。LangChain 工具文档说明了工具的定义方式。
怎样把函数变成工具
用装饰器定义工具
简单函数可以用装饰器注册为工具。以下例子只做本地字符串处理,便于观察接口,不涉及网络或文件写入:
from langchain.tools import tool
@tooldef normalize_issue_key(value: str) -> str: """把非空的问题编号去掉首尾空白并转成大写,不查询问题内容。""" result = value.strip().upper() if not result: raise ValueError("问题编号不能为空") return result
result = normalize_issue_key.invoke({"value": " docs-42 "})这一调用返回字符串 DOCS-42。这是应用直接测试工具,没有模型参与。接入 Agent 后,模型可以请求工具名和参数 {"value": " docs-42 "};应用验证参数后执行 .invoke(...),把返回值作为工具结果放回对话,模型才据此继续回答。先直接测试函数,再接入模型,能够区分“工具本身出错”与“模型选错工具或参数”。
输入 schema 能检查参数的字段和类型,但「这个问题是否属于当前用户」之类的规则,仍需由工具服务检查。密钥、身份和权限上下文由应用管理,不应让模型通过可编辑参数自行声明。
继承 BaseTool
当工具需要维护客户端、定制同步/异步行为或复用复杂实现时,可以继承 BaseTool。以 ArXiv 查询工具为例,可以这样分层:工具层提供名称和输入约定;底层客户端负责查询、超时与返回值处理。
继承并不一定比装饰器更合适。先用最简单、可独立测试的函数,确有需要再增加抽象层。
用 StructuredTool 包装已有函数
StructuredTool.from_function 用于把已有函数包装成带结构化参数的工具。它与装饰器、继承方式解决的是相近的问题,不是三个必须按顺序掌握的阶段。使用时应以对应版本的接口为准,不依赖它是否采用 dataclass 实现。
工具调用的错误处理
工具失败后,应把错误与正常结果区分开,并按原因处理:
- 输入有问题:给出可修正的信息,而不是无限重试
- 短暂超时或限流:按预算进行有限重试
- 权限不足:停止越权步骤,说明需要什么权限
- 有副作用的操作超时:先核对是否已经执行,避免重复提交
ToolException / handle_tool_error 属于工具对象的错误处理方式;LangChain v1 的 Agent 还提供 middleware 拦截工具调用。不要把旧示例直接混入新 Agent 配置,参见迁移指南的工具错误处理部分。无论使用哪种接口,都应保留可供排错的内部日志,同时避免把凭证或完整私有内容写进用户可见错误。
4. Agent 的执行循环
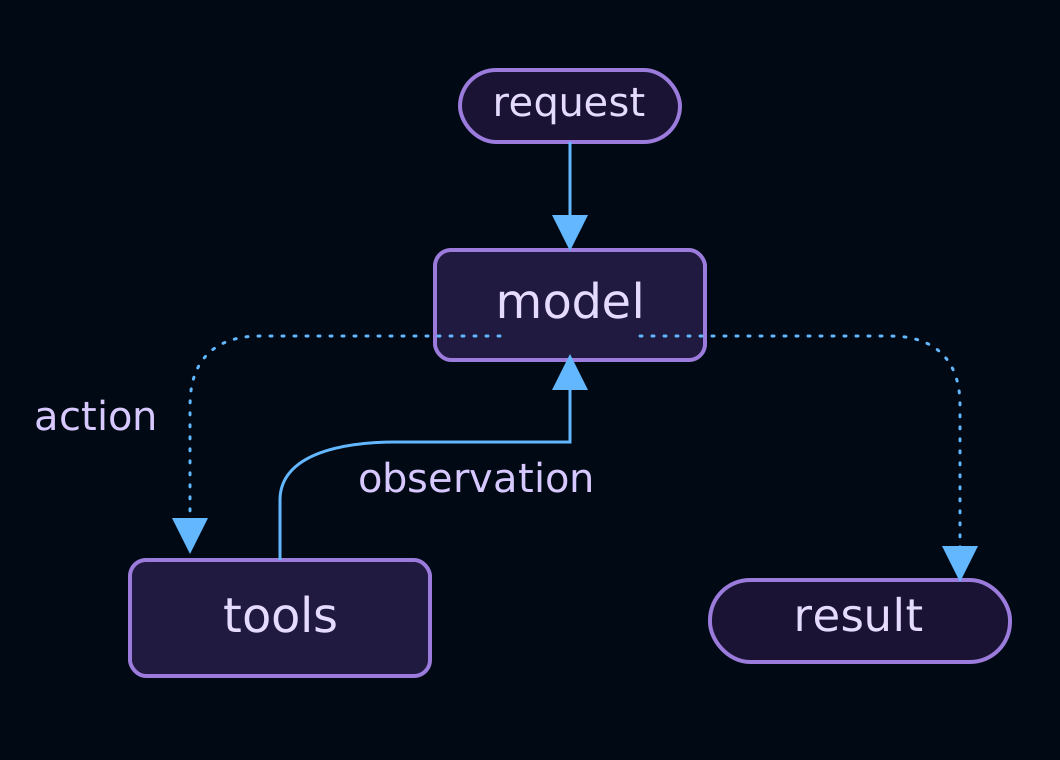
来源:LangChain Agents 官方文档;原图原样保留,MIT 许可及版权声明。
沿图读一轮:上方 request(请求)进入 model(模型);左侧 action(动作)进入 tools(工具),执行后 observation(观察结果)沿实线返回模型;不再需要工具时,模型走右侧 result(结果)出口。工具返回后仍要再调用模型判断下一步,所以一次 Agent 任务可能包含多次模型请求。图是最小控制循环,权限检查、超时和失败恢复仍要由外围程序实现。
如果应用明确规定「检索一次,然后回答」,这是固定工作流。当模型要根据前一步结果选择下一步工具,并在多轮中推进任务时,才需要讨论 Agent 的控制循环。Agent 不只是一个 LLM,还包括工具执行、状态、停止条件和权限控制。官方 Agent 文档把模型与这些外围机制放在一起解释。
4.1 每一轮做什么,什么时候该停
以「检查部署说明与当前服务状态是否一致」为例,可以先画出控制逻辑:
接收用户任务,建立本次状态与预算循环: 把允许使用的资料和工具交给模型 如果模型给出最终答案:检查证据后返回 否则:验证工具名、参数与权限 需要审批时暂停,等待用户决定 执行允许的工具,把真实结果加入状态 若超过时间、轮次或费用预算:停止并说明未完成部分这只是应用层伪代码,不是可直接部署的 Agent。特别是「验证权限」和「需要审批时暂停」必须在执行前发生,不能寄希望于系统提示词阻止所有危险调用。
LangChain 当前的 create_agent 提供模型、工具、提示及 middleware 的组合入口,并基于 LangGraph 实现运行机制。若任务的分支和顺序本来就确定,普通函数或显式工作流可能更容易验证,不必先增加一个自主决策循环。框架概览
4.2 状态、长期记忆与缓存的区别
- 对话状态:本次任务的消息、工具结果、进行到哪一步
- 长期记忆:应用选择持久保存、以后再取回的事实或偏好,需要更新和删除规则
- 检索索引 / embedding 缓存:便于找到资料或避免重复编码
- 模型 KV Cache:推理引擎保存的中间张量,用来减少重复计算
这些机制保存的内容和保存时长各不相同。把聊天历史全留着不等于做好记忆管理;长期记忆中的内容由应用存取,并不代表模型参数已通过训练学到它们。
4.3 上线前要测哪些情况
准备让 Agent 持续运行前,至少测试这些情况:
- 工具范围是否最小化,读操作与写操作是否分开
- 每次执行有没有真实的状态、结果和可追踪标识
- 重启后是否会重复提交之前的写操作
- 工具返回恶意文字时,是否仍然执行原定的权限检查
- 是否能主动停止,并准确说明已经完成与尚未完成的部分
常驻运行、消息网关、Windows 与 Linux 之间的恢复,则是部署层的问题,放在Hermes Agent 的 WSL 部署案例里展开。Hermes 是另一个应用实现;阅读该案例不要求先把它当作 LangChain 的插件。
参考资料
- LangChain v1 迁移指南:包结构、旧组件与工具错误处理迁移
- LangChain 检索概览:知识库、检索流程与不同 RAG 控制方式
- LangChain 文档与检索集成:按需求选择实现,而不是复制过时导入路径
- LangChain Agent 文档:模型、工具、状态与运行循环
API 会随版本变化。排查问题时,沿着“输入 → 检索 → 模型 → 工具 → 回复”逐步检查,先找出哪一步的结果不符合预期,再查对应版本的接口。
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。