0. 从这门课开始学因果推断
我一直想学因果推断(Causal Inference),这次准备跟着课程边学边写,把遇到的问题和推导记录下来。
看过一些推荐,也自己试学后,我选择了 Brady Neal 的入门课程,这个系列就从它开始。课程链接: https://www.bradyneal.com/causal-inference-course
NOTE这些是初学者的个人学习笔记,记录和理解难免有错,欢迎指正。
本文需要概率、加权平均和条件概率的基础。后文 表示总体中 的平均水平; 表示只在实际接受处理的人中求平均。竖线 是“已知/限定在”,不是“主动把处理设为 1”。区分“观察谁接受了处理”和“主动给谁安排处理”,是理解因果推断的起点。
1. 为什么分组看和合起来看,结论会相反
Brady Neal 课程的第一章从辛普森悖论出发,介绍相关性和因果性的联系与区别。
1.1 用治疗方案理解辛普森悖论
辛普森悖论(Simpson’s Paradox)常被用来引入因果推断。假设一种疾病有 A、B 两种治疗方案,其中 B 比较稀缺,只有较少的志愿者能用上。在下面的数据中,接受 A、B 的志愿者分别占 73% 和 27%:
表中的百分比是接受相应治疗后志愿者的死亡率。Mild 组表示轻症,Severe 组表示重症。
| 方案 | 轻症 Mild | 重症 Severe | 合计 Total |
|---|---|---|---|
| A | 15%(210/1400) | 30%(30/100) | 16%(240/1500) |
| B | 10%(5/50) | 20%(100/500) | 约 19.1%(105/550) |
数据来自 Brady Neal 教材表 1.1,括号中为死亡人数/该组总人数;这是用于讲解的假设数据。
从上表可以看到,无论轻症组还是重症组,方案 B 的死亡率都明显更低。但把所有人合在一起看,Total 列反而是方案 A 的死亡率更低。到底哪个方案更好呢?
关键在于两组的患者构成:接受方案 B 的 550 个人中,有 500 个是重症患者。计算总体死亡率时,重症组的权重更大,使方案 B 的 Total 死亡率接近 20 %。接受方案 A 的轻症患者更多,最终平均死亡率反而比较低。要判断哪个方案更好,还需要知道其中的因果关系。
先看受试者的病情(Condition)影响方案选择的情况。例如,医生根据病情选择治疗方案:轻症通常安排方案 A,重症安排方案 B。它们之间的关系如下:
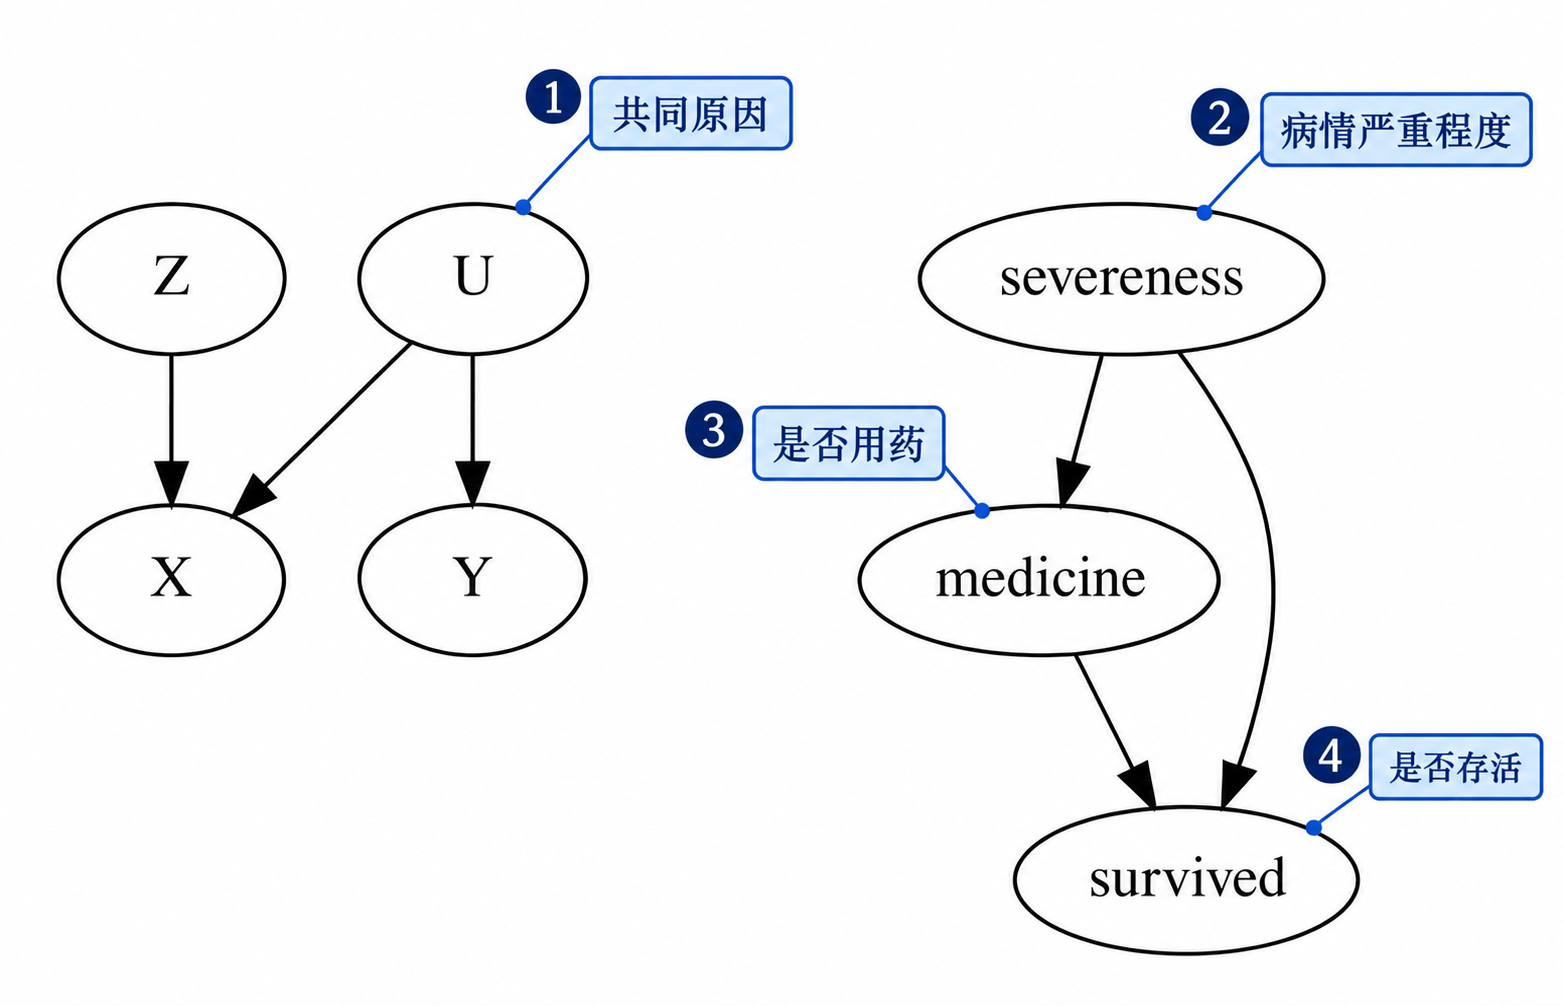
- ①左图的共同原因 U 同时指向 X、Y,另有 Z 指向 X。它单独展示一种因果结构,不是上表数据的拟合结果。
- ②右图的 severeness 是病情严重程度,同时指向③用药与④生存。若重症者更常用药,直接比较用药与未用药两组,就可能混入两组原本的病情差异。
- ③medicine 表示用药,指向④的黑色箭头表示假定用药会影响生存。病情通向用药和生存的另外两条箭头,说明这一作用不能只靠两组的观测均值差来判断。
- ④survived 表示是否生存;上表统计的是“死亡”,不能把两者数值混用。图中黑色箭头表达假定的因果方向,画出箭头本身不能证明这些假设成立,蓝色引线仅用于中文标注。
图源:Matheus Facure, Causal Inference for the Brave and True,第 4 章,MIT 许可。此版本添加中文辅助标注;查看原始图片。
假设病情在治疗开始前就已确定,病情已包含需要控制的全部混杂因素,而且每种病情下两种方案都有机会被采用,就应先在相同病情下比较死亡率,再用同一目标人群的病情比例加权。如果这些假设成立,表中的 B 在每种病情下死亡率都较低,按相同人群构成加权后也会更低。但这些假设需要额外依据,光看表格无法确认。
再看方案选择影响病情的情况。比如方案 B 药效好但稀缺,患者本来可以直接用药,却因为坚持等方案 B 而耽误了治疗,导致病情恶化;方案 A 没有这个问题。这里的关系是“方案选择 → 等待中的病情 → 死亡”,方案也可能直接影响死亡;与前一种情况相比,病情位于方案选择之后。
这时我们比较的处理是“选择并等待某方案”的整套做法,病情可能在等待中变化,属于选择之后的中间结果。若方案分配没有其他混杂,总体死亡率才可用于比较这两个策略的总效应;按病情分层反而会挡住“等待 → 病情恶化 → 死亡”这部分影响。在这个假设下,表中的 A 更好。这里的结论不是医疗建议,而是说明:即使统计表相同,病情究竟影响治疗选择,还是被治疗选择影响,也会改变我们应该怎样比较。
再用一组简化的假设数据验算这种反转。假设 A 组轻症 90 人、死亡率 10%,重症 10 人、死亡率 40%;B 组轻症 10 人、死亡率 0%,重症 90 人、死亡率 30%。B 在两层都低 10 个百分点,但总体死亡率 A 为 ,B 为 。若两组都按“轻症、重症各一半”的同一人群构成计算,则 A 为 25%,B 为 15%。两种算法的权重不同,因此可能得到相反的排序。应采用哪一种比较方式,仍取决于病情是处理前的混杂变量,还是处理后的变量。
1.2 相关性不足以证明因果关系
这一节要区分的是:。“Nicolas Cage and Pool Drownings”就是一个例子,讨论的是演员尼古拉斯·凯奇出演电影的次数与游泳溺水次数的相关性。
有人发现,把他出演电影的次数和游泳溺水次数拿来计算线性相关性,结果可能显示高度相关。但相关系数再高,也没有说明凯奇出演电影会导致溺水。要作出因果判断,还需要解释和证据,不能只看两项统计量一起涨跌。
再看一个例子:有人发现,晚上很晚回来、穿着鞋子睡觉的人,第二天早上醒来会头痛。这两件事确实一起出现,人们会说它们相关。一个可能的共同原因是饮酒:喝醉后倒头就睡,没来得及脱鞋,第二天也更容易头痛。这个共同影响两件事的因素称为混杂变量(confounder)。
在这个解释中,饮酒是同时影响“穿鞋睡觉”和“头痛”的共同原因,这条非因果路径造成的关联称为混杂关联(confounding association)。研究穿鞋本身的效果时,需要处理这类混杂;要调整哪些变量取决于因果关系,把所有能看到的变量都放进回归未必有用。
2. 潜在结果与处理效应
课程第二章先定义“处理带来了多少变化”,再讨论怎样从实际观察到的数据算出这个变化。
2.1 同一个人的两种潜在结果
假设有个人心情不太好,有人想送他一只狗。接受这只狗后,他可能会开心起来;如果拒绝了,他会继续不高兴吗?反过来,如果他接受了狗却仍不开心,我们又怎么知道,不送他这只狗,他会不会更开心?
2.1.1 潜在结果的定义
对同一个人,我们可以分别定义接受与不接受处理时的潜在结果,它们的数值可能相同。用 表示指定处理 下的潜在结果,用 表示实际观察到的结果;在一致性假设下,。
在上面的例子中, 表示高兴, 表示不高兴。
用随机变量 表示是否接受这一处理。 表示接受这只狗, 表示不接受。
用 表示接受这只狗后的潜在结果, 表示不接受时的潜在结果。
2.1.2 个体处理效应
例如某人的 、,表示他接受狗会高兴、不接受不会高兴,个体效应为 。如果两种情况下都高兴,则效应为 0。这些是帮助定义概念的假设值,实际数据里通常无法同时填满同一个人的两列。
面对多个个体时,用 表示个体 的处理效应,即同一个人在两种处理下的结果之差。
NOTE接受这只狗后,可以观察 ;不接受时,可以观察 。但不能同时观察到 和 。这就是因果推断的基本问题(Fundamental Problem of Causal Inference)。
2.2 一群人平均受到了多大影响
每个人可能存在差异。平均处理效应(ATE)在一个明确的目标人群中,对每个人的两种潜在结果之差取平均:
同一个人的两种潜在结果不能同时观测,因此很难直接按定义计算平均处理效应。下面把 Brady Neal 教材表 2.1 的缺失数据例子排成文字表,问号表示无法观测:
| 个体 | 实际处理 | 观测 | |||
|---|---|---|---|---|---|
| 1 | 0 | 0 | ? | 0 | ? |
| 2 | 1 | 1 | 1 | ? | ? |
| 3 | 1 | 0 | 0 | ? | ? |
| 4 | 0 | 0 | ? | 0 | ? |
| 5 | 0 | 1 | ? | 1 | ? |
| 6 | 1 | 1 | 1 | ? | ? |
对个体 采取处理 0 时,只能观察到 ,观察不到 。也就是说,期望的线性拆分始终成立,但把总体均值换成两个观察组的均值,一般不成立:
实际接受处理 0 的人只是总体的一部分,他们的结果不一定能代表总体。 问的是:如果目标总体中的每个人都接受处理 1,平均结果会是多少?它与只观察实际选择了处理 1 的人不同。
2.2.1 可忽略性与可交换性
要让两组的观测均值之差等于平均处理效应,需要处理分配满足下面的独立性假设。
Brady Neal 教材中的假设 2.1:可忽略性 / 可交换性(Ignorability / Exchangeability)
NOTE
可忽略性要求处理分配 与两种潜在结果独立。这一名称并不意味着缺失的反事实数据可以忽视。再结合一致性(实际接受 时,观测结果 )和正值性(总体中两种处理的概率都大于 0,即 ),就可以把潜在结果的均值换成观测组的均值:
对每个人都有定义,也包括实际未接受处理的人,其定义并不限于 的人群。上面的独立性假设意味着,实际接受处理组中的 分布能够代表总体中的 分布,因而可以用前者的均值代替后者。
符号 在这里表示统计独立,也常写为 。这个假设也叫 Exchangeability:例如 ,对 同理。也就是说,对同一种处理 ,实际处理组与对照组中的 具有相同的总体分布;这一条件不要求每个人都相同,也不要求结果只能由处理决定。随机分配可支持该假设,但有限样本中的两组均值仍可能因随机误差而不同。
Brady Neal 教材中的定义 2.1:可识别性(Identifiability)
NOTE如果在给定假设下,因果量(例如 )能够由观测数据的统计量(例如 )唯一确定,就称这个因果量是可识别的。
可识别性要回答的是:如果假设成立,而且我们已经知道完整的观测分布,能否唯一算出想要的因果量?可以先想象一个理想情况:数据无限多,观测分布已经没有估计误差。这里得到的观察均值公式就是一个例子。实际只有有限样本时,怎样估计这个值、误差有多大,还需要用统计方法解决。
2.2.2 条件可交换性与无混杂假设
在观察性研究中,接受不同处理的人往往在病情等背景条件上就有差异,无条件的可交换性未必成立。此时可以考虑在相同背景条件的人群中比较两种处理,假设这些条件已经解释了处理选择与潜在结果之间的关联。
Brady Neal 教材中的假设 2.2:条件可交换性 / 无混杂性(Conditional Exchangeability / Unconfoundedness)
NOTE
条件可交换性的意思是:在相同 的人群内部,处理分配与潜在结果独立。例如先分别比较轻症患者、重症患者,再把各层结果合起来。这里“控制”是分析时分层或调整,并没有真的改变患者病情; 仍可以影响结果,只是不再让不同处理组的比较混入病情构成差异。选择了一组 也不自动保证假设成立。
于是有:
上式是在同一 层内比较,最后一行还使用了一致性 。要得到整个人群的 ATE,还需对各层按目标人群的比例求平均。这一步称为全期望公式:先求组内平均,再按组的大小求总体平均。因此:
条件可交换性(Assumption 2.2)是因果推断的核心假设之一。在这里讨论的潜在结果框架中,常见的相关名称有 unconfoundedness、conditional ignorability、no unobserved confounding、selection on observables 和 no omitted variable bias。Brady Neal 的教材经常使用 unconfoundedness 这个名称;阅读时要结合上下文确认所指的具体假设。
Brady Neal 教材中的定理 2.1(调整公式):在无混杂性、正值性、一致性和无干扰假设下,可以通过下式识别平均处理效应:
NOTE
这个识别公式依赖于已控制足够的处理前混杂变量,还要求各类 中接受或不接受处理的概率都大于 0。若遗漏了同时影响处理选择和结果的变量,仍会存在“混杂变量 处理”和“混杂变量 结果”两条路径,观察组均值之差就不能直接解释为因果效应。
将最后一个式子写成离散分层形式,更容易看出如何计算:
内层两个均值从各处理组的同一层估计;外层始终用同一个目标人群的 。例如目标人群有 60% 轻症、40% 重症,两层的处理效应为 、,则 ATE 为 。若 表示死亡,负号表示死亡概率平均减少 8 个百分点;若 表示高兴,同样的负号含义就不同。
若某一层从来没人接受 ,就无法直接从数据估计该层的对照均值,这正是 positivity(正值性/重叠)假设要避免的情况。无干扰(no interference)则要求一个人的结果不受其他人的处理影响,例如传染病干预中可能不成立。满足这些假设时,识别公式给出了计算平均效应的方法;假设是否适用于研究对象,仍需另外判断。
最后把“从定义推公式”和“拿数据算数值”分开看:
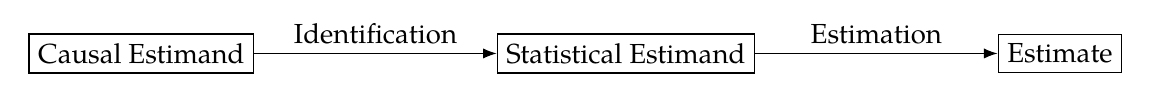
- 左侧 Causal Estimand 是想知道的因果量,例如 ATE。
- 第一根箭头 Identification(识别)靠前面的因果假设,把潜在结果目标改写成可观测分布的表达式。
- 第二根箭头 Estimation(估计)才用有限样本或模型算出右侧 Estimate。样本再多,也不能自动补上第一根箭头所需的假设。
图源:Brady Neal,Introduction to Causal Inference,Figure 2.5。局部引用原图,文字和箭头未改动;版权归作者,教材未明确标注开放改编许可。
如果关心的不只是整个目标人群,而是「已经接受处理的人」或「某一类背景的人」,可以接着读因果推断(二):ITE、ATE、ATT 和 CATE。第二篇沿用潜在结果框架,用课程辅导的例子比较各个指标对应的人群。
参考资料
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。