0. 怎样学会选择回报更高的动作
打游戏时,有些操作当下看不出好坏,要等到一局结束才知道有没有用。强化学习也要解决类似的问题:怎样根据后续的奖励,判断之前的动作值不值得做?一种方法是直接调整选动作的策略;另一种是先估计状态和动作的价值,再据此选择。本文沿着这两条思路,介绍 Policy Gradient、PPO、Q-Learning、TD(λ) 和 GAE。
阅读本文需要了解期望、条件概率、求导和梯度下降,但不要求有强化学习基础。第一次读,可以先看 1.2–1.3、2.1–2.2.3、3.1–3.2 和 3.4–3.5.4,弄清回报、策略梯度、价值和一步 TD。接着想了解 PPO,可以读 2.3、2.3.1 和 2.4;想理解 GAE,可以结合 3.5.7 和 3.5.10。第 4 节有可以运行的例子。
第 2.2.4 节的折扣分布、2.3.2 的精确轨迹校正、3.3 的完整 DP 路线,以及 3.5.8–3.5.9 的 trace 等价证明,可以第二遍再读。
本文是 LLM 知识体系导航 中的通用强化学习专题,可以为理解对齐方法打基础。本文把游戏等环境中的状态和动作用作例子,重点讲策略梯度、PPO 和价值学习;LLM 对齐入门则把同样的 PPO 和 GAE 用到逐 token 生成,并介绍奖励模型、参考模型和 DPO。如果你在学习 SFT,不必先读完所有 DP 和 TD 推导。
1. 策略、价值与回报
1.1 直接学策略,还是先学会估值
- Policy Based:直接学习策略 ,它给出各个动作的概率。Actor 是这个策略模型,不保证每次都选最优动作,训练时通常还需要探索。
- Value Based:学习状态价值 或动作价值 ,再根据估值选择动作。它不一定有独立的 Actor 网络。
- Actor–Critic:Actor 学策略,Critic 提供价值估计,帮助判断动作好不好。这两种角色可以使用不同网络,也可以共享部分参数。
相关推导参见:David Silver’s RL Course。
“深度”通常指用神经网络表示策略或价值函数。强化学习里的目标、回报和 Bellman 方程本身并不依赖神经网络:问题较小时,我们可以直接用表格记录每个状态的数值。先理解怎么更新表格,再看神经网络怎样近似这些数值,会更直观。
1.2 状态、动作、奖励与轨迹
以游戏为例,observation 是你看到的画面,action 是移动或开火,reward 是行动后得到的即时分数。一帧画面不一定包含完整的状态(state):比如,要判断物体的速度,可能需要结合前后两帧。下文假设 包含了预测未来所需的信息,也就是满足 Markov 性;如果只能观察到部分信息,可能需要用历史记录、堆叠帧或记忆模型。
本文从 开始计数:在状态 下选择动作 ,环境返回奖励 ,并进入下一状态 。有些教材把同一个奖励写成 ,对照时留意下标即可。
下图展示了这个过程:Agent 是选择动作的智能体,Environment 是接收动作并返回反馈的环境。
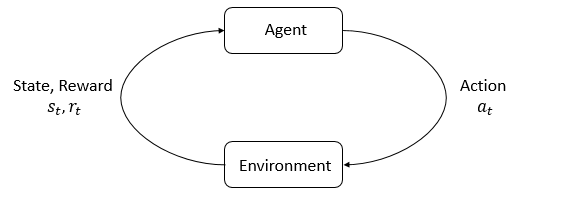
来源:OpenAI Spinning Up:强化学习入门;原图,MIT 许可及版权声明。此处保留原图,阅读说明见下文。
- 上方 Agent:根据当前可用状态选择动作;策略描述怎样选择,图中没有展开策略的参数更新。
- 右侧 Action:动作由智能体传给环境,箭头终点是下方 Environment。
- 下方 Environment 与左侧反馈:环境执行动作后返回状态和奖励,左侧箭头指回智能体;奖励是本次反馈,不能直接当成未来累计回报。
注意图和本文的下标约定不同:原图把本轮收到的反馈写成 ,没有展开相邻时间步之间的关系;本文把动作 之后收到的奖励记为 ,新状态记为 。对照下面的轨迹时,要先看清奖励是在哪次动作之后收到的。
一局完整的游戏是一个 episode(回合),这一局中的经历构成一条 trajectory(轨迹):
这条轨迹包含 次动作。采集器也可能只取其中一段,称为 rollout;采样片段结束,不代表任务已经结束。
例如一局只有两步:先在路口选择左转,得到 ,再走到终点,得到 。第一步即时奖励为负,不代表它是坏动作,因为它可能把我们带向终点。这就是要看后续回报,而不只看当前奖励的原因。
1.3 把后续奖励加起来,得到折扣回报
先假设一局最多有 步。把每一步奖励按时间折扣后加起来,就得到整局的回报 ;我们的目标 是让这个回报的期望尽可能大:
是策略网络的全部可训练参数, 是当前策略产生轨迹 的概率。期望 表示对各种可能经历按概率加权平均;一局走得好只是一个样本, 衡量重复很多局的平均表现。
是从这一局的起点算出的折扣回报。 决定较晚收到的奖励占多大权重;奖励本身可以为正,也可以为负。有限时域且奖励可积时, 可以取 1。持续任务通常取 ,并要求奖励有界,以保证回报有限。
如果只想看第 步之后能得到多少回报,可以从这一步重新开始计算折扣,记为 :
在上面的两步例子里,若 ,则 、。程序中可以从后往前累加,而不必对每个时间步重新计算整段和。
因此 ,但一般 。后文分别使用这两个符号,以区分整段回报与从某一步开始的回报。
有限时域中,同一位置在“还剩十步”和“只剩一步”时价值不同。严格写法是 、、。下文策略省略显式的 时,可理解为已把时间并入状态;后面的平稳 Bellman 方程也采用这一约定。若不把时间并入状态,有限时域的方程必须保留 与 。
2. 基于策略的方法
2.1 让好动作更常见,坏动作更少见
Actor 的目标是提高 。采到的动作是否值得鼓励,要由它带来的回报决定,不能一律视为正确标签。直觉上,在相同处境中,带来较好后续结果的动作应该变得更常见;较差的动作应该变得更少见。
难点在于环境通常不可微:我们没法直接对游戏引擎求导。因此,下面换一个方向,对“当前策略产生这段经历的概率”求导。
2.2 策略梯度的推导
2.2.1 轨迹概率与梯度
先看只有一个状态、一次动作的简化游戏。动作 A 得 2 分,B 得 0 分,策略以 的概率选 A。这里 是 sigmoid,它把任意实数参数变成 0 到 1 之间的概率,且 。期望回报为 ,直接求导得 。在 时梯度为 :沿正方向更新 ,会增加选 A 的概率。
选择 A 时,对数概率的导数为 ;选择 B 时则为 。
如果只能玩游戏采样,而不知道每个动作的奖励表,可以用“本次回报 × 本次动作的对数概率梯度”:采到 A 时为 ,采到 B 时为 。两者各半,平均仍为 。这个单步例子体现了下面轨迹推导的基本思路:单次估计会波动,但其平均值可以给出正确的梯度方向。
表示对所有参数分别求偏导,得到一个向量。我们的目标是让回报变大,因此沿梯度方向更新;如果优化器只能最小化目标,就先给目标加一个负号。
设初始分布为 ,环境转移与奖励分布为 。假设它们不随 改变,则:
这个乘积来自条件概率的链式分解:先抽初始状态,再按策略抽动作,再由环境产生奖励和下一状态,如此重复。 就是连乘符号。例如两步动作概率为 、,两次所见环境结果的条件概率为 、,若初始状态固定,则该轨迹概率为 。
策略会通过动作改变未来状态的分布;“环境不含参数 ”不等于“状态与策略无关”。求给定轨迹的对数概率时,先取 log,再求梯度:
接下来用到一个对数求导公式:。两边乘以 ,得到 。借助它,我们可以把概率的导数写成采样后的平均值,不必枚举所有轨迹。
假设可交换求导与期望、策略可微且在需要的支撑集上概率为正,利用 得到:
离散情况写作求和;连续状态或动作相应使用密度和积分。该推导没有要求知道环境的导数。
2.2.2 因果性:去掉动作发生之前的奖励
第 步的动作不可能改变之前已经收到的奖励 。要从梯度公式里去掉这些过去的奖励,可以先看一个性质:给定动作发生前的历史,策略 score 的条件期望为零。
这里的 score 指 ,不是奖励分数。上式等于零,是因为所有动作的概率之和 ,所以它的梯度 。给定历史后,过去的奖励已经确定,可以从对当前动作的期望中提出来。
因此,过去的奖励乘以 score 后,对所有轨迹取期望,结果是零。公式里只需保留从第 步开始的奖励;原目标中的折扣仍然是 :
外面的 不能无条件丢掉。 内部 将折扣原点移到 ,所以需要外部系数把它换回整段目标的原点。例如 、,未来两次奖励是 ,则 ;它在上述梯度中的回报权重是 。
2.2.3 减去 baseline,判断动作比平均表现好多少
同一个动作带来的回报,还会受到环境中的随机变化和后续动作的影响。为了减小梯度估计的波动,可以减去一个参考值 ,称为 baseline。这个参考值不能依赖当前选了哪个动作:
Baseline 不是为了纠正“奖励一定为正”,也不是任取一个 baseline 都能降低方差。证明要求 baseline 在给定状态和时间后不依赖本次动作;严格讨论无偏估计时,可使用采样前固定的 Critic 或独立数据拟合的 baseline。把含本条样本的 batch 平均回报直接作 baseline,就需要另外检查是否满足独立性条件。
对当前策略独立采集 条完整轨迹,REINFORCE 的一个 batch 估计是:
是采样估计,满足条件时其期望等于真实梯度;单个有限 batch 不等于期望。若 episode 提前终止,可将之后视作吸收状态、零奖励并补齐到 ;实现也可以直接对各条轨迹的真实长度求和。除以轨迹数 与除以总 token/步数是不同的归一化,特别是长度可变时要说明采用哪一种。
一个自然的 baseline 是状态价值:
衡量的是“现在选这个动作,之后按策略继续”的平均回报; 衡量的是“现在和之后都按策略选动作”的平均回报。两者相减得到 advantage(优势),表示这个动作比当前策略的平均选择好多少。一次采样得到的 可以用来估计 ,但它是随机样本,不能说每次都等于条件期望。
例如某状态下策略以 75%、25% 的概率选两个动作,动作价值分别为 4、0,则 ,两个 advantage 分别为 1、−3。它们按当前策略加权后恰为零。价值 0 的动作不是因为“奖励为负”才被抑制,而是因为比当前平均选择差。
使用精确的 advantage 可以将梯度写为:
Actor–Critic 用网络估计这些值;估计不准确、bootstrap 或截断都可能引入额外偏差。实际用 作 actor loss 时, 在这个策略梯度项中应停止梯度,Critic 通过单独的价值损失学习。
2.2.4 为什么有些策略梯度公式没有外层折扣
有两种常见情况:一是 ,折扣系数本身就是 1;二是折扣已经放进了采样分布。先定义:
这是把时间也包含在内的、归一化后的折扣状态访问分布。于是同一梯度可以写成:
这条公式由前面的完整轨迹推导而来,已经考虑了状态分布随参数变化的情况。对于无限时域折扣任务,常见的归一化因子是 。但如果从 rollout 中均匀抽取时间步,采样分布就不是上面的 ,不能用这个公式作为省略折扣权重的理由。
一些算法用折扣优势近似未折扣目标的梯度,采用了不同的目标与估计方式。例如 GAE 原论文第 2 节 明确从未折扣任务出发,把 引入为估计参数。它与本篇一开始定义的 应加以区分。
2.3 怎样用旧策略采集的数据
采集数据的策略和正在学习的策略,是否必须相同?On-policy / off-policy 说的就是这个区别。另一组词 online / offline 则关注训练时是否继续与环境交互。两者说的是不同的事:既可以一边与环境交互,一边使用 off-policy 方法,也可以只用固定的历史数据训练。
2.3.1 重要性采样的期望与方差
假设我们手里只有从分布 抽出的样本,却想知道分布 下的平均结果。重要性采样的做法是给每个样本乘上概率比 :
例如两种结果的 值为 ,目标概率 ,采样概率 。直接在 下平均得到 2;乘比值 后,平均为 ,正好等于 下的 。比值改变每个样本的贡献,不会改变已经抽到的样本。
前提是:只要目标分布中某个事件可能发生,采样分布也必须有机会采到它,即 时 (更一般地,要求 对 绝对连续),而且相关期望要存在。完全采不到的事件,无法靠加权补回来。
重要性采样保持了期望,但会改变方差。若二阶矩存在:
当重要样本在 下极罕见时,概率比可能很大,估计方差甚至可能无穷。分布接近有时有助于控制方差,但不能普遍保证这一点。
2.3.2 整条轨迹比与单步概率比
设行为策略为 ,目标策略为 ,初始分布和环境相同。环境项抵消后,整条轨迹的比值为:
因此,一个精确但可能高方差的梯度表达式是:
不能直接把整条轨迹的比值换成某一步的 。单步概率比只校正当前状态下选动作的概率:它没有校正之前的动作怎样影响当前状态,也没有校正之后的动作怎样影响回报。因为更换策略也会改变访问各状态的概率,精确的 off-policy 推导可能需要轨迹比、逐决策的连乘比或状态分布校正。
2.4 PPO 怎样限制一次更新的幅度
一批数据是用旧策略采集的,主要能告诉我们旧策略附近该往哪个方向改进。如果反复用这批数据更新,新策略可能离旧策略越来越远,这批数据的指导作用也会减弱。PPO 会限制对同一批数据的过度优化,避免策略在一次更新中偏离旧策略太远。PPO 原论文 讨论了 KL penalty 与 clipping 两种形式。
PPO 使用一个局部替代目标(surrogate):用旧策略采到的状态和动作,指导旧策略附近的更新。固定旧策略 和对应的优势估计后,定义:
旧策略的采样分布和优势保持固定。当 时,,且 ,所以此处替代目标的梯度与前面的 一致。但离开旧策略后,替代目标不再是对 的精确改写,因此还需要控制更新幅度。
本文按以下方式对 batch 中的样本加权:
它沿用第 2.2 节的轨迹平均。实现中也常见对时间步或小批次直接取平均的写法,这样算出的样本权重可能与这里不同,比较实现时要先对齐目标。
例如,LLM 对齐篇的 PPO 损失对有效回答 token 取平均,并取负号交给最小化优化器;这里则先把每条轨迹的各步加总,再对轨迹取平均。两篇都可以处理长度不同的回答,但分母的含义不同。对同一批数据、 且各位置使用同一裁剪项时,两种写法相差一个整批平均轨迹长度的倍数;换一批长度不同的数据,这个倍数也可能变化。对每条回答先取 token 均值再对回答取均值,又是另一种加权方式。
KL penalty 形式可写为:
上的帽子表示从数据估出来的优势, 控制改动策略的代价; 则将在下面控制 clip 的宽度。旧策略若给采到的动作概率 ,新策略给 ,就有 :该动作的概率相对增加 50%,不是增加 0.5 个百分点。
KL 比较的是同一状态下,新旧策略各自给动作分配的概率,而不是直接比较网络参数。KL 的方向及其与交叉熵的关系可参见 KL 散度。
这里的 KL 比较的是本轮采样用的旧策略与正在更新的新策略;LLM 对齐篇中的 KL 则比较当前策略与整个训练阶段固定的参考模型,作用是限制相对参考行为的偏移。两处都用 表示系数,但它们属于不同的惩罚项,不必取相同值,也不应把两个 KL 混为一谈。
截断操作 的意思是: 小于下限 时取 ,大于上限 时取 ,在范围内则保留原值。更常见的 PPO-Clip 最大化下面的目标:
- :该动作值得鼓励;当概率比大于 时,单个样本的目标不再因继续增加该比值而提高。
- :该动作值得抑制;当概率比小于 时,单个样本的目标不再因继续降低该比值而提高。
- 概率比朝降低该样本目标值的方向变化时, 仍保留惩罚,不会把两边一律截成平坦区域。
例如 、、,该项为 ;若 、,该项为 。
Clip 修改的是目标函数,没有把真实概率比硬限制在区间内。 参数共享、其他样本及价值/熵损失的梯度都可能让某些比值越界;它也不提供严格的 KL 上界。实现可以另外监控 KL、限制训练轮数或使用提前停止。
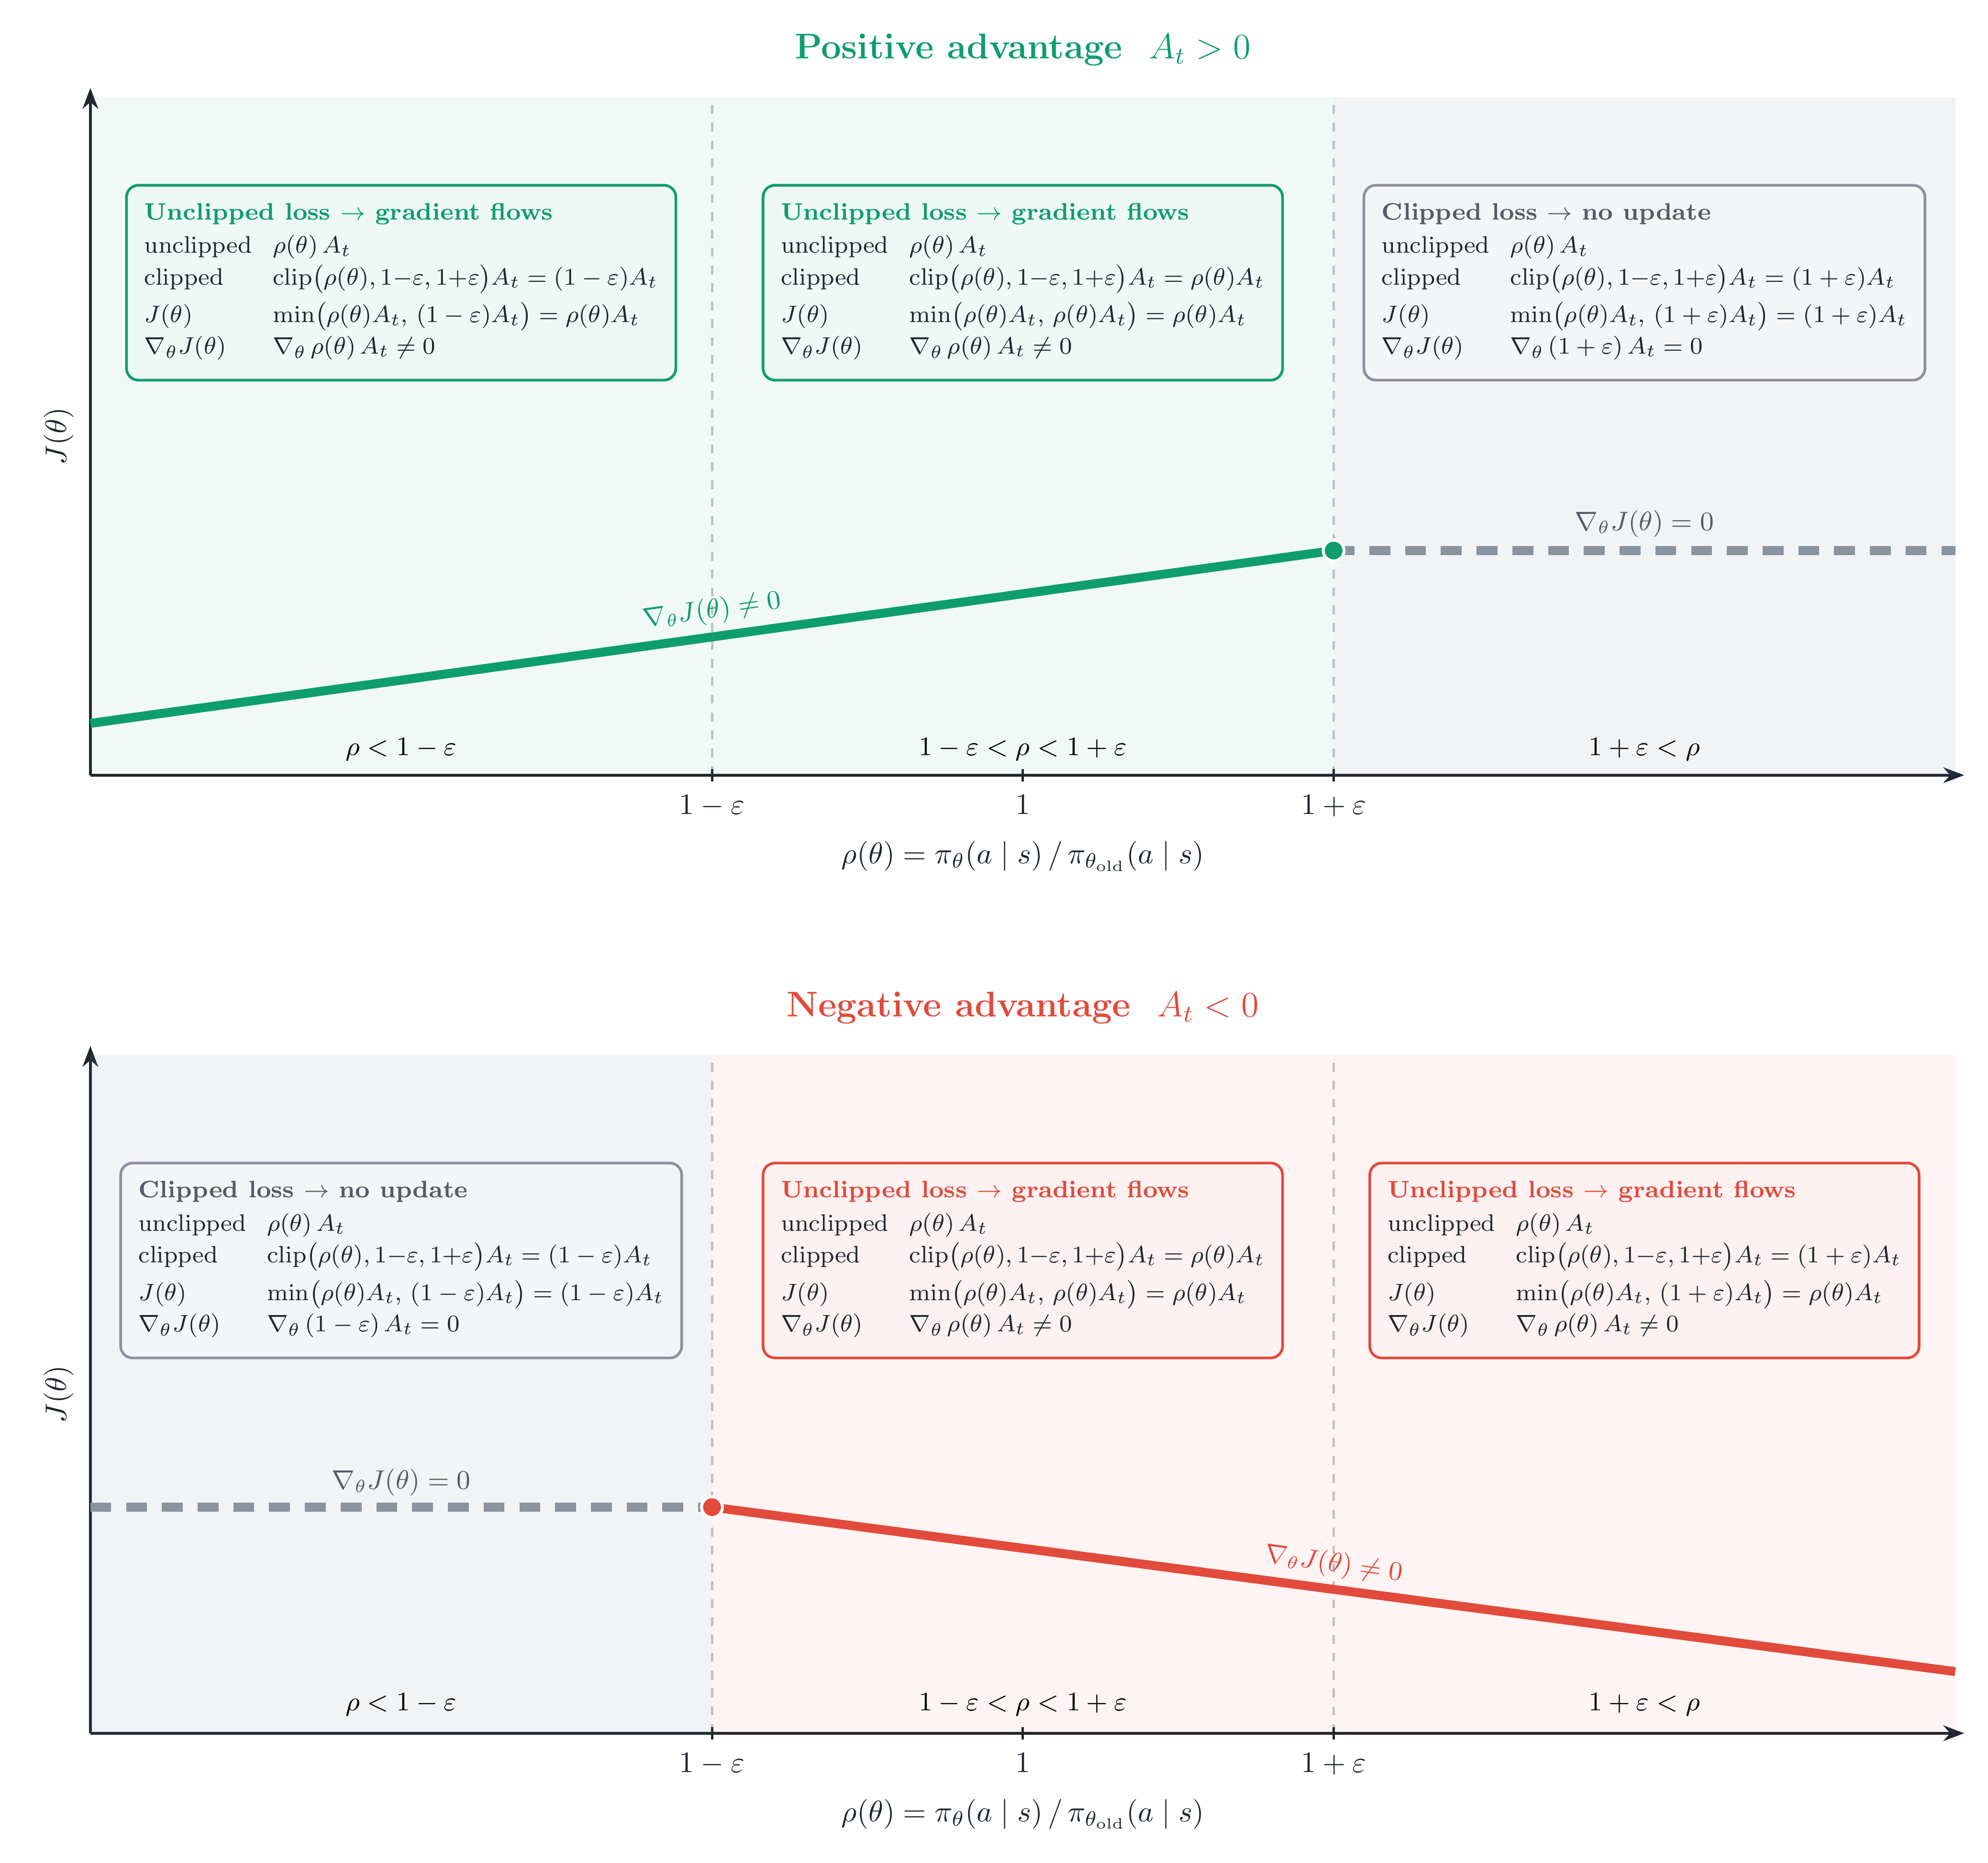
来源:Nathan Lambert,RLHF Book:Policy Gradients,PPO objective 图;原图未改动,CC BY-NC-SA 4.0 许可。
把图中的 看成单个样本的裁剪目标项,不是整批训练的总回报;横轴 就是上文的新旧概率比。
- 上半图,正优势:绿色斜线随概率比增加而升高,越过 后变成灰色平台;继续鼓励这个动作不再提高该项。
- 下半图,负优势:往左降低概率比会提高目标,但低于 后进入平台;往右反而使目标更差,红线因此继续下降。
- 只看两个平台:右上、左下才是该样本停止贡献策略梯度的区域。图中的 “no update” 指这一项,不代表整个网络停止更新。
一次典型的更新过程是:先用旧策略采样,固定旧 log-prob 和优势;再用这批数据做有限次 minibatch 更新,之后重新采样。Critic 通过回报目标学习,优势可以用后文的 GAE 估计。Replay buffer(经验回放池)会保存之前采到的“状态、动作、奖励、下一状态、是否终止”,供训练时抽取。PPO 通常复用最近采集的一批数据,不能无限制地使用任意陈旧的回放数据。
3. 基于价值的方法
3.1 价值函数解决什么问题
第 2 节介绍的 、、 都是标量,单位与未来回报相同。如果有 个离散动作,网络可以一次输出长度为 的 Q 向量;向量里的每个分量,才是一个动作对应的价值。
MDP(Markov Decision Process,马尔可夫决策过程)用状态、动作、状态转移、奖励和折扣来描述决策问题。这里沿用第 1.2 节的 Markov 假设;“平稳”指转移和奖励的规律不随时间改变。在平稳的折扣 MDP 中,省略时间后:
这里对环境的随机结果取了期望,并不是每一条实际转移都满足同一个等式。最优价值定义为:
以下最优性与收敛讨论采用有限状态/动作、奖励有界、 的标准表格型条件。有限时域则通过 反向计算;持续任务取 时,需要另行分析收敛条件。
3.2 Bellman 方程
3.2.1 固定策略:对动作取平均
将回报拆成“本步奖励 + 后续回报”,得到:
双重求和有两层随机性:外层按策略概率平均“选哪个动作”,内层按环境概率平均“选完后发生什么”。例如一个状态只有一个动作,以 50% 概率直接终止并获得 2 分,以 50% 概率获得 0 分并进入价值为 4 的状态,,则当前价值为 。这也说明“价值等于期望”不代表每次都拿到 2.8 分。
这是任意给定策略的 Bellman expectation equation,不只属于最优策略。终止状态的后续价值设为零。
3.2.2 最优策略:对动作取最大价值
最优决策不再按固定策略平均,而是选择价值最大的动作:
第二行的 不能省略。还要区分: 返回一个分数, 返回一个动作。Bellman 方程中与奖励相加的是折扣后的价值分数,而非动作编号。
有限时域的对应式是 ,以 结束。
3.3 动态规划方法
动态规划(DP)假设我们已经知道环境模型,因此可以对所有可能的下一状态和奖励求期望。DP 不要求使用神经网络。
3.3.1 策略评估:计算当前策略能拿到多少回报
固定 ,使用第 轮的估值计算第 轮:
这一步反复更新的是价值估计,策略本身保持不变。在上面所说的折扣表格条件下,这个算子是压缩映射,迭代最终收敛到唯一的 。
3.3.2 策略改进:改选估值更高的动作
已知精确 后,让新策略在每个状态选择一个价值最大的动作:
由策略改进定理,。这次贪心改进不等于立刻找到了全局最优策略;仍要评估新策略再改进。如果策略已对自身的精确价值贪心,满足 Bellman 最优性条件,才可得到最优性结论。使用近似 Critic 时也不能直接保证每次改进都不退步。
3.3.3 策略迭代:反复评估和改进
反复进行“评估当前策略 → 对当前价值作贪心改进”。固定并列最大值的选择规则,可以避免只在等价动作间来回切换。
相关推导参见:Sutton 与 Barto 教材。评估和改进不必每次都完全收敛,二者交替作用的思路称为 Generalized Policy Iteration。
3.3.4 价值迭代:每次更新都取最大价值
Value Iteration 每轮直接使用最优 Bellman 算子:
它把一次价值更新与贪心选择合在一起。在标准折扣表格条件下收敛到 ,再由该价值提取贪心策略。
相关推导参见:Sutton 与 Barto 教材。
3.3.5 不知道环境模型时怎么办
DP 要用环境模型计算各种后续情况的期望;状态太多或不知道模型时,这一步可能很难做。接下来的 MC 和 TD 可以直接从实际采到的经历中学习。
相关推导参见:Monte Carlo Methods 课程。
3.4 Monte Carlo 方法
3.4.1 从完整回报估计状态价值
MC 的想法是:先把这一局走完,再用实际观察到的折扣回报 更新估值。无需知道环境模型,也无需用另一个价值估计补齐后半段。
对某状态的第 次回报样本 ,样本均值可以递推为:
或者用固定步长 ,得到指数加权的估计。First-visit MC 每局对一个状态只用首次访问;every-visit MC 使用每次访问。无需从每个状态专门启动一局,可以从同一完整 episode 中取出访问该状态后的回报。
3.4.2 动作价值与探索
同样可以用访问 后的 更新 ,再改善策略。只选当前最高估值的动作会漏掉尚未尝试的动作。
一个简单办法是 -greedy:以概率 选择贪心动作,以概率 在全部动作中均匀采样。若有 个动作且唯一贪心动作,它的总概率是 ,其余动作各为 。 控制探索,不是 PPO 的 clip 超参数;两处虽惯用同一字母,含义不同。
相关推导参见:Sutton 与 Barto 教材。
3.5 时序差分方法
3.5.1 从完整回报改成一步目标
MC 要等一局结束,才能拿到完整回报。TD 不必等那么久:走一步、收到 后,就用当前对下一状态的价值估计补上未来的部分。这种用已有估计来更新估计的做法叫 bootstrap(自举)。
这些更新都可以理解为让旧估计向目标靠近一小步。区别在于目标:MC 使用实际回报 ;TD(0) 使用 。
3.5.2 TD 状态价值预测
对于固定策略,Bellman 方程描述的是条件期望:
一次随机转移不一定满足 。定义 表示这次转移真正终止,否则为零,则采样 TD error 与更新是:
例如当前 ,收到奖励 1,下一状态估值为 4,未终止且 。TD 目标为 ,误差为 ;取步长 ,更新后为 。它只向目标移动 10%,并没有把一次随机目标当成真值全部覆盖。
奖励是“本次观察到的数值”,不等于奖励机制没有随机性。与 MC 相比,TD 往往更早更新、方差较小,但引入 bootstrap 依赖;选择方法时还需结合任务特点,更新更早并不意味着效果总是更好。
对神经网络 ,可最小化 ,其中 在这次反向传播中停止梯度, 可表示固定快照。若连目标一侧也一同求导,就不是这里的标准 semi-gradient TD 更新。
相关推导参见:DRL Lecture 3: Q-learning。有限数据、不同更新目标和函数近似都可能让二者给出不同估计。
3.5.3 SARSA:同策略 TD 控制
SARSA 用当前行为策略实际选出的下一动作 构造目标:
SARSA 这个名字来自五个量:State、Action、Reward、下一 State、下一 Action。它是 on-policy 方法:计算目标和实际采样动作使用同一个策略,例如同一个 -greedy 策略。如果任务真正终止,就不需要再采样 ,目标只剩 。
相关推导参见:Sutton 与 Barto 教材。
3.5.4 Q-Learning、DQN 与 Double DQN
Q-Learning 仍可用带探索的行为策略采样,但下一步目标使用当前 Q 的贪心价值:
这是 off-policy:目标中的贪心策略与采样行为策略可以不同。这里的贪心策略只是相对于当前估值,还不能直接称为已知的最优 。表格型收敛到 需要充分访问各状态动作、合适的递减步长等条件;神经网络版本没有同样的一般收敛保证。
相关推导参见:DRL Lecture 3: Q-learning。
DQN 用 online 网络 学习,用更新较慢的 target 网络 提供目标,并从 replay buffer(保存旧转移的经验回放池)抽取一小批“状态、动作、奖励、下一状态、是否终止”样本:
这里每批包含 条状态转移样本;除了均方误差,DQN 也常用 Huber loss。交互时通常需要 -greedy 等探索,不能只靠永远取 argmax 获取所有经验。每隔若干步复制 ,或采用另行指定的缓慢更新方式。
如果用同一组有误差的估值,既挑出价值最大的动作,又给这个动作打分,max 操作就容易选中被高估的值。Double DQN 把选动作和给动作打分分成两步:
Online 网络选动作,target 网络给该动作一个标量分数。 例如下一状态的 online Q 为 、target Q 为 ,、 且未终止:DQN 目标是 ;Double DQN 先选第一个动作,再得到 。真正终止时两者都等于 。
这有助于缓解过估计,不表示 target 网络总会高估,也不保证 Double DQN 的每个估计都无偏。两个 Q 网络也不等于必须存在两个独立 Actor。
3.5.5 为什么 SARSA 可能选一条更远离悬崖的路
在 cliff-walking 中,如果一直保留随机探索,SARSA 的目标会把未来探索时掉下悬崖的风险计入,往往学到离悬崖更远的路线。Q-Learning 的目标评估未来按贪心动作行动的价值,即使采样时还在探索,也可能偏好贴边的短路线。
相关推导参见:Sutton 与 Barto 教材。比较这两种方法时,需要区分持续探索下的实际回报与关闭探索后贪心执行的回报,因此不能仅凭这个例子判定 SARSA 总是次优。
3.5.6 DP、MC 和 TD 分别用什么来更新估值
- DP:知道环境模型,对后继情况求期望,也使用后继价值进行 bootstrap。
- MC:不要求模型,使用完整采样回报,不 bootstrap。
- TD:不要求模型,使用采样转移与后继估值,进行 bootstrap。
关键区别是“采样还是对模型求期望”“是否 bootstrap”,不是有没有神经网络。
3.5.7 TD(λ) 前向视角:混合不同步数的回报
一步 TD 很依赖对下一状态的估值,MC 则要等到一局结束。两者之间还有一种办法:先实际走 步,再用价值估计补上剩余部分。下面先讨论固定策略下的状态价值预测,不把 on-policy 的结论直接套到 off-policy Q-Learning。
设同一局在 真正终止,,计算本轮目标时价值快照 固定,且 。 步回报是:
例如:
中间奖励也要逐项折扣。将各个长度的回报加权,有限 episode 的 λ-return 定义为:
最后一项接收尚未分配完的全部权重;权重之和为 。当只剩一步时求和为空,唯一目标就是 。
- :只保留一步 TD 目标。
- :只保留直到真正终止的完整回报,即有限 episodic 情况下的 MC 目标,不是对所有 n-step 回报等权平均。
- :在不同 bootstrap 长度间折中。
持续任务在级数收敛、 等条件下可以写作 ; 不满足这个无限级数表达式的适用条件,应使用前面的有限 episode 定义讨论 MC。
相关推导参见:Sutton 与 Barto 教材。λ 调整的是不同长度回报的混合方式,不应只解释成“未来越远,影响一定越小”。
3.5.8 TD(λ) 后向视角:用新误差更新之前的状态
前向视角(forward view)从当前位置往后看,把未来几步的回报组合起来。后向视角(backward view)反过来:每当新的 TD error 到来,就把它分配给之前访问过的状态。Eligibility trace(资格迹)记录每个状态还应该分到多少更新。
表格型 accumulating trace 初始化 ,每步先更新 trace,再更新所有状态:
所有状态使用同一个当前 ,但乘各自的 trace。最近访问会增加 trace,久未访问会衰减;同一个状态重复出现可以累积贡献,所以不能简单用“出现次数少”代替“离当前时间远”。完成终止转移的更新后,在新 episode 开始前清零 trace。
例如 ,连续访问 A、B 两个不同状态。第一步 trace 为 ;第二步为 。若第二步 、,本次会给 A 增加 ,给 B 增加 。A 虽不是当前状态,仍因它通向这次结果而得到更新。式中的 是指示函数:条件成立取 1,否则取 0。
Replacing trace 对当前访问状态将 trace 设为 ,其他状态继续衰减。Dutch trace 是另一种带步长/特征修正的 trace,不能仅称为“衰减后加一”,那正是 accumulating trace 的基本形式。
相关推导参见:Sutton 与 Barto 教材。这里写的是 on-policy 状态价值预测;off-policy trace 往往还需校正或截断,不能原样替换成任意 Q-Learning。
3.5.9 前向和后向更新什么时候相同
先固定整局内用于算目标和 TD error 的价值函数 。在未终止的中间步骤写 ,终点取 。连续相加时,中间价值项会抵消:
以 展开就能看见抵消过程:。正负的 消掉后,留下两步奖励、末尾 bootstrap 和负的起点估值。
将其代入有限 λ-return, 所对应的剩余混合权重为 ,因而:
而 accumulating trace 展开为 。若整局计算期间固定 、固定步长 ,最后统一应用累积更新,则交换有限求和次序得到:
因此,在 offline、固定估值、accumulating trace 的表格型更新条件下,两种视角会得到相同的累计更新。此处 offline 指延迟到 episode 结束应用更新,与“固定历史数据集上的 offline RL”不是同一个分类问题。
当 ,同样的抵消给出 ,所以在这些条件下对应 every-visit MC 的累计更新。当 ,两种视角都退化为一步 TD;但 online 与整局延迟更新使用的数值可能不同,不能据此说两种更新时机结果永远一样。
普通 online TD(λ) 每一步都会改变 ,不同时间的 TD error 不再来自同一份快照,上述证明不能直接沿用。Harm van Seijen 与 Richard S. Sutton 的 True Online TD(λ),ICML 2014,PMLR 32(1):692–700 给出了包含估值变化的新 online forward view,并用 Dutch traces 和修正更新精确实现它。该结果涵盖表格/线性函数近似;这一等价结论不能直接推广到任意深度网络上的普通 TD(λ)。
3.5.10 从 TD error 到 GAE
回到 Actor–Critic,这里要估计的是动作比平均选择好多少,不需要重新定义价值函数。
采样来自当前评估策略 ,若 ,则条件期望满足:
因此,单步 TD error 就可以用来估计 advantage;如果 Critic 是近似的,这个估计会有误差。多看几步,就得到第 3.5.9 节中的 。把不同步数的估计按 λ 加权混合,就是 Generalized Advantage Estimation,简称 GAE:
这里使用同一份 Critic 快照、同一局完整数据,终点是真正终止状态。
对照LLM 对齐篇的 token 级 GAE时,状态对应问题和已经生成的前缀,动作对应下一个 token。那篇把首个 token 编为 、最后一个编为 ,这里则从 到 ;终止后的位置分别是 和 。两篇递推公式相同,只是对齐篇的例子取 ,所以没有写出 。
- :,只用一步信息。
- :完整有限 episode 中 ,没有尾部 bootstrap。即使 baseline 不精确,只要满足动作独立及停止梯度等条件,它仍可用于无偏的策略梯度估计;但其逐状态动作的期望不一定等于真实 。
- 中间值通常在方差与 Critic 误差引起的偏差间折中;不是 λ 越大或越小就一定更好。
为了计算高效,通常从后往前递推:
真正终止与采样截断要分开处理。 若环境任务仍在继续,只是 rollout 在 处截断,应保留 的 bootstrap;此时即使 ,结果也是 ,不等于完整 MC 回报。若时间上限本身就是任务定义的有限终点,则按真正终止处理,并把剩余时间纳入状态。
实践中可分开记录两个 mask: 表示下一状态的价值是否应保留, 表示下一条已存储 advantage 是否仍属于当前连续片段:
真正终止时 ;被外部截断并 reset 时 ;片段内部通常均为 。最后一条采样的递推尾值设零,但仍按 决定是否保留 value bootstrap。使用环境自动 reset 时,应取 reset 之前的最终 observation 计算这个 bootstrap,不能误用新一局初始状态。
例如奖励 、价值快照 ,第三步真正终止,、。TD errors 是 ,从后往前得到 advantages 。取 时变为 ,等于折扣 MC 回报减 baseline。
4. GAE 与 Double DQN 的 Python 算例
下面的 Python 只需要标准库,展示单条连续 rollout 的 GAE 和 Double DQN 标量目标。输入使用已经固定、停止梯度后的数值;若要接入训练器,还需补上环境采样、网络前向和参数更新。
import math
def gae(rewards, values, terminated, gamma=0.9, lam=0.8): """One continuous rollout; values includes the final observation's value.
An external cutoff is not termination. If the last transition merely truncates collection, pass terminated[-1] = False and bootstrap values[-1]. Internal true terminations are rejected. Split at every reset, including external truncation/reset; this function cannot infer such boundaries. """ n = len(rewards) if n == 0 or len(values) != n + 1 or len(terminated) != n: raise ValueError("expected n rewards, n+1 values, n termination flags") if not (0 <= gamma <= 1 and 0 <= lam <= 1): raise ValueError("gamma and lambda must lie in [0, 1]") if not all(type(flag) is bool for flag in terminated): raise ValueError("termination flags must be boolean") if any(terminated[:-1]): raise ValueError("split rollouts at terminal transitions") if not all(math.isfinite(x) for x in [*rewards, *values]): raise ValueError("rewards and values must be finite") advantages = [0.0] * n tail = 0.0 for t in reversed(range(n)): bootstrap = 0.0 if terminated[t] else values[t + 1] delta = rewards[t] + gamma * bootstrap - values[t] continuation = 0.0 if terminated[t] else tail tail = delta + gamma * lam * continuation advantages[t] = tail return advantages
def double_dqn_target(reward, online_next, target_next, terminated, gamma=0.9): if not online_next or len(online_next) != len(target_next): raise ValueError("Q vectors must be nonempty and have equal lengths") if not 0 <= gamma <= 1 or type(terminated) is not bool: raise ValueError("invalid gamma or termination flag") if not all(math.isfinite(x) for x in [reward, *online_next, *target_next]): raise ValueError("reward and Q values must be finite") if terminated: return float(reward) action = max(range(len(online_next)), key=online_next.__getitem__) return reward + gamma * target_next[action]
advantages = gae([1, 2, 3], [0.5, 1, 1.5, 0], [False, False, True])print([round(x, 4) for x in advantages]) # [3.8696, 3.43, 1.5]print(double_dqn_target(1, [5, 4], [3, 6], False)) # 3.7GAE 估计一个动作比平均表现好多少,PPO-Clip 用这个估计调整动作概率;DQN/Double DQN 则先学习动作价值,再据此选动作。写训练代码时,先分清自己在更新策略还是价值,再检查目标怎么算、样本由哪个策略采集。
参考资料
- David Silver — UCL Course on Reinforcement Learning
- Sutton 与 Barto — Reinforcement Learning: An Introduction,教材 PDF
- Schulman et al. — Proximal Policy Optimization Algorithms,2017
- Schulman et al. — High-Dimensional Continuous Control Using Generalized Advantage Estimation,ICLR 2016
- van Hasselt, Guez 与 Silver — Deep Reinforcement Learning with Double Q-learning,AAAI 2016
- van Seijen 与 Sutton — True Online TD(λ),ICML 2014,PMLR 32(1):692–700
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。