0. 接着看不同人群的处理效应
上一篇从潜在结果出发,介绍了个体和平均处理效应。这一篇继续看:如果只关心参加辅导的人,或者基础成绩相近的一组人,应该计算哪一种效应?
下面的定义和假设主要参考 A Survey on Causal Inference。
NOTE这是初学者的个人笔记,内容和理解难免有误,欢迎指正。
1. 先定义要比较谁,再看怎么计算
本篇沿用第一篇的潜在结果框架,把处理符号 改记为综述中的 。需要条件概率和期望的基础。主要用课程辅导作例子:某位学生是否参加课程辅导( 参加, 不参加), 是之后的考试分数, 是辅导开始前的基础成绩。处理效应描述的是同一个人在两种方案下的结果差,而不同指标会对不同人群取平均。因此,先弄清楚指标比较的是哪些人,再看数据是否足够算出它。
1.1 从一个人的结果,到一群人的平均效应
定义 1:研究单元(Unit)。 研究单元就是我们安排处理、记录结果的对象。在辅导例子里,一个学生就是一个研究单元。
研究单元可以是一位患者或一个人,也可以是一组人,例如一个班级或一个市场中的人群。具体取决于研究怎样定义处理对象。
定义 2:处理(Treatment)。 处理就是我们要比较的行动或条件,例如参加辅导和不参加辅导。
假设给某个病人开药,“开 A 药”和“开 B 药”分别是一种处理。令 W (W {0, 1, 2, … , N_w }) 表示处理类别,这里 是处理的个数。
定义 3:潜在结果(Potential outcome)。 对每个研究单元和每一种处理,都可以定义“这个单元接受该处理时会得到的结果”,即相应的潜在结果。
处理 对应的潜在结果记为
指同一个体 在指定处理 下的结果。这里括号表示处理方案,不是条件概率事件; 对实际未处理的人也有定义。不同处理对应的潜在结果也可能具有相同的数值。
定义 4:观测结果(Observed outcome)。 观测结果是研究单元实际接受的处理所对应的结果。
观测结果有时也称为 factual outcome(事实结果),用 表示,其中 F 指 factual。
对某位已经考完试的学生,观测结果就是表中记下的成绩。换到总体来看,不同学生的成绩仍然可以用随机变量描述。
NOTE观测结果()和潜在结果()的关系是:当研究单元实际接受处理 时,在一致性假设下都有 。二元处理时也可写成 :当 只留下第一项,当 只留下第二项。
定义 5:反事实结果(Counterfactual outcome)。 如果研究单元接受另一种处理,它会得到的结果称为反事实结果。
反事实结果对应实际接受的处理 之外的其他处理,是那些处理下的潜在结果。
在同一个研究时点和相同初始条件下,一个研究单元只能实际接受一种处理,也只能观察那一列潜在结果。之后让同一个人改用另一处理,时间、状态或前次处理的影响也可能改变,因此通常不能直接当作原时点缺失的那个反事实。
把“实际看到的结果”和“缺失的另一种结果”放在同一张图里,更容易区分个体效应与组间差异:
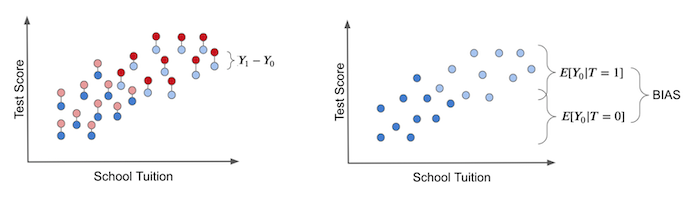
这张原图另用“学校是否提供平板电脑”作示意,横轴是学费,纵轴是考试表现,不是下文辅导四人表的数据。图中 对应本文的 , 对应 。
- 左图:深色点表示观测结果,浅色点补出无法同时观测的反事实;同一横坐标的一对点,纵向差才是同一单元的处理效应。
- 右图:把两组都放到“不处理”的 状态,两组平均值仍可不同。这个差异是选择偏差,不能算作处理带来的收益。
- 因此 ATE 与 ATT 都先问“同一人的两种结果差多少”,再决定平均哪些人;都不能只把两组深色点的平均值直接相减。
图源:Matheus Facure,Causal Inference for the Brave and True,第 1 章 Bias,MIT 许可。原图保留,未替换数据或坐标。
定义 6:处理前变量(Pre-treatment variables)。 处理前变量不会受到本次研究中的处理影响。
处理前变量也称为 background variables(背景变量),通常用 表示。它们不受本次处理影响,但可能影响谁接受处理。比如,某个人的性别不受“发广告”这一处理的影响,但性别可能影响广告是否下发。
定义 7:处理后变量(Post-treatment variables)。 处理后变量会受到本次研究中的处理影响。
在这里,处理后变量指会受处理影响的变量。比如,某个人打开软件的次数会受“发广告”这一处理影响。
定义 8:个体处理效应(Individual Treatment Effect,ITE)。
对于个体 i,其 ITE 的计算公式为:
其中, 和 分别是个体 接受处理和不接受处理时的潜在结果。
定义 9:平均处理效应(Average Treatment Effect,ATE)。
ATE 对目标总体中所有个体的处理效应取平均,计算公式为:
这里的期望是对目标总体中的人取平均,而不是只对实际实验组或对照组求平均。对于有限的 个个体,可以写成 。这个式子说明了 ATE 的含义,但真实数据里缺少反事实结果,因此不能直接照着公式逐人相减。
定义 10:已处理人群的平均处理效应(Average Treatment effect on the Treated group,ATT)。
ATT 只关注实际接受处理的人。问题是“这些已接受辅导的人,相比他们自己没接受辅导时平均提高多少”,计算公式为:
注意第二项仍以 为条件:它是接受辅导者假如没有辅导的平均成绩,不是直接拿未辅导组的成绩代替。两组原本基础不同的话,直接相减会混入选择差异。
定义 11:条件平均处理效应(Conditional Average Treatment Effect,CATE)。
CATE 对满足条件 X = x 的子人群求平均处理效应,计算公式为:
NOTECATE 用于比较不同背景条件下的平均处理效应,因而也用于描述异质处理效应(heterogeneous treatment effect)。
下面的假设数据为每个人列出了两种潜在结果,便于比较这几个定义。在真实数据中,每人只能观测其中一列:
| 个体 | 基础组 | 实际 | 个体效应 | ||
|---|---|---|---|---|---|
| 甲 | 低 | 1 | 50 | 70 | 20 |
| 乙 | 低 | 0 | 60 | 70 | 10 |
| 丙 | 高 | 1 | 80 | 84 | 4 |
| 丁 | 高 | 0 | 90 | 92 | 2 |
以四人各占四分之一为目标人群,ATE 为 ,实际处理者甲、丙的 ATT 为 ;低基础组 CATE 为 ,高基础组为 。实际观察组均值差却是 ,与上述效应不同。ATE、ATT、CATE 的区别在于对哪些人加权平均,并没有改变“每个人的两个潜在结果之差”这个起点。
例如低基础组里,甲、乙的个体效应分别是 20、10,因此 CATE 是 。但现实中不能直接看到甲的 和乙的 :一人参加了辅导,另一人没有。这张表里的两列完整潜在结果是为了说明定义,不是说从观察成绩就能算出每个人的效应。如何在假设下从观测数据识别平均效应,上一篇的调整公式已有推导,下面沿用同样的思路,进一步区分 ATE、ATT 和 CATE 的目标人群。
1.2 什么条件下,观测数据能回答因果问题
要用实际成绩估计辅导的效果,需要下面这些假设。术语沿用综述,但可以结合辅导例子理解。
假设 1:稳定单元处理值假设(Stable Unit Treatment Value Assumption,SUTVA)。 这个假设包括无干扰和无隐藏处理版本两部分:
- 一个个体的潜在结果不受其他个体接受何种处理的影响,即无干扰。这与“不同个体的观测数据在统计上独立”是不同的要求。
- 对同一个人,记为同一处理的方案不能包含会导致不同结果的隐藏版本。也就是说,研究需要先说清“参加辅导”具体指什么。
假设 2:可忽略性(Ignorability)。 处理分配 与潜在结果独立,即 。
可忽略性可以从以下两方面理解:
潜在结果与实际接受的处理在总体中独立。随机分配是一种支持该假设的研究设计;但即使假设成立,也不能反推出研究采用了随机分配。
这种独立性称为可交换性:对同一种处理,两组中相应潜在结果的总体分布相同,并不要求每个人的其他条件完全相同。
在辅导例子中,基础较弱的学生可能更愿意参加辅导,基础成绩又会影响两种情况下的期末成绩,于是处理分配与潜在结果并不独立。我们可以考虑较弱的条件假设:
它表示:在基础条件 相同的人群中,是否参加辅导与两种情况下的潜在成绩独立。如果漏掉了学习动机,而它同时影响报名和成绩,这个假设就可能不成立。写下 表示按这些背景变量分层;条件可交换性是否成立,仍取决于所选的 是否已包含足够的混杂因素。
假设 3:正值性(Positivity,也称重叠)与一致性。 对目标人群中出现的 ,要求 ,让每层都能比较两种处理。若低基础学生全都参加辅导,就没有该层的未辅导观察值;用模型猜出该层未辅导者的成绩,需要额外的外推假设,不能补上原有数据缺少对照的问题。一致性还要求实际接受的方案与所定义的处理一致,才有 。例如“一次答疑”和“整学期一对一辅导”若都混记为 ,就需要重新定义处理版本。
1.3 用观测均值计算 ATE、ATT 和 CATE
ATE、ATT 和 CATE 都是用潜在结果定义的。要从数据中计算它们,需要利用上述假设,将潜在结果的均值表示成可观测的组内均值。固定 后,有:
因此令 ,两种处理在同一层的均值差为 。在上述假设及所需重叠条件下:
ATE 按整个人群的 分布加权,ATT 按实际处理者的 分布加权。比如低、高基础组的效应分别为 15、3 分,全体两组各半,ATE 为 9 分;若实际辅导者中 80% 属于低基础组,则 ATT 为 分。这里改变了实际辅导者的基础构成,所以 ATT 与前面四人表中的 12 分不同。
面对真实数据,还需要估计 ,例如按层计算样本均值或拟合结果模型,并评估不确定性。这些假设让我们能够计算平均效应,却不能找回每个人缺失的潜在结果。CATE 是组内平均值,同一组里每个人的 ITE 仍可能不同。
参考资料
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。