0. 适合谁看,怎么读
这份阅读路线适合会写一些 Python、刚开始学习大模型的读者。文章按理解概念需要的顺序排列,而不是按发布日期排序:从文本编码和下一个 token 预测开始,再看训练和微调,最后了解推理的显存开销。公式较多的推导可以留到第二遍阅读。
- 系统入门:按下面的 9 步阅读,所需基础不包括分布式训练或强化学习
- 查找具体问题:在专题表格里找到对应文章,各篇会介绍所需概念,并附上详细推导的延伸链接
- 想看其他领域:全站主题目录收录全部文章,其中也包括因果推断、分类指标和服务推荐
运行示例前,先查看对应文章的依赖版本与适用条件。显存算例用于估算容量,真实峰值还取决于具体实现和运行配置。
1. 入门路线:文本生成、显存与微调
先看本路线前半段要解释的现象:一个模型怎样把已有 token 接着写下去。下面是 Jay Alammar 的 GPT-2 原始动画,它展示生成中的一步,不是本文 9 步阅读顺序的流程图。
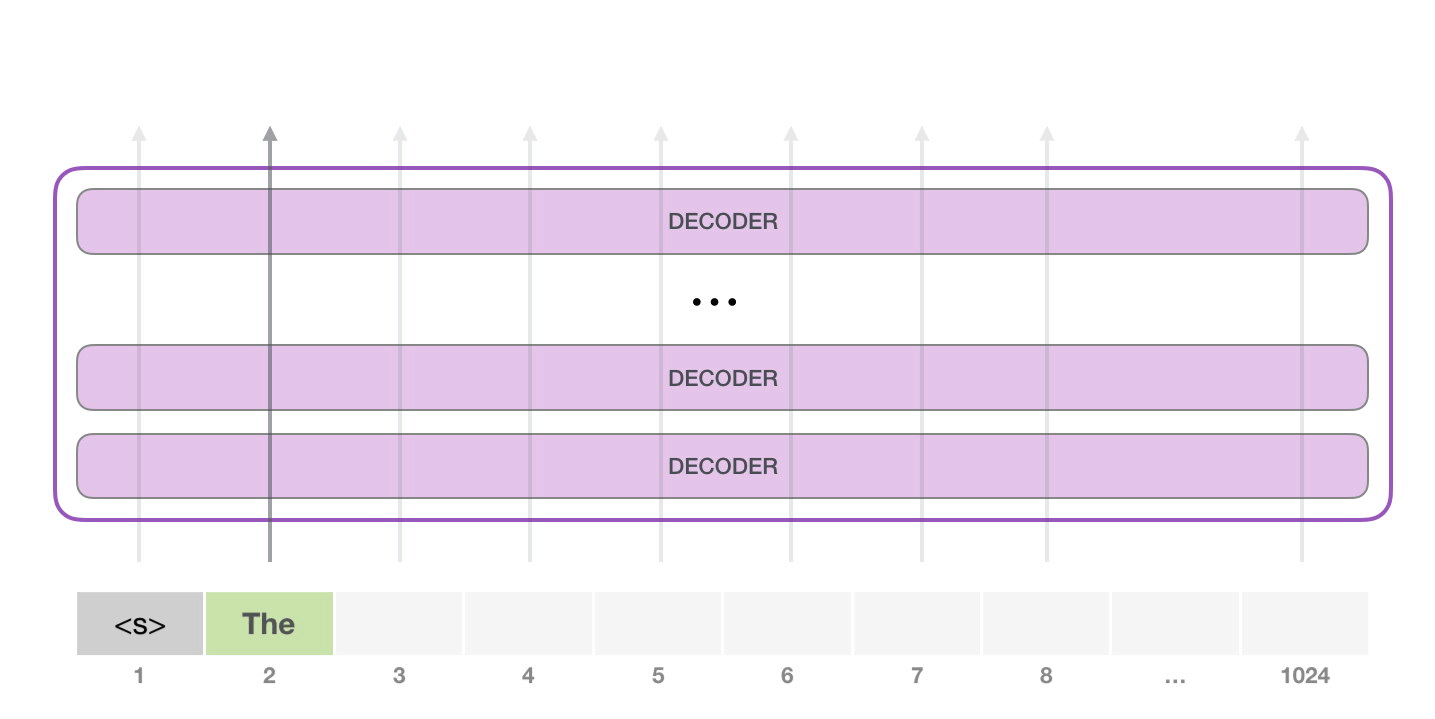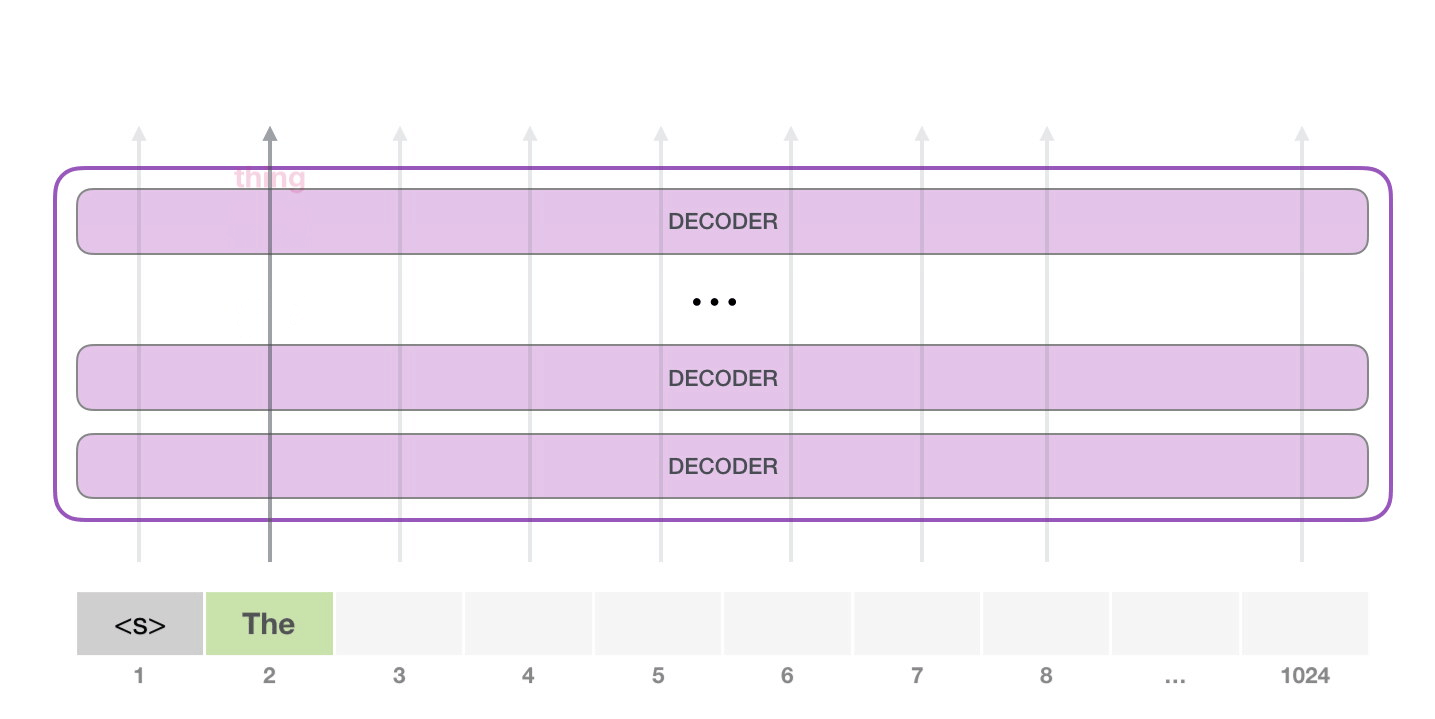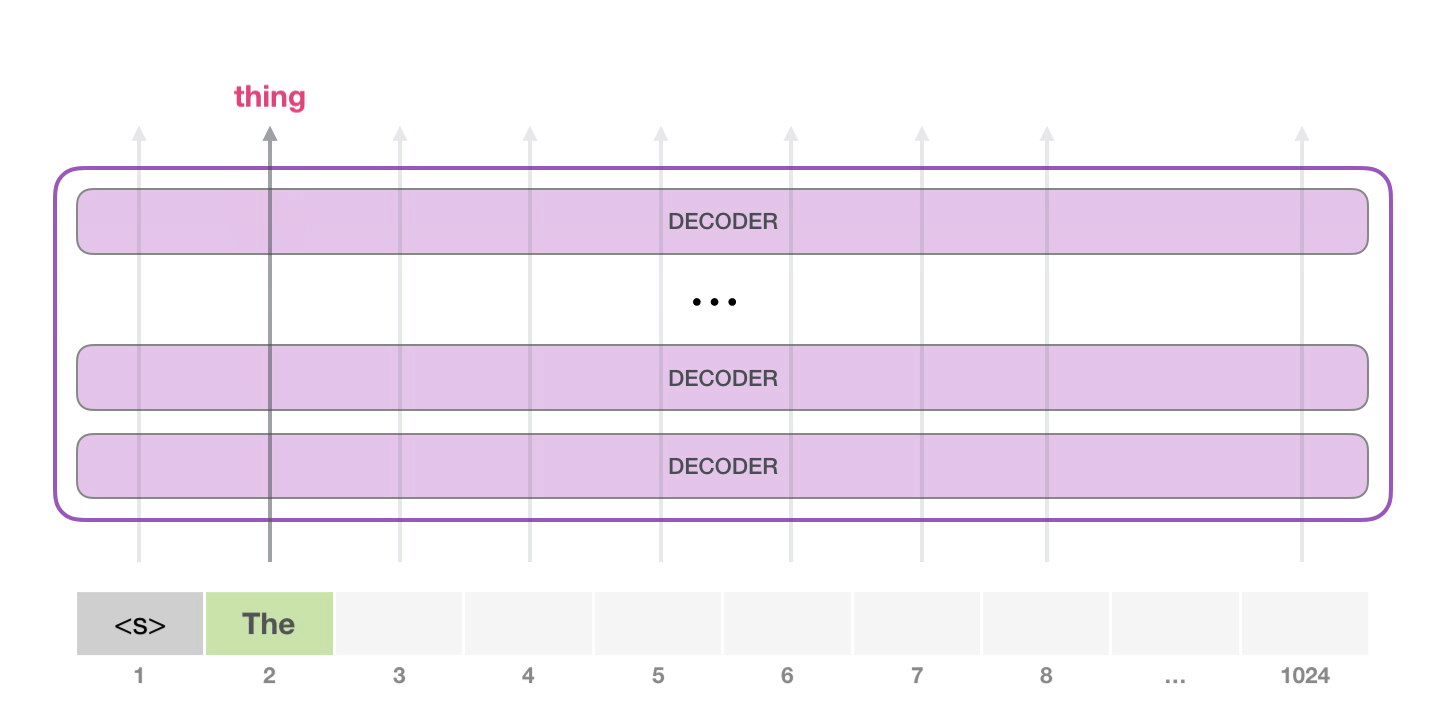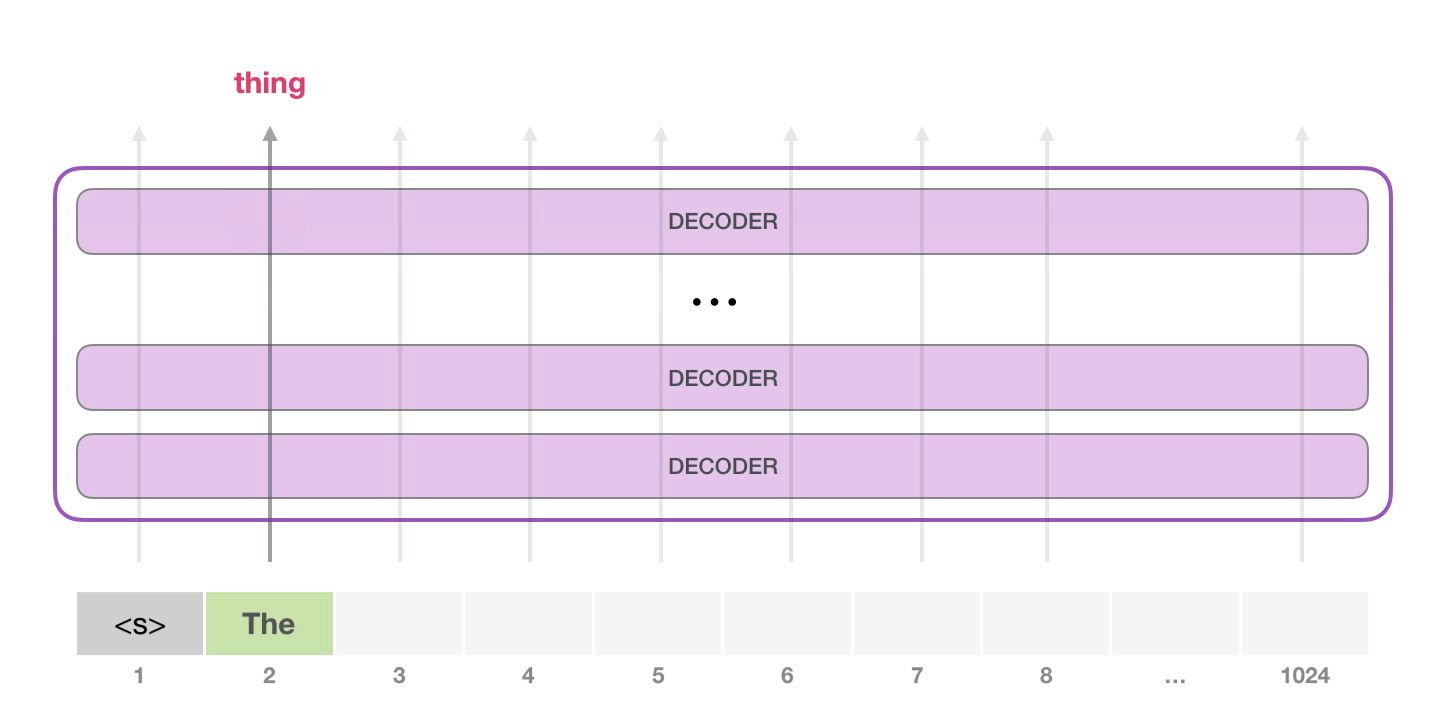
来源:Jay Alammar,The Illustrated GPT-2;动画原样保留,CC BY-NC-SA 4.0。
- 底部文字和编号:对应第 1 步的 token 表示;图中的 1024 是 GPT-2 的上下文长度示例,不是所有模型的上限。
- 中间紫色 Decoder 层与向上的路径:对应第 3 步的模型计算,第 4 步再研究位置信息;GPT-2 本身并不使用 RoPE。
- 顶部预测和下一次输入:第 2 步解释预测概率怎样评分,第 5 步解释怎样从概率选出 token;第 6—9 步再问,这些计算需要多少显存、怎样继续训练。
| 步骤 | 文章 | 这篇讲什么 |
|---|---|---|
| 1 | Tokenization:从文字到 token | 字符、子词与词表;BPE、WordPiece、Unigram 和 SentencePiece 的关系 |
| 2 | Perplexity:语言模型怎样评分 | 条件概率、交叉熵、PPL,以及比较模型时需要统一的评测条件 |
| 3 | Transformer Decoder:从零生成文本 | Q/K/V、causal mask、label shift、最小训练和生成代码 |
| 4 | RoPE:旋转位置编码 | 位置怎样进入 Q/K 内积;需要矩阵和三角函数基础 |
| 5 | Decoding:怎样选下一个 token | Greedy、Temperature、Top-K、Top-P 与 Beam Search |
| 6 | 显存基础:单位、精度与各类数据的占用 | 哪些张量长期保留,哪些只在某个阶段存在 |
| 7 | 量化入门:scale、zero-point 与误差 | 降低存储位数带来的近似误差;后半 GPTQ/AWQ 为数学选读 |
| 8 | SFT:数据与显存优化实战 | 示范答案如何构成训练目标;检查哪些 token 属于同一样本、LoRA 微调和样本打包(packing) |
| 9 | 推理显存:完整算例与 OOM 排查 | 权重、注意力结构、历史缓存与临时工作区;跟着算例核对容量 |
这 9 步可以分成两段:前 5 步帮助我们理解文本怎样生成;第 6—9 步先介绍显存占用与量化,再讲怎样用示范问答继续训练模型(监督微调),最后看训练完成后怎样推理。想先动手写一个最小模型,可以在第 3 步动手。RoPE 的复数推导和量化的 GPTQ/AWQ 推导可以留到第二遍;第一遍先理解旋转怎样表达位置、量化怎样用整数近似小数。单卡 SFT 不要求先学 ZeRO。
读完一篇后,可以对照表格最后一列检查理解。如果公式中的某个符号还不熟悉,文章里的数值例子可以帮助确认它的含义和计算方式。
大模型显存子系列:从模型保存的数据到节省显存的方法
这 5 篇回答一个连续的问题:先看模型运行时要存哪些数据,再讨论训练时多卡怎样分担状态、微调时怎样节省显存,随后进入训练完成后的推理过程,最后深入注意力计算的临时张量。可以从显存系列目录随时返回各篇。
| 篇次 | 文章 | 与前文的关系与阅读建议 |
|---|---|---|
| 一 | 模型运行时要存什么 | 认识权重、梯度、优化器状态、激活和缓存,学习怎样计算大小;也是入门路线第 6 步 |
| 二 | ZeRO 如何分摊训练显存 | 先看训练时需要保存的状态,再讨论多卡分片与通信;多卡选读 |
| 三 | 微调时怎样节省显存 | 将训练中的显存问题应用到微调,选择 LoRA/QLoRA、激活检查点和梯度累积;对应入门路线第 8 步 |
| 四 | 从 Prefill、Decode 到 KV Cache | 微调完成后进入推理,区分不再保存的训练状态与新增的历史 K/V,计算权重和 KV 占用;对应入门路线第 9 步 |
| 五 | FlashAttention 为什么能省显存 | 进一步追踪注意力中间矩阵、分块与在线 softmax;深入选读 |
显存系列按训练、微调、推理的顺序组织,但不要求先掌握所有多卡技术。第一遍可以按上面的 9 步入门路线走:读完第一篇后,先看独立量化专题里的整数编码与误差基础,为 QLoRA 做准备;再读第三篇微调和第四篇推理。
只做单卡 SFT,可以先跳过第二篇 ZeRO;需要多卡训练时,再补读它和 AdamW。第五篇 FlashAttention 可以留作深入阅读。量化专题中的 GPTQ/AWQ 部分也可以在了解推理后回读,不另写成一篇系列文章。
2. 想继续深入,可以按问题选专题
| 问题 | 对应文章 | 所需基础 |
|---|---|---|
| RoPE 怎样扩展到更长文本? | 长上下文:PI、NTK-aware 与 YaRN | RoPE 的频率和旋转 |
| AdamW 的权重衰减和 L2 是否一样? | AdamW:更新规则与状态 | 梯度、L1/L2 基础 |
| 注意力中间矩阵为什么占显存,怎样避免完整保存? | FlashAttention:分块与在线 softmax | 推理显存、Q/K/V 与 softmax |
| 多张卡怎样分担训练状态? | 训练显存与 ZeRO | 显存基础、Adam/AdamW |
| SFT 后怎样学习人类偏好? | LLM 对齐:RLHF、PPO 与 DPO | SFT、KL;PPO 部分再补通用 RL |
推理篇先解释权重和缓存,再计算容量;FlashAttention 的分块计算与在线 softmax 已拆成独立的显存系列第五篇,属于深入选读。量化篇前半讲整数刻度和误差,后半再讲 GPTQ/AWQ 如何降低误差。如果当前目标是估算部署容量,前半部分的算例可以作为起点。
3. 补数学基础,或动手搭应用
| 文章 | 主要内容 |
|---|---|
| KL 散度 | 比较分布;熵、交叉熵、支撑集和高斯 KL |
| 采样方法 | 逆变换与拒绝采样;LLM 候选分布的选择另见 Decoding |
| L1/L2 正则化 | 统计、几何、先验和稀疏性;优化器差异另见 AdamW |
| 通用深度强化学习 | MDP、Policy Gradient、GAE、PPO 与 Q-learning;token 级对齐另见对齐专题 |
| LLM 应用:Prompt、RAG、Tools 与 Agent | 用 LangChain 搭应用;检索向量怎样用、怎样调用工具、哪些步骤交给 agent |
| Hermes Agent:WSL 部署与排错 | 运行环境、终端、系统服务和网关;按消息从入口到模型的路径排错 |
搭建应用不需要先读完整条模型训练路线。先看应用概念,再按实际需要查看部署案例;使用框架 API 和系统命令时,需要核对文章注明的适用版本。
4. 哪些内容已经讲过,哪些还没讲
下面按领域整理已有内容,方便查找专题。初次阅读可以跳过这一节,遇到相关术语时再回来查看。“简单介绍过”表示现有文章只讲了其中一部分;“还没单独讲”表示目前没有完整专题,也没有确定的发布时间。
一、文本怎样变成模型输入
已经讲过:分词算法与词表。简单介绍过:token ID、embedding 查表、特殊 token 与对话模板。
还没单独讲:embedding 训练专题、完整 EOS/SEP/MASK 设计、ALiBi 与其他位置表示比较。
二、模型由哪些部分组成
已经讲过:最小 Decoder、Q/K/V、causal/padding mask、RoPE。简单介绍过:MHA、GQA/MQA、FFN、LayerNorm 与残差在模型中的位置。
还没单独讲:不同归一化方法和激活函数的详细比较、Cross-Attention、MLA、Sliding Window、MoE 的 router/负载均衡/专家容量,以及 Dense 与 MoE 选型。
三、模型怎样生成文本
已经讲过:解码策略、KV 怎样复用、占多少显存、FlashAttention 前向、量化。简单介绍过:分页缓存、前缀共享和 Chunked Prefill;Chunked Prefill 不保证首 token 延迟(TTFT)下降,请求调度也会影响后续 token 的生成延迟和吞吐量。
还没单独讲:Repetition Penalty、FlashAttention 反向与完整 GPU kernel、Speculative Decoding、PD 分离、Continuous Batching、SplitFuse、Ring/Distributed Attention,以及格式与后端部署比较。
四、怎样训练模型
已经讲过:数值精度、AdamW、SFT 的样本划分与 loss、激活优化。简单介绍过:mixed precision、梯度累积、学习率和裁剪配置。
还没单独讲:完整 Loss Scaling、FP8 训练、学习率调度比较、8-bit Adam、数据吞吐与分布式采样、profiler 和通信重叠专题。
五、多张 GPU 怎样一起训练
已经讲过:指定训练配置下的 ZeRO-1/2/3 分片与通信量计算。简单介绍过:DDP、集合通信操作分别做什么、offload 与 FSDP 关系。
还没单独讲:TP、PP、EP、SP 的详细实现,以及怎样组合使用,NCCL/通信拓扑、完整多机启动和容错。现有算例用于解释容量与通信量,不提供 H100 性能实测。
六、微调与对齐
已经讲过:SFT、LoRA/QLoRA 基础、奖励模型、KL 正则、token 级 PPO、DPO。简单介绍过:在线 RL 与工具兼容性提示。
还没单独讲:Prefix/Prompt Tuning、完整 GRPO 训练与推导、ORPO、KTO(Kahneman–Tversky Optimization)、蒸馏与系统性的对齐评测。
七、数学基础与模型评估
已经讲过:PPL、KL、采样、L1/L2、通用 RL。分类校准和 AUC/GAUC 收录在全站数学与模型基础目录中;这些分类指标不能替代语言生成质量评价。
还没单独讲:完整 benchmark 设计、污染检查、LLM-as-a-judge 的偏差控制、事实性与安全性的系统评价。
八、工具、框架和部署
已经讲过:应用中各个组件的作用与 WSL 部署案例。简单介绍过:TRL、DeepSpeed、PEFT 等工具在具体文章中的用法,示例仅适用于各篇注明的版本。
还没单独讲:完整 serving 平台、系统性的 RAG 检索评测(指标、数据集与对照实验)、实际部署 agent 时怎样检查权限、记录和排查运行问题,以及撤销错误操作。
读完就做一个小实验
可以从一个小实验开始:运行 Decoder 的最小示例、估算自己的模型需要多少显存,或检查一条 SFT 样本的标签。实验中遇到不熟悉的概念时,再查看对应文章,不必等读完所有专题才动手。
上述许可适用于本站原创内容;引用的图片、代码等第三方素材,以各自注明的许可为准。